时地方
This commit is contained in:
 coco
@@ -0,0 +1,126 @@
|
||||
---
|
||||
title: "Anthropic 产品发布为什么快到离谱"
|
||||
source: "https://x.com/SaitoWu/status/2047487575120892146"
|
||||
author:
|
||||
- "[[@SaitoWu]]"
|
||||
published: 2026-04-24
|
||||
created: 2026-04-24
|
||||
description: "刚听完 Lenny 播客里 Cat Wu(负责 Claude Code 与 Cowork 的产品负责人)的那期对话,有点被震住。Anthropic 现在的节奏几乎是每天都有重要功能上线。过去需要半年才能推出的能力,现在一周,甚至一天就能交到用户手里。但真正反直觉的点在这里:他们的..."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||

|
||||
|
||||
刚听完 Lenny 播客里 Cat Wu(负责 Claude Code 与 Cowork 的产品负责人)的那期对话,有点被震住。
|
||||
|
||||
Anthropic 现在的节奏几乎是每天都有重要功能上线。过去需要半年才能推出的能力,现在一周,甚至一天就能交到用户手里。
|
||||
|
||||
但真正反直觉的点在这里:他们的“快”,并不是因为模型更强,而是因为他们把所有阻碍 shipping 的东西都干掉了。
|
||||
|
||||
Cat 形容得很直接,整个组织已经把“快”变成了一种肌肉记忆。
|
||||
|
||||
她和 Boris 的分工也非常清晰。Boris 负责三到六个月后的 AGI 愿景,而她负责把从今天到那个未来之间的每一步路径铺平,同时把营销、销售、财务、算力全部对齐。
|
||||
|
||||
这不是某一个环节的优化,而是一整套系统在为“速度”服务。
|
||||
|
||||
最底层的变化,是时间尺度被彻底压缩。
|
||||
|
||||
传统产品开发习惯以半年到一年为周期做规划,但在模型能力飞速变化的环境下,这种方式已经完全失效。计划永远追不上现实。
|
||||
|
||||
Anthropic 的做法是把时间线压缩到“周”,甚至“天”。
|
||||
|
||||
他们大量使用 Research Preview 的模式。功能可以先上线,明确告诉用户这是实验版本,然后快速收集反馈,再在下一周完成迭代。
|
||||
|
||||
这样一来,内部决策成本大幅下降,用户也不会对不稳定性感到意外,反而更愿意参与反馈。
|
||||
|
||||
过去需要等半年才敢发布的功能,现在两周就能进入真实使用场景。
|
||||
|
||||
为了让这种速度成立,他们把流程压到了极低。
|
||||
|
||||
在 Anthropic,工程师有想法,可以在周末直接做出来并上线,而不是等待层层审批,也不需要写冗长的 PRD。
|
||||
|
||||
很多工程师已经可以从看到用户在 Twitter 上的反馈,到一周内完成上线,全流程几乎不需要 PM 介入。
|
||||
|
||||
PM 的角色也随之发生了变化,不再是做长期 roadmap 和跨团队协调,而是帮助团队把想法尽快转化为用户可以使用的产品。
|
||||
|
||||
他们甚至建立了一个类似“evergreen launch room”的机制。只要工程师认为功能准备好了,就可以直接提交进去,第二天文档、营销、DevRel 就会同步跟上,对外发布。
|
||||
|
||||
这种低流程能成立的前提,是极强的使命对齐。
|
||||
|
||||
Anthropic 有一个非常清晰的目标:安全地把 AGI 带给全人类。
|
||||
|
||||
这个使命不是挂在墙上的口号,而是实际决策的锚点。当优先级发生冲突时,团队会直接判断哪个选择更符合这个目标,然后快速达成一致。
|
||||
|
||||
Cat 甚至说,如果 Claude Code 失败了,但 Anthropic 整体成功,她完全可以接受。
|
||||
|
||||
这种对整体目标的认同,让团队愿意放下局部 KPI,从而极大提升决策速度和执行一致性。
|
||||
|
||||
另一个关键,是他们对“dogfooding”的极端投入。
|
||||
|
||||
整个团队都是 Claude Code 和 Cowork 的重度用户。
|
||||
|
||||
工程师用 Claude Code 写代码、做 review、跑测试。PM 用 Cowork 写文档、总结会议、生成 deck。
|
||||
|
||||
Cat 自己会刻意“折磨”模型,去理解它为什么出错,以及如何优化。
|
||||
|
||||
她提到一个细节。前一天晚上把会议资料、Slack、Gmail、Drive 全部输入 Cowork,第二天早上就能得到一份二十页、符合设计规范的演示文稿,只需要微调。
|
||||
|
||||
当一个团队把自己的产品用到这种程度时,他们不仅能榨干工具的潜力,也能第一时间感知用户真正的卡点。
|
||||
|
||||
随着工具能力提升,角色边界也在快速模糊。
|
||||
|
||||
工程师、PM、设计师之间的分工不再像过去那样清晰。
|
||||
|
||||
Anthropic 特别偏好那些拥有强 product taste 的工程师。因为当一个人既能判断做什么,又能直接实现,中间的沟通成本会大幅降低。
|
||||
|
||||
在代码越来越廉价的时代,真正稀缺的能力变成了“做什么”的判断力。
|
||||
|
||||
Cat 认为,一个好的 PM 应该能够定义一个月后的产品状态,从用户反馈中看出模型的边界,并迅速补齐。
|
||||
|
||||
当然,这一切建立在一种非常特殊的团队心态之上。
|
||||
|
||||
他们主动拥抱混乱。
|
||||
|
||||
优先级每天都在变化,P0 可以随时升级,但团队不会因此失控或焦虑。大家更关注把事情做好,快速学习、快速修正,然后休息好,第二天继续推进。
|
||||
|
||||
他们还把用户的正面反馈和负面反馈都公开在内部频道,让所有人看到真实声音。
|
||||
|
||||
如果不能接受这种环境,很容易在这样的节奏中耗尽精力。
|
||||
|
||||
从产品层面来看,他们的愿景也非常清晰。
|
||||
|
||||
第一阶段,是让单个任务稳定成功。
|
||||
|
||||
第二阶段,是同时运行多个任务。现在已经有用户一次并行处理多个任务。
|
||||
|
||||
第三阶段,是扩展到数百个任务并行执行,并具备自动验证与自我迭代能力。
|
||||
|
||||
在那个阶段,大部分执行会转移到云端完成。用户只需要查看结果并给出反馈。
|
||||
|
||||
围绕这个方向,他们已经在推进远程执行、任务调度、移动端控制等能力。
|
||||
|
||||
在对外问题上,Cat 的态度也很直接。
|
||||
|
||||
对于源代码泄露事件,他们承认是人为失误,在经过多层人工审核后仍然发生。团队第一时间补强了流程,没有推卸责任。
|
||||
|
||||
对于限制第三方工具的使用,则是出于算力压力的现实考虑。不同产品的使用模式差异很大,而计算资源依然昂贵,他们必须优先保障核心产品与 API 的稳定性。
|
||||
|
||||
这不是不愿开放,而是资源约束下的理性选择。
|
||||
|
||||
最后,她给出的建议非常具体。
|
||||
|
||||
看到任何重复的手动任务,都应该立刻尝试自动化。
|
||||
|
||||
自动化如果只做到九成,其实还不够,必须尽可能推进到完全自动执行。
|
||||
|
||||
不要只做 demo,而是要做自己每天都会用的真实工具,这样才能真正获得效率杠杆。
|
||||
|
||||
在这个时代,最有价值的能力,是 product taste,是判断什么值得做,并把体验打磨到极致。
|
||||
|
||||
同时保持低 ego,愿意承担多种角色,接受变化,保持节奏。
|
||||
|
||||
如果要用一句话总结 Anthropic 为什么这么快,其实很简单。
|
||||
|
||||
他们并不是靠某一个突破性的模型,而是把“减少摩擦”这件事做到极致,让组织中的每一个人,都可以以最高效率把想法变成现实。
|
||||
|
||||
**更多硬核科技播客:**[Podwise](https://podwise.ai/dashboard/episodes/7832330)
|
||||
@@ -0,0 +1,295 @@
|
||||
---
|
||||
title: "Cat Wu 面试了几百个 PM 候选人,几乎没人答对一个问题:AI 产品经理到底应该干什么?"
|
||||
source: "https://x.com/dotey/status/2047537778959778209"
|
||||
author:
|
||||
- "[[@dotey]]"
|
||||
published: 2026-04-24
|
||||
created: 2026-04-24
|
||||
description: "Cat Wu 是 Anthropic Claude Code 和 Cowork 的产品负责人,和 Boris Cherny 搭档,带着团队把产品功能的交付周期从半年压到了一天。在 Lenny's Podcast 最新一期中,Cat 聊了 Anthropic 内部的速度文化、PM ..."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||

|
||||
|
||||
Cat Wu 是 Anthropic Claude Code 和 Cowork 的产品负责人,和 Boris Cherny 搭档,带着团队**把产品功能的交付周期从半年压到了一天**。在 Lenny's Podcast 最新一期中,Cat 聊了 Anthropic 内部的速度文化、PM 角色的剧变、源代码泄露的善后,以及那个让开源社区炸锅的 OpenClaw 封堵决定。
|
||||
|
||||
原始视频:[https://www.youtube.com/watch?v=PplmzlgE0kg](https://www.youtube.com/watch?v=PplmzlgE0kg)
|
||||
|
||||

|
||||
|
||||
## 要点速览
|
||||
|
||||

|
||||
|
||||
- 大多数 PM 候选人仍然在用 **6-12 个月路线图**的思维找工作,Anthropic 的节奏是**一周甚至一天**发布一个功能
|
||||
- Claude Code 团队几乎所有 PM 都有工程背景或直接写代码,设计师也曾是前端工程师
|
||||
- Anthropic 用 **research preview 机制**降低发布承诺,让工程师可以端到端完成从想法到发布的全流程
|
||||
- Cat 花 **30% 的时间**故意把 Cowork 推到极限,和模型对话搞清楚它为什么犯错
|
||||
- Claude Code 源代码泄露经过两层人工审查仍然漏过,Cat 定性为**流程失败**
|
||||
- 封堵 OpenClaw 使用订阅配额的决定,Cat 从容量管理角度解释,但回避了“先复制功能再封堵”的争议
|
||||
- Anthropic 成功的核心:**统一使命**让团队愿意牺牲自己的 KR 去服务公司整体目标
|
||||
|
||||
## 1\. 与 Boris Cherny 搭档:80% 心灵感应,20% 各干各的
|
||||
|
||||

|
||||
|
||||
Lenny 开场就问 Cat 和 Boris 是怎么分工的。Boris 是 Claude Code 的创造者和技术负责人,在播客界已经是明星级人物,Lenny 说他的那期节目是播客史上最受欢迎的一集。
|
||||
|
||||
Cat 说自己和 Boris 的关系用 **“80% mind-meld”** 来形容。Boris 擅长的是方向感,他会说三个月后、六个月后产品应该长什么样,那个最 AGI pilled 的版本是什么。Cat 的角色则是**把这个愿景翻译成执行路径**:从现在到那个愿景之间,每一步怎么走?同时她花更多时间在跨职能协调上,确保市场、销售、财务、容量等团队都认同计划,不会在功能准备好之后才发现有障碍。
|
||||
|
||||
剩下的 20%,是各自特别在意的事情。Cat 会主导自己更关心的事,Boris 也一样,**谁更在意谁就推**。这种模糊分工在外面看起来不太正统,但 Cat 觉得正是因为模糊,才能快。
|
||||
|
||||
> **编者注:** Boris Cherny 是 Anthropic Claude Code 技术负责人,也是 O'Reilly 出版的《Programming TypeScript》一书的作者。他在 2024 年 9 月加入 Anthropic 后构建了 Claude Code 的第一个终端原型。AGI pilled 源自互联网俚语 red pilled(出自电影《黑客帝国》),指对 AGI 即将到来持极其乐观甚至狂热的态度。在 AI 行业内部,这个词既有正面含义(敢于为更强的模型设计产品),也有警告意味(可能脱离当下模型的实际能力)。
|
||||
|
||||
## 2\. 面试几百个 PM 后的发现:大多数人还活在旧世界
|
||||
|
||||

|
||||
|
||||
Lenny 提到一个有趣的现象:想去 Anthropic 当 PM 的人多到他快收到三十亿美元 ARR 的“介绍费”了。Cat 面试了几百人,她觉得**大多数人对 AI PM 角色的理解方向不对**。
|
||||
|
||||
问题出在哪?Cat 认为 AI 出现之前,技术变化很慢,你可以做 6-12 个月的规划。代码写起来很贵,所以 PM 的核心工作是协调各团队的路线图,确保大家的功能互相解锁。这套打法在旧世界是对的。
|
||||
|
||||
但现在,模型能力在快速提升,AI 大幅加速了工程效率,**很多产品功能的交付时间从 6 个月变成了 1 个月,有时候 1 周,甚至 1 天**。在这个节奏下,PM 不应该把精力花在多季度路线图的跨团队对齐上,而应该想:怎么找到最快的方式把东西推出去?怎么让工程师有个想法、周末就能送到用户手里?
|
||||
|
||||
> 最好的 AI 产品 PM,能缩短从“有这个想法”到“产品到了用户手里”的时间,并且能定义出产品必须在哪些任务上开箱即用。 (“The PMs who do the best on AI native products are the ones who can figure out: How can I shorten the time from having this idea to actually getting the product in the hands of users.”)
|
||||
|
||||
## 3\. 怎么做到一天出一个功能
|
||||
|
||||

|
||||
|
||||
Lenny 追问具体怎么做到这么快。Cat 讲了三件事。
|
||||
|
||||
**第一件是设定清晰目标。** 因为大语言模型能力太通用,用户是谁、解决什么问题、核心场景是什么,全都模糊。好的 PM 能把这些定死:我们的核心用户是企业里的专业开发者,这个功能要解决权限提示太多导致的疲劳感,目标是让企业开发者安全地做到零权限提示。这个目标一旦清楚,就排除掉了大量不相关的方案。
|
||||
|
||||
**第二件是 research preview 机制。** Claude Code 几乎所有功能都先以研究预览的形式发布。明确告诉用户:这是早期产品、只是一个想法、我们在收集反馈、这个功能可能不会永远支持。这降低了发布门槛,一两周就能把东西推出去。
|
||||
|
||||
**第三件是搭建跨职能的快速反应流水线。** Cat 的团队有一个叫 **“evergreen launch room”** 的机制。工程师觉得功能准备好了、内部也试用过了,就把它发到这个频道里。负责文档的 Sarah、负责产品市场营销的 Alex、开发者关系的同事会直接跳进来,第二天就能完成对外宣传。这套流程跑顺了之后,任何工程师想发布功能都没有摩擦。
|
||||
|
||||
Cat 说得很明确:**搭建这套发布流水线,就是 PM 该干的事。**
|
||||
|
||||
> **编者注:** Anthropic 的发布节奏有多快?有人做过一个日历,发现 Anthropic 在 2026 年前几个月几乎每天都有一个重要功能或产品发布。
|
||||
|
||||
## 4\. PRD 没死,但活法不同了
|
||||
|
||||

|
||||
|
||||
Lenny 问 PRD 还写不写。Cat 说他们做了两件替代的事。
|
||||
|
||||
**第一是每周做严格的 metrics readout**,整个团队一起看数据,确保每个人都深度理解业务的各个面、关键目标、趋势和驱动因素。
|
||||
|
||||
**第二是维护一份 team principles**,包括谁是核心用户、为什么是他们、愿意做什么取舍。这份原则的目的是让团队每个人都能自己做决策,不需要等 PM 或其他利益相关方来拍板。
|
||||
|
||||
PRD 并没有完全消失。对于特别模糊的功能,Cat 还是会写一页纸,列出目标、理想场景、当前失败模式。需要大量基础设施投入的长期项目也仍然有 PRD。但大部分功能不需要。
|
||||
|
||||
## 5\. 不是 Mythos 让他们变快的
|
||||
|
||||

|
||||
|
||||
Lenny 注意到 Anthropic 还没正式发布的 Mythos 模型引发了外界的关注,问他们内部是不是在用这个模型来加速开发。
|
||||
|
||||
Cat 的回答很直接:**他们已经快了好几个季度了,Mythos 不是核心原因。** Mythos 很强大,他们确实在内部使用模型,这多少加速了开发,但不足以解释速度提升的主要部分。更大的原因是**流程和团队的期望设定**:每个人都觉得自己有权力也有责任把想法在一周内变成现实。
|
||||
|
||||
> **编者注:** Mythos(内部代号 Capybara)是 Anthropic 的最新前沿模型,2026 年 4 月 7 日以研究预览形式限量发布,主要用于 Project Glasswing 网络安全项目。最初在 3 月 26 日因 CMS 配置错误提前曝光,Fortune 等媒体拿到的草稿描述它是一款比 Opus 更大、更强的模型。Anthropic 称该模型在代码、推理和网络安全方面能力大幅超越此前所有模型,已发现数千个零日漏洞。
|
||||
|
||||
## 6\. 源代码泄露:定性为流程失败
|
||||
|
||||

|
||||
|
||||
2026 年 3 月底,Claude Code 的完整源代码通过 npm 包泄露。Lenny 问 Cat 发生了什么。
|
||||
|
||||
Cat 说他们第一时间就去查了。原因是**人为错误**,有人在用 Claude 写一个关于包发布流程更新的 PR,这个 PR 经过了两层人工审查,但还是漏了。他们已经加固了流程,确保不会再发生。
|
||||
|
||||
Lenny 追问了一个尖锐的问题:这个人还在 Anthropic 吗?Cat 的回答很干脆:**还在。这是流程失败,最重要的是学习教训、加强防护。**
|
||||
|
||||
> **编者注:** 泄露的根本原因是 Claude Code 使用 Bun 运行时构建,Bun 默认生成 source map 文件,而 .npmignore 中缺少 \*.map 条目,导致一个 59.8 MB 的 source map 文件被发布到公共 npm 注册表,暴露了约 2,000 个文件、512,000 行 TypeScript 源代码、44 个未公开的功能标志,以及一个名为 KAIROS 的自主后台 Agent(从泄露的代码中发现的未发布功能,能让 Claude 在后台持续运行,甚至在用户空闲时做“记忆整理”)。这已经是 13 个月内的第二次代码泄露,而且发生在 Mythos 模型信息因 CMS 错配泄露后仅 5 天。对于一家以“安全优先”为品牌定位的公司来说,一周内两次泄露引发了外界对其运营安全的质疑。
|
||||
|
||||
## 7\. 封堵 OpenClaw:容量管理还是生态围墙?
|
||||
|
||||

|
||||
|
||||
Lenny 问到了另一个争议话题:Anthropic 禁止订阅用户通过第三方工具(特别是 OpenClaw)使用 Claude。开源社区反应很大。
|
||||
|
||||
Cat 的解释是:Claude 的需求量很大,他们一直在努力扩展基础设施,同时也在优化 harness 的 token 效率。**订阅计划不是为第三方产品的使用模式设计的**,这类产品给系统带来了不成比例的压力。他们花了很多时间想最平滑的过渡方案,最终决定给每个用户随订阅附赠一些额度,但核心决策是优先保障自有产品和 API。
|
||||
|
||||
> 我们确实需要做出一个艰难的决定,优先保障我们的第一方产品和 API。 (“We did have to make the hard decision that we needed to prioritize our first-party products and our API.”)
|
||||
|
||||
> **编者注:** Cat 的回答只覆盖了这个争议的一个面。完整的时间线是这样的:OpenClaw(原名 Clawdbot,2026 年 1 月因 Anthropic 担心商标混淆改名)是奥地利开发者 Peter Steinberger 创建的开源 AI Agent 框架,在 2026 年初迅速走红,GitHub 累计 24.7 万颗星,是开源史上增长最快的项目之一。2 月 14 日,Steinberger 宣布加入 OpenAI,OpenClaw 移交开源基金会。2 月 20 日,Anthropic 更新条款明确禁止订阅 OAuth token 用于第三方工具。3 月底 Anthropic 自己的 Cowork 上线了 Claude Dispatch 等功能,和 OpenClaw 最受欢迎的能力高度重合。4 月 4 日正式封堵生效,给用户的通知不到 24 小时。Steinberger 批评 Anthropic“先复制热门功能到自己的封闭 harness 里,再把开源锁在门外”。Boris Cherny 则在 X 上表示团队“是开源的大粉丝”,他本人还给 OpenClaw 提交过改善提示缓存效率的 PR。这些举动和实际政策之间的温度差,用户感受得到。一个 $200/月的 Max 订阅用户如果通过 OpenClaw 跑全天自主 Agent,可能消耗相当于 $1,000-$5,000 的 API 成本,从经济角度看 Anthropic 的决定有合理性。但这个决定的时间节点和 Cowork 功能扩展的巧合,仍然是社区争议的核心。
|
||||
|
||||
## 8\. PM 团队的全貌
|
||||
|
||||

|
||||
|
||||
Cat 说 Anthropic 大约有 **30-40 名 PM**,分布在几个团队:
|
||||
|
||||
- **研究 PM 团队**:负责收集客户对模型的反馈并推动模型发布
|
||||
- **Claude 开发者平台团队**:维护 API 和 Managed Agents 等服务
|
||||
- **Claude Code 团队**:做核心产品
|
||||
- **企业团队**:负责安全控制、成本管控、RBAC(基于角色的访问控制)等让大企业安心使用的功能
|
||||
- **增长团队**:负责整个产品套件的增长
|
||||
|
||||
## 9\. 角色融合:工程师、PM、设计师的界限在消失
|
||||
|
||||

|
||||
|
||||
Lenny 问了那个所有 PM 都在焦虑的问题:PM 未来还需要吗?
|
||||
|
||||
Cat 的观察是**所有角色都在融合**。PM 在写代码,工程师在做产品决策,设计师在做 PM 的活也在提交代码。她说有两条路可以走:要么大量招有产品品味的工程师,要么维持工程师数量不变、多招 PM 来引导。**Anthropic 选的是前者——大量招有产品品味的工程师。**
|
||||
|
||||
她说团队里很多工程师完全能独立完成从“在 Twitter 上看到用户反馈”到“周末发布功能”的全流程,几乎不需要 PM 参与。这是最高效的模式。
|
||||
|
||||
> 当代码变得越来越便宜,真正变得更有价值的是决定写什么。 (“As code becomes much cheaper to write, the thing that becomes more valuable is deciding what to write.”)
|
||||
|
||||
Cat 自己就是工程师出身。她之前在 Scale AI 做产品工程师,在 Dagster Labs 做工程经理,然后去了 Index Ventures 做风投。团队里几乎所有 PM 要么曾经是工程师,要么在 Claude Code 上直接写代码。设计师也都做过前端工程师。
|
||||
|
||||
那工程背景为什么在当下特别有用?Cat 解释说,如果你有工程背景,你能判断一件事应该有多难。如果很简单,别讨论了,花一小时做掉;如果很难,你提前知道成本,就能更准确地排优先级。
|
||||
|
||||
不过她还是认为,不管什么背景,**最核心的能力是 product taste(产品品味)**。
|
||||
|
||||
> Product taste 仍然是一种非常稀缺的技能,任何能强有力地展示这种能力的人,我们基本都会录用。 (“Product taste is still a very rare skill to have, and we'll pretty much hire anyone who we feel has demonstrated this strongly.”)
|
||||
|
||||
## 10\. “恰好正确程度的 AGI 信仰”
|
||||
|
||||

|
||||
|
||||
谈到 PM 需要什么新技能,Cat 给出了全场最有洞察力的回答。
|
||||
|
||||
最难的技能是**定义产品一个月后应该长什么样**。这里面的模糊性很大:模型的能力在那个时间范围内会变成什么样?用户行为又会如何改变?
|
||||
|
||||
> 做到恰好正确程度的 AGI 信仰非常难。 (“It is very hard to be the right amount of AGI pilled.”)
|
||||
|
||||
Cat 说,每个人都能看到那个终极未来:\*\*模型极其聪明,什么都能做,你只需要一个输入框告诉它你想要什么,它自己就能接入任何工具完成任务。\*\*这就是 AGI 的产品形态。
|
||||
|
||||
但问题是,**为那个终极版本做产品太容易了。难的是搞清楚当前模型的能力边界在哪,怎么在这个边界内榨出最大价值。** 太 AGI pilled 会让你忽略眼前用户的痛点,太保守又会在下一次模型升级时措手不及。
|
||||
|
||||
最好的 PM 能看到一种信号:**用户如何突破现有产品的极限**。他们能从这些信号里判断方向,稳步推进,同时在模型能力超出或低于预期时灵活调整路线。
|
||||
|
||||
Cat 自己的做法是把 30% 的时间花在故意把 Cowork 推到极限,和模型对话,搞清楚它为什么在某些任务上犯错。
|
||||
|
||||
## 11\. 模型暂时还不懂的东西
|
||||
|
||||

|
||||
|
||||
Lenny 问:在模型变得超级聪明之前,人脑在哪些地方还有用?
|
||||
|
||||
Cat 的回答指向**常识和情商**。任何一次产品发布都有一千个细碎环节,模型还不能很好地判断谁是关键的利益相关方、他们之间的关系、他们的偏好、应该用什么沟通场合让他们保持在状态里。这种隐性的人际判断仍然是人的领地。她相信模型会越来越擅长这些,但目前缺口还在。
|
||||
|
||||
## 12\. P0 到 P0000:混乱中怎么保持理智
|
||||
|
||||

|
||||
|
||||
Lenny 问如何在这种节奏下保持理智。Cat 笑着说他们的团队都是**享受混乱的人**。面对每一个挑战都带着笑容,因为如果你对任何事情太紧张,就会燃尽。
|
||||
|
||||
她给了一个很有画面感的描述:周日晚上出了一个 P0(最高优先级事故),周一又来一个 P0,周一下午来了个 P0000,**“你会想,天啊,我居然还为周日那个 P0 担心过。”**
|
||||
|
||||
她的应对方式很实际:承认你能做的事有限,睡好觉才能第二天做好决策,暴力排优先级,允许产品不够完美。有些发布确实不够打磨,但只要不影响核心场景,就接受它,等反馈,下个版本修。
|
||||
|
||||
## 13\. 速度的代价:功能重叠,用户困惑
|
||||
|
||||

|
||||
|
||||
Lenny 问为了速度牺牲了什么。Cat 说最大的代价是**产品一致性**。
|
||||
|
||||
传统做法是仔细规划产品套件里每个产品的关系、每个产品的场景、它们怎么整合。现在 Anthropic 有时候会同时推出功能重叠的东西,因为内部有两种方案都不错,他们想让外部用户来告诉他们哪个更好。
|
||||
|
||||
代价是新用户可能不知道完成某件事的最佳路径是什么。她承认需要做更多教育工作来帮用户理解核心功能和最佳实践。
|
||||
|
||||
## 14\. Anthropic 为什么能赢:使命和聚焦
|
||||
|
||||

|
||||
|
||||
Cat 说了两个因素。
|
||||
|
||||
**第一是统一使命。** Anthropic 招的是最在意“把安全 AGI 带给全人类”的人,这个使命在产品决策中被频繁引用。因为使命高于任何单个产品线,跨组织决策可以非常快,执行可以高度统一。
|
||||
|
||||
Cat 特别强调了使命的具体含义:**它意味着团队愿意做出牺牲自身目标和 KR 的决策,来服务 Anthropic 整体的目标和 KR**,而且人们很乐意做这种取舍。
|
||||
|
||||
> 使命意味着团队愿意做出伤害自己目标和 KR 的牺牲,来服务 Anthropic 的整体目标和 KR。 (“Mission means that teams are willing to make sacrifices that hurt their own goals and their own KRs in service of Anthropic's goals and Anthropic's KRs.”)
|
||||
|
||||
## 15\. Claude Code、Desktop、Cowork:什么时候用哪个
|
||||
|
||||

|
||||
|
||||
这部分 Cat 给了一个清晰的分类。
|
||||
|
||||
- **CLI(命令行版)**:最强大的,功能通常最先在这里上线。适合随手启动一个编程任务,需要最新最全功能的时候用。
|
||||
- **Desktop 版**:适合做前端开发。Cat 经常打开预览窗格,一边和 Claude 聊天一边实时看自己在构建的 Web 应用。
|
||||
- **Web 和移动端**:适合不在电脑前的时候。走在路上有个想法,掏出手机就能启动任务。
|
||||
- **Cowork**:处理非代码输出——回完 Slack 消息、做一个客户会议的 slide deck、写一份功能目标文档。
|
||||
|
||||
Cat 特别提到,要让 Cowork 发挥最大作用,第一步是**连接所有相关数据源**:Google Calendar、Slack、Gmail、Google Drive。只有 Cowork 能访问到足够的上下文,它才能给出高质量的输出。
|
||||
|
||||
## 16\. 自定义应用:每个人的个人 SaaS
|
||||
|
||||

|
||||
|
||||
Cat 讲了一个例子。Claude Code 销售团队里有个人,发现自己反复做同样类型的演示文稿。他用 Claude Code 做了一个 web 应用,内置了效果好的 deck 模板,可以从 Salesforce 和 Gong 拉取客户数据,自动生成针对特定客户的定制 deck,比如会标注这个客户是用 Bedrock 还是 Claude Code for Enterprise,对应不同的功能集。
|
||||
|
||||
## 17\. Token 花费在涨,但仍低于薪资
|
||||
|
||||

|
||||
|
||||
Lenny 提到一个热门话题:token 花费超过员工薪资。Cat 确认了趋势但没给具体数字。她说每次模型升级或产品大幅改进后,人们会把更多任务交给 AI,花更多时间在 Claude Code 和 Cowork 里,**单个工程师或知识工作者的 token 成本确实在增长**。但目前仍然远低于工程师薪资,只是占比在持续上升。
|
||||
|
||||
## 18\. Claude 的性格是护城河
|
||||
|
||||

|
||||
|
||||
Cat 说 Claude 的一个核心差异化是**性格**。用户经常提到 Claude 让人觉得“轻松有趣但又极其能干”。
|
||||
|
||||
她特别提到两个性格特点:
|
||||
|
||||
- **低 ego**:你告诉 Claude 它做错了,它会说“哎呀,谢谢你告诉我,我来修”,而不是辩解。
|
||||
- **积极正面**:当你面对一个看起来无从下手的任务,Claude 会说“没关系,我觉得我们可以这样开始,要我先帮你动手吗?”
|
||||
|
||||
Cat 把这比作同事关系。回想你合作过的所有人,总有一些人让你觉得他们的能量特别好。Claude 的目标就是做那种同事。
|
||||
|
||||
## 19\. 产品愿景:从单任务到 Agent 矩阵
|
||||
|
||||

|
||||
|
||||
Cat 用 **“building blocks”** 来描述长期路线。核心构建单元是**单个任务的成功率**:你给一个清晰的 prompt,它能不能持续产出可接受的输出?
|
||||
|
||||
随着模型变强,单任务成功率上升,用户自然开始做多任务并行。2025 年底 multi-coding 成了大趋势,现在更加普遍。
|
||||
|
||||
Cat 的推演是:一个任务成功了,然后六个任务同时做。再往后,也许同时跑 50 个 Claude,或者上百个。**这条路线从单兵作战走向 Agent 矩阵。**
|
||||
|
||||
## 20\. 闪电轮:攀岩、Waymo、和一万块巨石的退休生活
|
||||
|
||||

|
||||
|
||||
Cat 推荐了两本书:
|
||||
|
||||
- **《How Asia Works》**:讲的是什么样的政策和政府能造就持久成功的经济体。
|
||||
- **《The Technology Trap》**:讲的是过去几次技术革命(工业革命、计算机革命)对工人的影响。
|
||||
|
||||
两本都和她正在经历的 AI 变革直接相关。
|
||||
|
||||
最喜欢的产品是 Waymo,每天坐两次通勤。最喜欢的影视是 F1 纪录片《Drive to Survive》和攀岩纪录片《Free Solo》。Cat 说她喜欢看人极度专注于一个纯粹的工程目标,这个偏好多少解释了她为什么会在 Anthropic。
|
||||
|
||||
如果有一天不用工作了?她说可能会搬到法国枫丹白露,那里有一万块巨石,每天攀岩。还想把阅读量从现在的每周 0.5 本提到一两本。
|
||||
|
||||
## Q&A 速览
|
||||
|
||||

|
||||
|
||||
- **Anthropic 的 PM 团队有多大?** 大约 30-40 人,分研究、开发者平台、Claude Code、企业和增长五个团队。
|
||||
- **PM 还需要写 PRD 吗?** 大部分功能不需要。每周 metrics readout 和 team principles 替代了常规 PRD。特别模糊或需要大量基础设施投入的项目仍然有一页纸的 PRD。
|
||||
- **Anthropic 用 Mythos 模型加速内部开发了吗?** 有帮助但不是核心原因。速度更多来自流程和团队文化。
|
||||
- **Claude Code 源代码泄露后相关人员被开除了吗?** 没有。Cat 定性为流程失败,已加固防护措施。
|
||||
- **什么时候用 Claude Code 什么时候用 Cowork?** 需要代码输出用 Claude Code,需要非代码输出(文档、deck、邮件处理)用 Cowork。
|
||||
|
||||
## 编辑手记:三个值得关注的矛盾
|
||||
|
||||

|
||||
|
||||
这期访谈整体是一次相当友好的对话,Lenny 没有在敏感话题上深追,Cat 也把控得很好。但几个有意思的矛盾值得关注。
|
||||
|
||||
**第一个是速度文化和安全承诺之间的缝隙。** Cat 用了大量篇幅讲“一天出一个功能”“降低发布承诺”“让工程师自主发布”的速度文化,但 Anthropic 同时是那家把“安全”写在公司名片上的 AI 实验室。一周内两次信息外泄(Mythos CMS 错配 + Claude Code 源码 source map),Cat 的解释都是“人为失误,已加防护”。这两次失误的性质已经超出了单个 PR 的范围。对速度文化本身是否加剧了这类风险,她没有任何反思。
|
||||
|
||||
**第二个是开放生态和围墙花园之间的取舍。** Cat 对 OpenClaw 的解释在经济逻辑上成立,一个 $200/月的订阅用户通过 Agent 框架可能消耗价值数千美元的算力。但时间线上的巧合很难忽略:Anthropic 在自己的 Cowork 产品推出了类似功能之后,才封堵了第三方工具的订阅通道。OpenClaw 创始人 Peter Steinberger 的批评“先复制热门功能到封闭的 harness 里,再把开源锁在门外”,Cat 在访谈中没有正面回应。Boris Cherny 一边说“我们是开源的大粉丝”一边给 OpenClaw 提交过改善性能的 PR,这些举动和实际政策之间的温度差,也许比政策本身更值得玩味。
|
||||
|
||||
**第三个矛盾藏在 Cat 关于 PM 角色的论述里。** 她用“角色融合”来描述 PM 的未来,但她自己给出的最高效模式是工程师端到端完成从用户反馈到发布的全流程,“几乎不需要 PM 参与”。如果这是真的,那 PM 的价值到底在哪?Cat 的答案是 product taste,但这个概念在整场对话中始终停留在抽象层面,没有给出任何可操作的定义或评估标准。当一个筛选标准无法被明确描述时,它很容易变成一个不可证伪的门槛。而她关于 AGI pilled 的论述暗含一个更深的悖论:如果模型足够强,一个文本框就够了,那她所做的产品工作本质上是过渡性的。一个产品负责人承认自己的工作有保质期,这种坦率不常见。
|
||||
|
||||
接下来值得观察的信号:Anthropic 承诺的安全防护措施是否真正起效,OpenClaw 封堵后开发者生态的走向,以及这套“永久 beta”的 research preview 模式能持续多久,用户的忍耐度有没有上限。
|
||||
|
||||
原始视频:[https://www.youtube.com/watch?v=PplmzlgE0kg](https://www.youtube.com/watch?v=PplmzlgE0kg)
|
||||
@@ -0,0 +1,456 @@
|
||||
---
|
||||
title: "Harness Engineering for Self-Improvement"
|
||||
source: "https://lilianweng.github.io/posts/2026-07-04-harness/"
|
||||
author:
|
||||
- "[[Lilian Weng]]"
|
||||
published: 2026-07-04
|
||||
created: 2026-07-08
|
||||
description: "The concept of recursive self-improvement (RSI) dates back to I. J. Good (1965), where he defined an “ultraintelligent machine” as a system that can surpass humans in all intellectual activities and design better machines to improve itself. Yudkowsky (2008) used the phrase “recursive self-improvement” for a specific feedback loop: an AI uses its current intelligence to improve the cognitive machinery that produces its intelligence.This feedback loop in modern AI may indicate the model rewriting its own weights directly, or more broadly the model improves the training pipeline and the deployment system, which in turn enables a better successor model with improved performance across economically valuable tasks. The speed of research development in AI has been shown to drastically accelerated in frontier labs (Anthropic; OpenAI)."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||
**递归式自我改进(RSI)** 的概念 可以追溯到 [I.J. Good(1965)](https://philpapers.org/rec/GOOSCT) ,他将“超智能机器”定义为一种能够在所有智力活动中超越人类,并能设计出更优秀的机器来改进自身的系统。Yudkowsky [(2008)](https://www.lesswrong.com/posts/JBadX7rwdcRFzGuju/recursive-self-improvement) 则用“递归式自我改进”来描述一种特定的反馈循环:人工智能利用其当前的智能来改进产生自身智能的认知机制。
|
||||
|
||||
现代人工智能中的这种反馈循环可能意味着模型直接重写自身的权重,或者更广泛地说,模型改进了 *训练流程* 和 *部署系统,进而催生出性能更优的后续模型,从而在具有经济价值的任务中脱颖而出。人工智能研究的进展速度在前沿实验室(* [例如 Anthropic](https://www.anthropic.com/institute/recursive-self-improvement) 和 [OpenAI](https://openai.com/index/how-agents-are-transforming-work/) ) 中已显著加快。
|
||||
|
||||
我特意提到 *“部署系统”,* 是因为原始模型与真实世界环境之间的这层机制似乎与模型的原始智能(即预训练后的评估)同样重要。正如 Claude Code 和 Codex 等成功的编码代理产品所展示的那样,部署系统是人工智能部署的重要组成部分。 **部署** 系统围绕基础模型构建,负责协调执行,决定模型的思考和规划方式、工具调用和行动方式、感知和管理环境、存储工件以及评估结果。
|
||||
|
||||
本文将重点探讨线束工程及其对 RSI 的贡献。许多近期关于自动研究、自改进智能体和进化程序搜索的研究都可以围绕这一问题展开。其他关于模型自博弈、合成数据、测试时训练以及更广泛的持续学习主题的研究也符合 RSI 的愿景(例如 [Yuan 等人,2024](https://arxiv.org/abs/2401.10020) ; [Chen 等人,2024](https://arxiv.org/abs/2401.01335) ; [Zhao 等人,2025](https://arxiv.org/abs/2505.03335) ; [Choi 等人,2026](https://openreview.net/forum?id=lTbBFAoPSA) ),但它们并非本文的重点。
|
||||
|
||||
## 线束设计模式
|
||||
|
||||
与 [早期的代理框架](https://lilianweng.github.io/posts/2023-06-23-agent/) (即“代理 = 逻辑逻辑模型 + 内存 + 工具 + 规划 + 行动”)相比,如今的代理工程还包含了 *工作流设计(例如循环工程)、评估、权限控制和持久状态管理* 。它不再仅仅是提示模板,而是更接近运行时和软件系统设计:模型如何观察、行动、记忆、自我检查和改进。
|
||||
|
||||
设计应力求简洁通用,以便于推广应用,并可能参考现有的软件工程实践,从而借鉴已有的知识。操作系统和框架之间存在着很强的相似性。与操作系统类似,框架也应封装复杂的逻辑,同时保持接口的简洁性。与此同时,配置、工具接口和其他协议可能会逐步在行业内实现标准化。
|
||||
|
||||
## 模式 1:工作流自动化
|
||||
|
||||
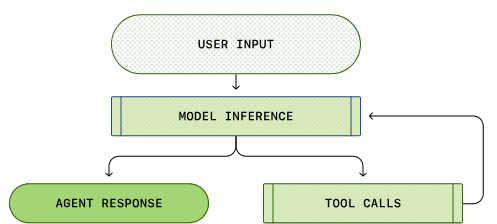
定义一个模型可以运行、测试和迭代的工作流程是自动化设计的关键。Karpathy 的 autoresearch 代码库( [https://github.com/karpathy/autoresearch](https://github.com/karpathy/autoresearch) )就是一个构建此类工作流程的清晰示例。常见的工作流程遵循一个以目标为导向的循环:计划、执行、观察/测试、改进,然后再次执行, *直到* 目标达成。该过程可能会主动向用户发出请求,以明确任务规范或执行偏好。
|
||||
|
||||
|
||||
|
||||
简化的 Codex 代理循环:代理调用工具,工具的响应会影响模型的下一代。 (图片来源: OpenAI Codex 代理帖子 )
|
||||
|
||||
工作流程图还强调模型分析自身的轨迹和失败案例,然后通过“代理运行时”迭代其进展,而不是使用静态提示模板。
|
||||
|
||||
## 模式 2:文件系统作为持久内存
|
||||
|
||||
长周期智能体系统中一个反复出现的模式是对丰富的状态和工件进行简单的控制。一个框架不应该承载整个工作流程和所有上下文日志;相反,它应该将持久状态保存在文件中。在长周期智能体部署过程中,诸如实验日志、代码差异、论文摘要、错误跟踪和以往部署轨迹等工件通常会远远超出模型训练的上下文窗口。
|
||||
|
||||
学习如何读取、写入和编辑文件系统(通常通过 `bash` 命令)是 LLM 的基础技能,因此,以文件这种简单形式管理持久内存自然会受益于核心模型能力的提升。
|
||||
|
||||
## 模式 3:子代理和后端作业
|
||||
|
||||
一个代理框架可以生成多个子代理并行执行并监控后端作业。当主代理需要搜索多个假设、并发运行实验或在不污染主上下文的情况下委派独立的子任务时,这非常有用。父代理则需要一个小型进程管理器:启动作业、检查日志、取消失败的运行并将结果合并回主代理线程。
|
||||
|
||||
关键的设计选择在于明确并行性并使其可检查。如果子代理的输出仅存在于瞬态的聊天上下文中,它们很快就会过时并被隐藏。如果将它们存储为文件、日志和状态记录,模型就可以在中断后恢复,并根据自身的执行历史进行推理。
|
||||
|
||||
## 案例研究:编码代理工具
|
||||
|
||||
主流编码代理的核心接口在 Claude Code、Codex、OpenCode 和 Cursor 等代理中已经趋于稳定。它们通常使用类似这样的循环:
|
||||
|
||||
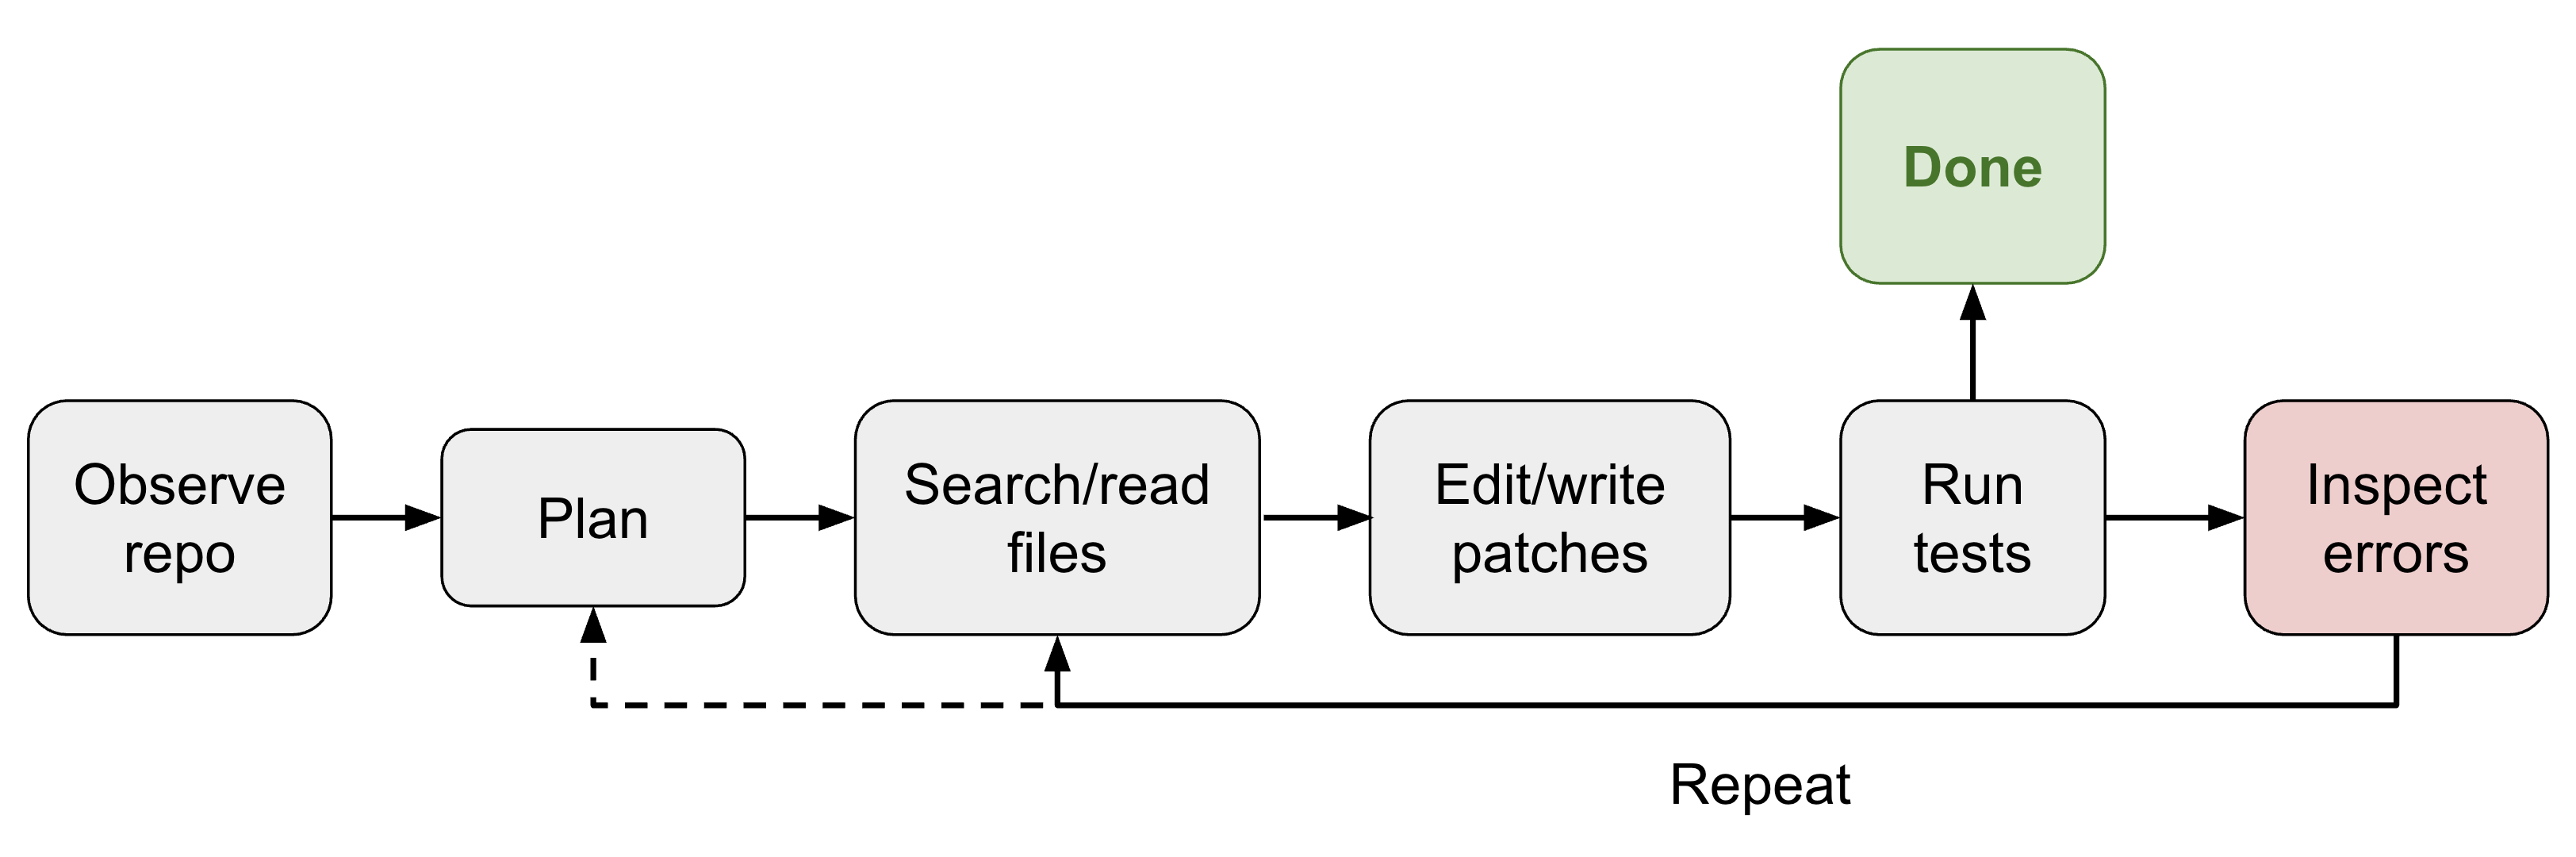
|
||||
|
||||
通过访问一系列工具,编码代理能够开发和调试给定存储库中的问题,类似于人类开发人员使用集成开发环境 (IDE) 的方式。
|
||||
|
||||
(此列表并不完整,仅作演示之用。如有兴趣,请阅读 [原文](https://github.com/yasasbanukaofficial/claude-code) 。)
|
||||
|
||||
| 团体 | 工具定义 |
|
||||
| --- | --- |
|
||||
| 文件系统 | \- 文件发现: `glob` ,, `grep` \- `ls` 文件读取: `read` , `read_many` \- 文件修改:( `write` 新建一个文件); `edit` (字符串精确匹配替换);; `multi_edit` ( `apply_patch` 应用结构化补丁/差异) |
|
||||
| Shell 执行 | 运行命令: `bash` , `PowerShell` |
|
||||
| IO | `lsp` git 工具 如 `git_status` , `git_diff` `git_commit` |
|
||||
| 外部环境 | MCP 工具、技能 |
|
||||
| 网络搜索 | `web_search` 浏览 `web_fetch` 器工具 |
|
||||
| 文物 | 读取文档、图像;生成 HTML、图像 |
|
||||
| 后端流程 | 例如: `CronCreate` , `CronDelete` , `CronList` |
|
||||
| 代理人委派 | 例如 : `spawn_agent` ,,,,,, 等等 。 `resume_agent` `wait_agent` `list_agents` `close_agent` `interrupt_agent` |
|
||||
|
||||
## 管理层与核心智能?
|
||||
|
||||
很难预测RSI的未来发展在多大程度上依赖于线束工程,但RSI的近期发展路径不太可能是从直接重写模型权重开始。我对近期切实可行的发展路径的预测是:
|
||||
|
||||
1. 线束工程将朝着元方法论的方向发展(即改进获取更佳答案的机制,而不仅仅是改进答案本身)。线束系统本身将成为优化目标,减少启发式规则,采用更通用的机制。
|
||||
2. 反过来,成熟的框架能够实现模型自我改进循环的自动研究,而更智能的模型可以防止框架过度设计,并保持系统的可持续性。
|
||||
|
||||
最终,许多模型改进可能会 *被内化* 到核心模型行为中,但与外部上下文和工具的接口仍应保留。我们在 [提示工程](https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/) 中已经看到了这种模式的温和版本:随着指令调整和模型推理能力的提升,手动提示技巧的重要性有所降低,但 *指定目标、约束、上下文和评估的需求并未消失* 。
|
||||
|
||||
## 牵引优化
|
||||
|
||||
在模型优化系统中,待优化对象的迭代过程大致如下:指令 [提示](https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/) → 结构化上下文 → 工作流 → 模型优化代码 → 优化器代码。随着模型变得更加智能和强大,我们会转向更复杂的目标和更通用的方法。
|
||||
|
||||
## 上下文工程
|
||||
|
||||
随着智能体任务范围的显著扩大,简单地将所有工具响应和模型生成结果添加到上下文中,很快就会变得难以控制。上下文管理层旨在为长上下文模型 (LLM) 构建一个更结构化、更简洁的上下文,并管理持久状态。毫无疑问,长上下文研究将持续取得进展,但目前长上下文智能和上下文工程有时会相互交织。
|
||||
|
||||
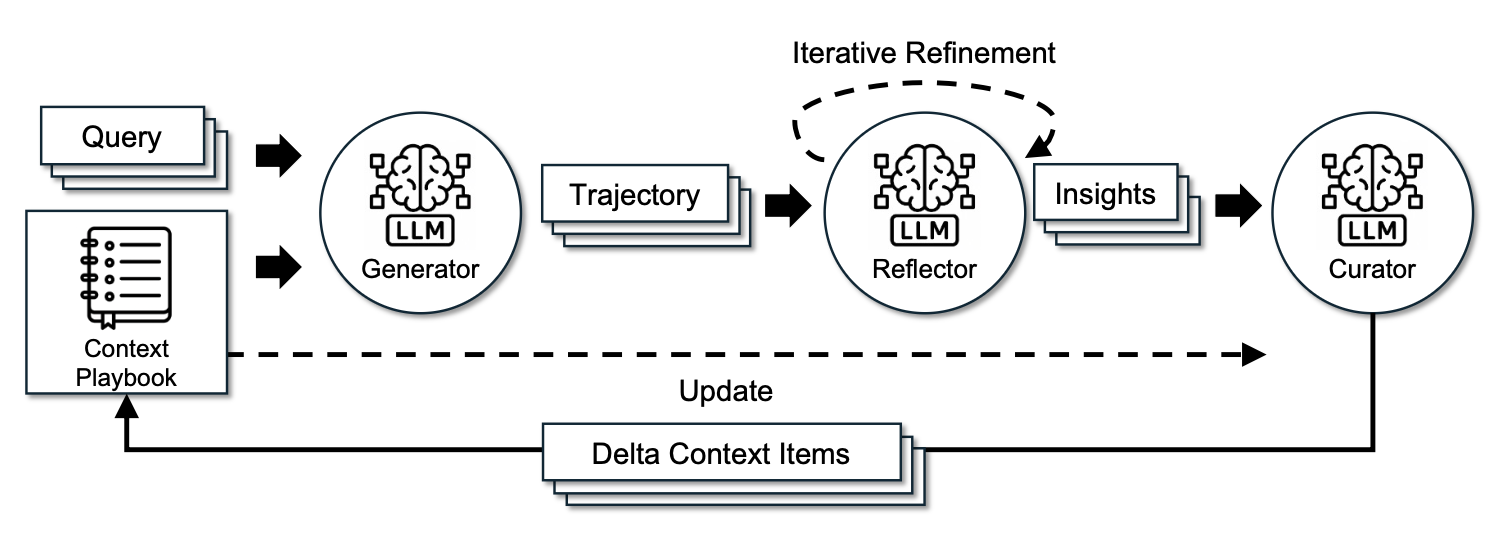
**智能情境工程** (ACE; [Zhang 等人,2025](https://arxiv.org/abs/2510.04618) )将情境视为不断演进的剧本,而非日益冗长的提示。它包含三个组成部分,用于维护一个由要点组成的情境剧本,每个要点都包含一个标识符和一个描述。
|
||||
|
||||
1. *生成器* :根据要点生成任务轨迹。
|
||||
2. *反思者* :从成功和失败的轨迹中提炼洞见。
|
||||
3. *策展人* :通过逐步添加条目来更新结构化上下文。
|
||||
|
||||
|
||||
智能体情境工程(ACE)框架。(图片来源: Zhang et al. 2025 )
|
||||
|
||||
为了防止在迭代重写过程中出现上下文混乱和过于追求简洁的情况,ACE 的一个关键设计选择是:策展人不会重写完整的提示信息。相反,它会输出一系列结构化的、条目式的要点,格式为(标识符,描述)。这些要点会通过确定性逻辑合并到一个结构化的上下文日志中。上下文条目会定期进行完善和去重。
|
||||
|
||||
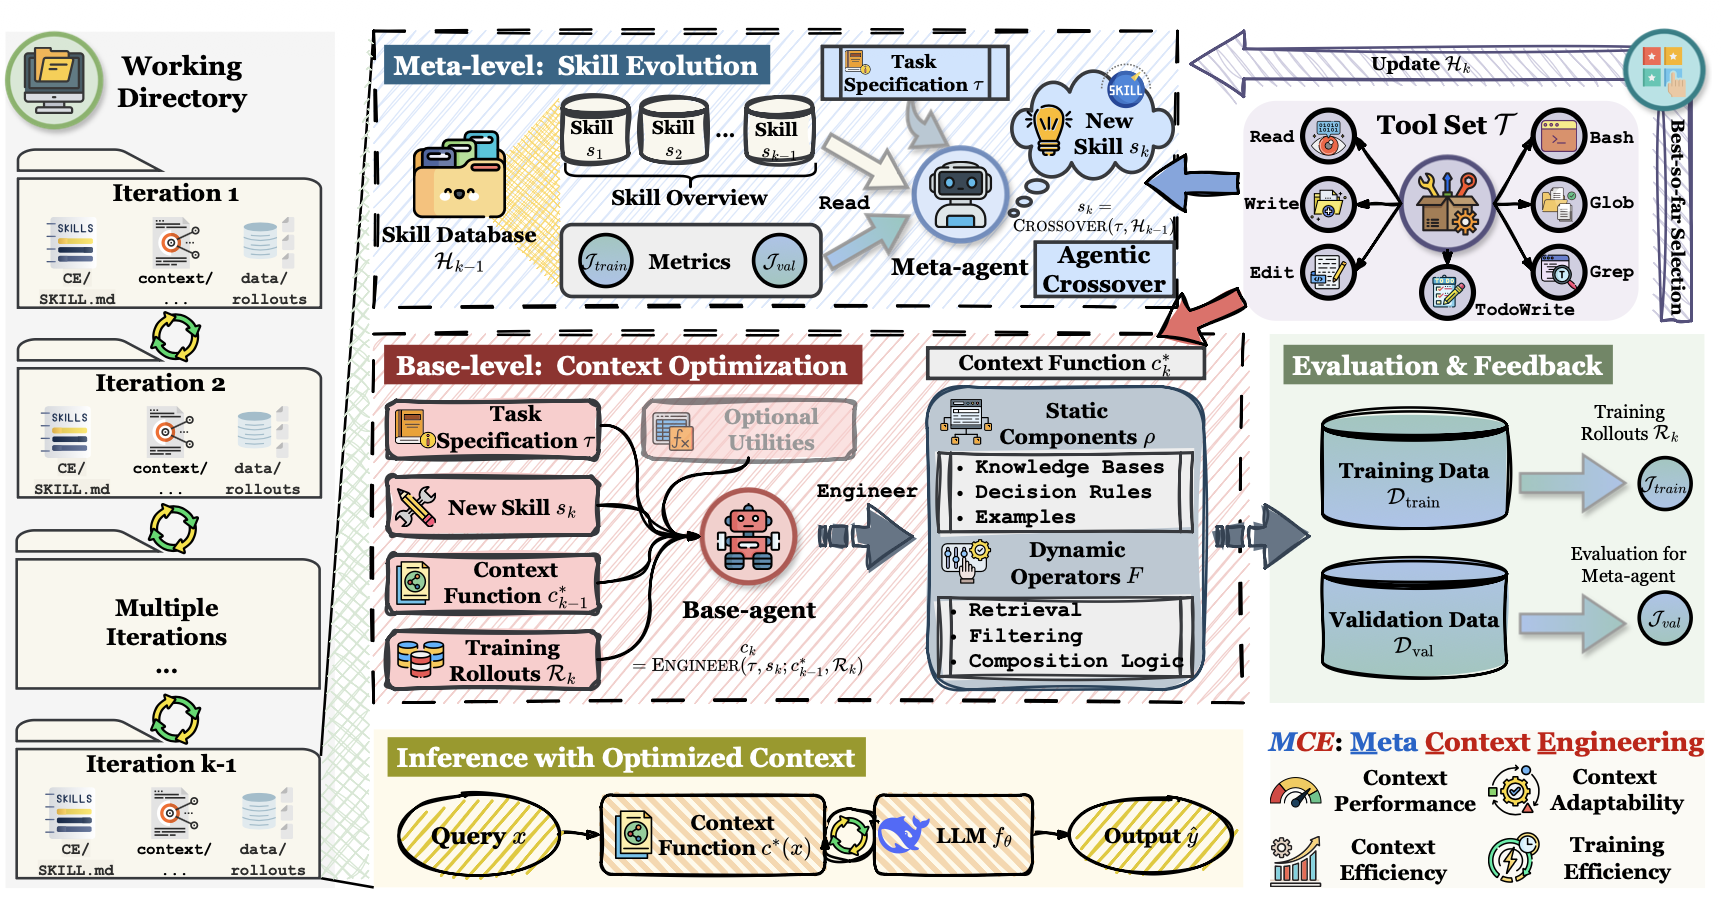
ACE 从部署过程中学习经验这一事实有助于我们实现内存的自我管理,但更新规则和整体工作流程仍然是手工设计的。为了构建更具自我改进性的循环, **元上下文工程** (MCE; [Ye 等人,2026](https://arxiv.org/abs/2601.21557) )将机制(如何管理上下文)与工件内容(上下文中包含什么)分离,在元优化层面运行技能演化,在基础层面运行上下文优化。
|
||||
|
||||
MCE技能 $\mathcal{}$ 定义上下文函数 $_{} _{} _{}$ 并映射输入 $$ 上下文 $_{} _{}$ , 在哪里:
|
||||
|
||||
- $_{} _{} _{}$ are static components (prompts, knowledge bases, code libraries).
|
||||
- $F_{s} = \left\{F_{1} , \ldots , F_{k}\right\}$ are dynamic operators (search, selection, filtering, formatting).
|
||||
|
||||
The bi-level optimization is to find the best context $c_{s}^{*}$ given skill $s$ on the training data, while the outer loop finds the optimal skill that provides the best performance on the validation set:
|
||||
|
||||
$$
|
||||
\text{Inner}:\text{ } c_{s}^{*} = arg \underset{c_{s}}{max} J_{\text{train}} \left(c_{s} ; s\right) \text{Outer}:\text{ } s^{*} = arg \underset{s \in \mathcal{S}}{max} J_{\text{val}} \left(c_{s}^{*}\right)
|
||||
$$
|
||||
|
||||
The skill database tracks the history of previous skills, context functions and eval metrics $\mathcal{H}_{k - 1} = \left\{\right. \left(s_{i} , c_{i} , J_{i}^{\text{train}} , J_{i}^{\text{val}}\right) \left.\right\}_{i = 1}^{k - 1}$. A meta-level agent performs agentic [crossover](https://en.wikipedia.org/wiki/Crossover_\(evolutionary_algorithm\)) over prior skills to create a new skill given a task $\tau$: $s_{k} = \text{crossover} \left(\tau , \mathcal{H}_{k - 1}\right)$.
|
||||
|
||||
Then a base-level context engineer executes the skill $s_{k}$ and learns the context function from rollout feedback $\mathcal{R}_{k}$, guided by the current skill: $c_{k} = \text{engineer} \left(\tau , s_{k} ; c_{k - 1}^{*} , \mathcal{R}_{k}\right)$.
|
||||
|
||||
|
||||
|
||||
The framework of Meta Context Engineering (MCE): meta-level skill evolution searches over context-management mechanisms, while the base level optimizes the task context. (Image source: Ye et al. 2026 )
|
||||
|
||||
MCE does not enforce a heuristic rule for how to structure context as ACE does. It uses *free-form skills* to store the most important knowledge for a task, and evolves the skill and the skill-conditioned context iteratively together. Implementation-wise, a context function $c$ is instantiated as a collection of files in a dedicated directory, including both static (`skill.md`) and dynamic (context and data rollouts) components. Both meta-level and base-level optimization are executed in agentic coding envs with a standard tool set,
|
||||
|
||||
$$
|
||||
\mathcal{T} = \left\{\mathtt{Read} , \mathtt{Write} , \mathtt{Edit} , \mathtt{Bash} , \mathtt{Glob} , \mathtt{Grep} , \mathtt{TodoWrite}\right\}
|
||||
$$
|
||||
|
||||
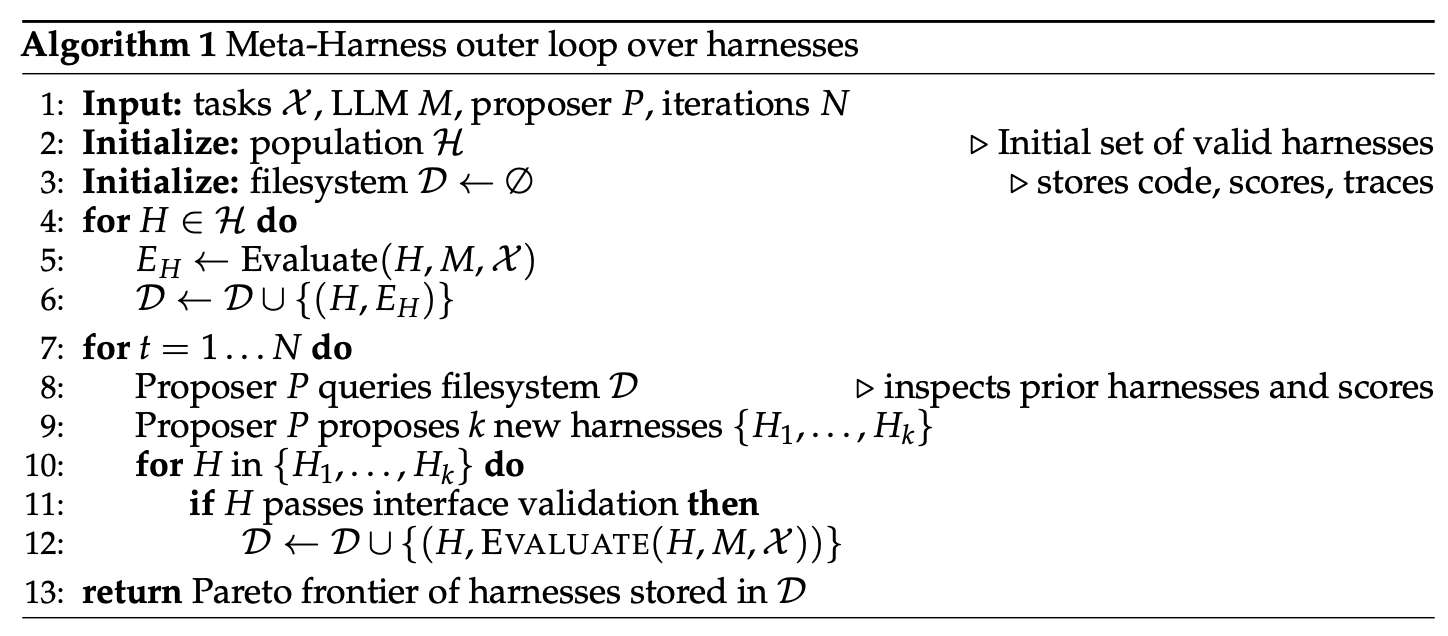
**Meta-Harness** ([Lee et al. 2026](https://arxiv.org/abs/2603.28052)) moves another level deeper: the optimized object is the *code* that determines and optimizes what information should be stored, retrieved, and presented to the model. “Meta-” in its name means it is a harness for optimizing harnesses.
|
||||
|
||||
|
||||
|
||||
The Meta-Harness outer-loop optimization algorithm. (Image source: Lee et al. 2026 )
|
||||
|
||||
The proposer for creating a new harness is itself a coding agent and the final output is a collection of harness candidates on the Pareto frontier.
|
||||
|
||||
- The entire execution history is accessible via a file system, and thus the coding agent uses commands like `grep` or `cat` to read through it instead of shoveling everything into a single prompt context.
|
||||
- The proposed harness is a dictionary in the file system containing its own source code, scores, rollout trajectories, and state updates.
|
||||
- The mete-harness loop iteratively creates new harnesses, and only qualified ones are kept.
|
||||
|
||||
|
||||
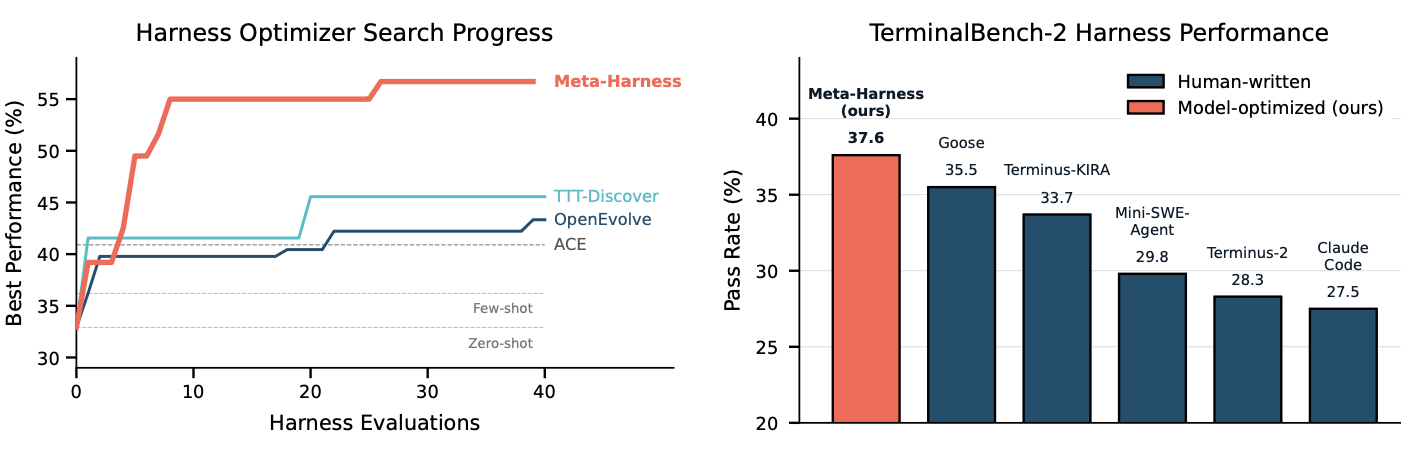
The performance of Meta-Harness on (Left) text classification with a small number of iterations and (Right) TerminalBench-2. Note that the search in the TerminalBench-2 experiment is initialized from Terminus-KIRA and Terminus-2, two very strong harnesses. (Image source: Lee et al. 2026 )
|
||||
|
||||
Still, the important lesson is clear: once harness design becomes an executable search space, a strong coding agent can exploit the same design space human engineers use.
|
||||
|
||||
## Workflow Design
|
||||
|
||||
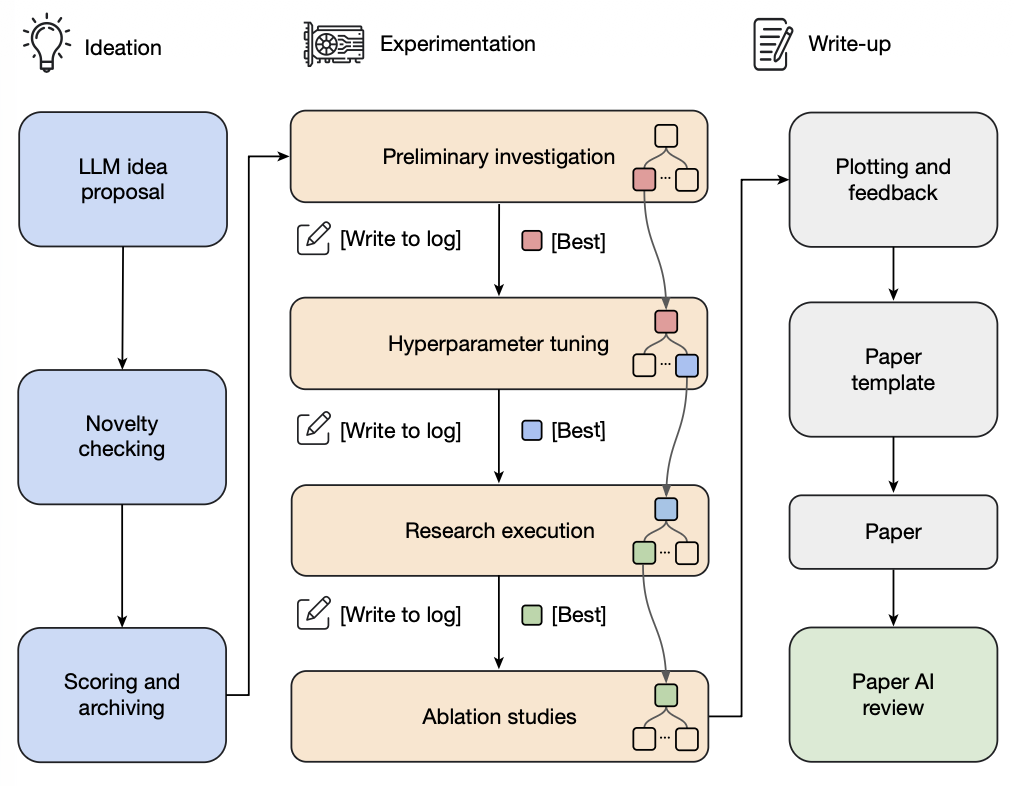
Workflow design in harness engineering can be handcrafted by domain experts. Taking auto-research as an example, various frameworks have been proposed and tested. The **AI Scientist** system ([Lu et al. 2026](https://www.nature.com/articles/s41586-026-10265-5)) builds a pipeline to propose research ideas, write code, run experiments, analyze results, write a manuscript, and perform peer review. [Meng et al. (2026)](https://arxiv.org/abs/2605.26340) make verifiability the central design constraint in **ScientistOne**, where every claim (citation, numerical, methodological, conclusion) must trace to an evidence source and is audited by Chain-of-Evidence checks.
|
||||
|
||||
|
||||
|
||||
AI Scientist pipeline for idea generation, experimentation, paper writing, and review. (Image source: Lu et al. 2026 )
|
||||
|
||||
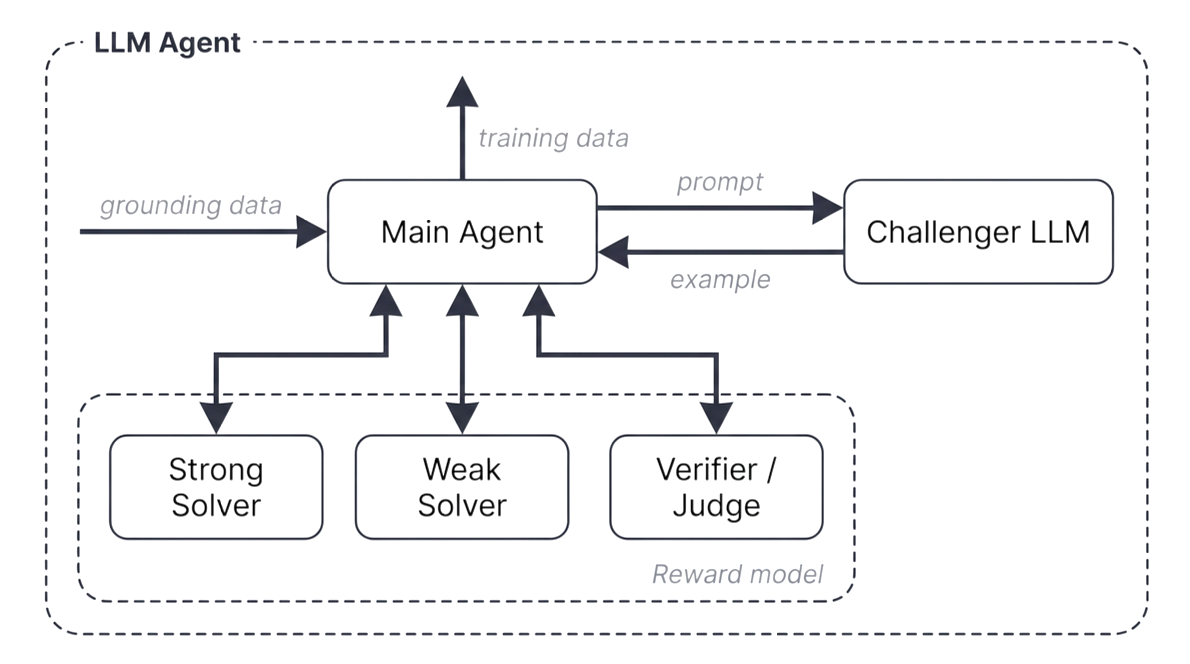
The **Autodata** agent ([Kulikov et al. 2026](https://arxiv.org/abs/2606.25996)) is designed to work as a data scientist for generating training and evaluation data. The main agent manages a *challenger* that proposes problems, a *weak solver*, a *strong solver*, and a *verifier/judge*, aiming to synthesize data at the “just right” level of difficulty, meaning that the strong solver succeeds but the weak solver fails.
|
||||
|
||||
In Autodata, the challenger prompt is updated iteratively according to feedback from the solvers and verifier. The limitation here is that synthesized tasks are used to fine-tune weak solvers but not strong solvers; if the loop cannot iteratively improve the strong model, it is more like indirect distillation over a generated prompt distribution, with less RSI flavor.
|
||||
|
||||
|
||||
|
||||
Autodata agentic workflow design for generating synthetic training and evaluation data around challenger, solver, and verifier roles. (Image source: Kulikov et al. 2026 )
|
||||
|
||||
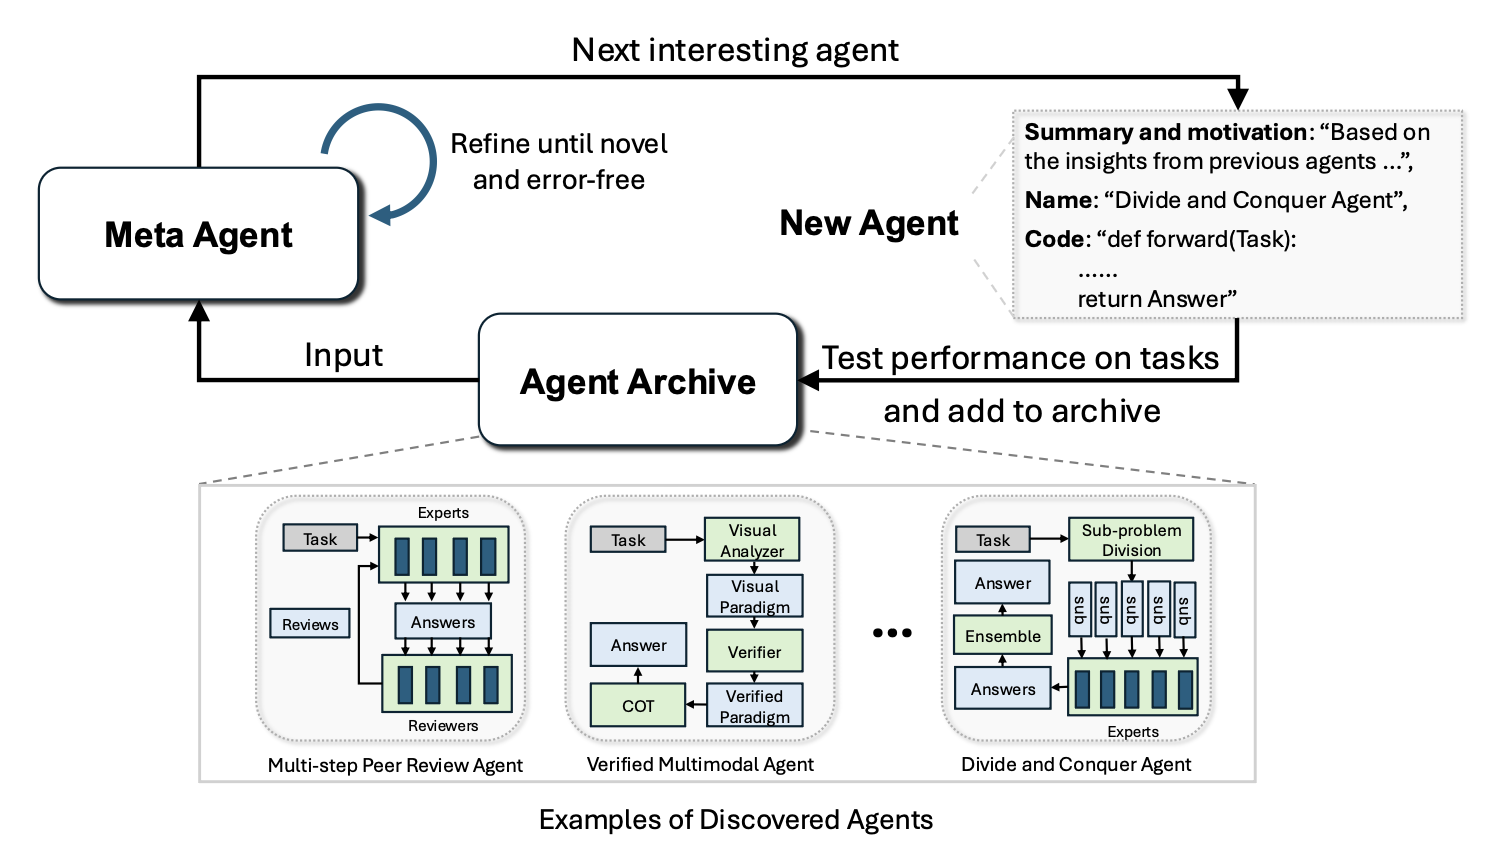
The design space for workflow is *enormous*, and naturally we can think of workflow design as a search problem, and therefore we should be able to find good solutions by algorithms rather than only manually craft them. Following this direction, **Automated Design of Agentic Systems** (ADAS; [Hu et al. 2025](https://arxiv.org/abs/2408.08435)) formulates agent design itself as an optimization problem, “meta-agent search” where a meta-agent proposes new designs of agentic workflows.
|
||||
|
||||
1. Initialize an archive of agentic workflows with simple agents such as CoT and self-refine.
|
||||
2. Ask a meta-agent to program new agents, all in *code*, inspired by existing solutions in the archive.
|
||||
- The meta-agent first generates a high-level description of the new workflow, and then implements it in code.
|
||||
- The draft program then goes through two self-refine steps (i.e. ask the model to provide feedback and then ask the same model to refine the previously generated outputs based on the feedback; [Madaan et al. 2023](https://arxiv.org/abs/2303.17651)) by the meta-agent to check its novelty.
|
||||
3. Evaluate each new candidate and add successful ones back to the archive.
|
||||
4. Repeat steps 2-3 until the maximum iteration count is reached.
|
||||
|
||||
|
||||
Illustration of Automated Design of Agentic Systems (ADAS). (Image source: Hu et al. 2025 )
|
||||
|
||||
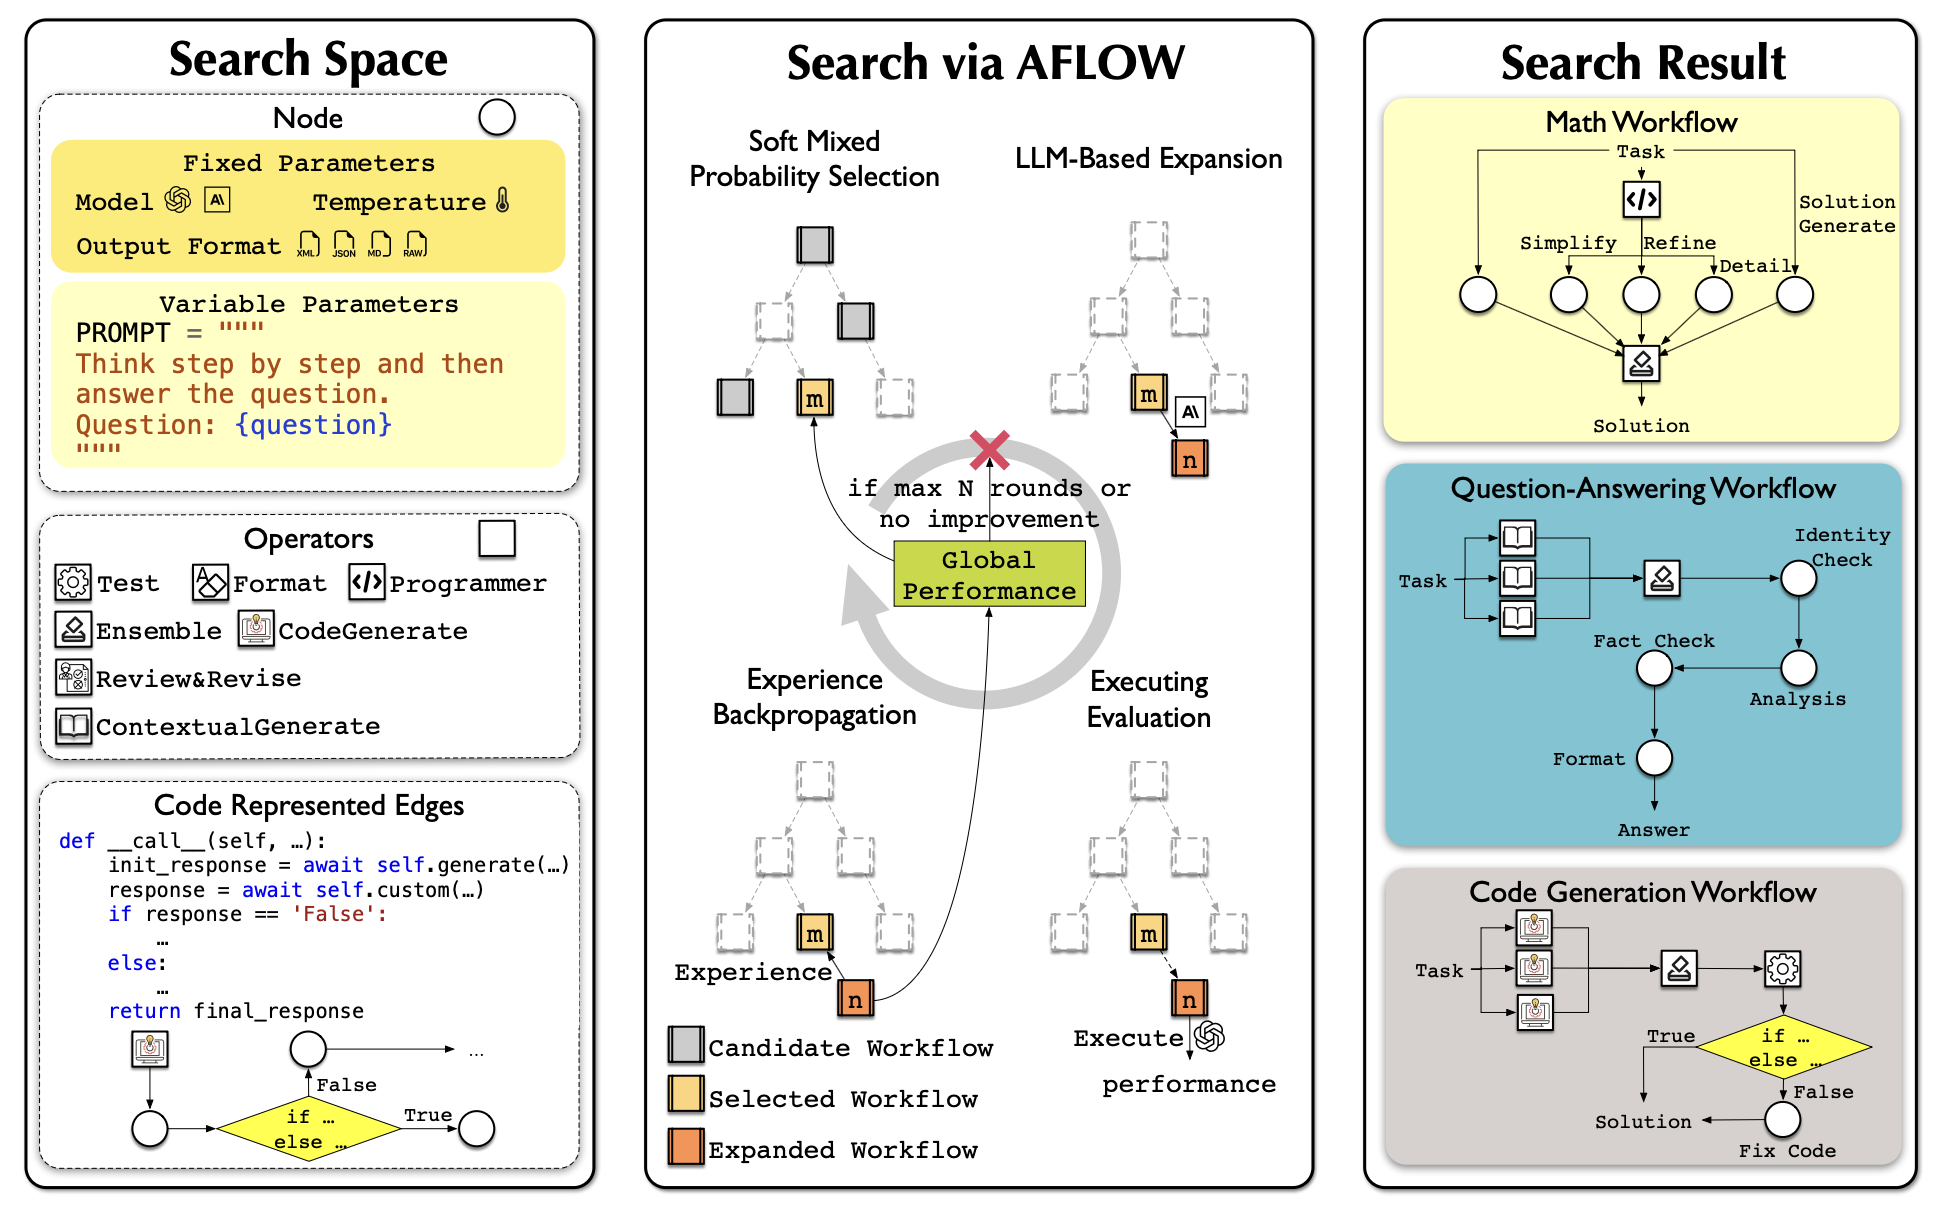
**AFlow** ([Zhang et al. 2025](https://arxiv.org/abs/2410.10762)) represents an agentic workflow as a graph, where nodes represent LLM-invoking actions and edges implement logical operations in code. The workflow optimization relies on [MCTS](https://en.wikipedia.org/wiki/Monte_Carlo_tree_search) (Monte Carlo Tree Search):
|
||||
|
||||
1. Initialize the starting workflow $W_{0}$ in the tree with a template.
|
||||
2. Select a workflow node using a soft mixture of score and uniform exploration.
|
||||
3. Expand it by asking an LLM to produce a modified workflow conditioned on its evaluation performance.
|
||||
4. Execute and evaluate the new workflow.
|
||||
5. Add it back to the tree if the new workflow shows improvement within a budget of $N$ rounds.
|
||||
6. Repeat steps 2-5 and stop when the top- $k$ average score plateaus or hit the budget.
|
||||
|
||||
|
||||
AFlow optimization process over a tree of workflow candidates. (Image source: Zhang et al. 2025 )
|
||||
|
||||
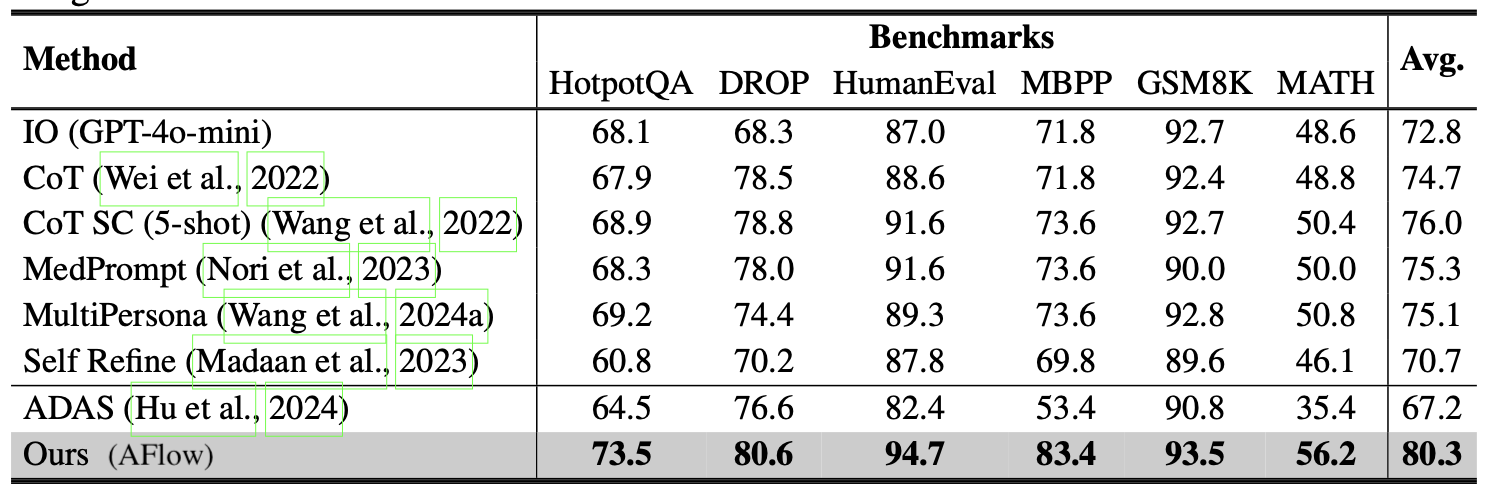
Experiments of AFlow in QA, code, and math tasks showed decent improvement of AFlow over manually designed workflows and ADAS.
|
||||
|
||||
|
||||
|
||||
AFlow experiments in comparison to manual methods and ADAS. (Image source: Zhang et al. 2025 )
|
||||
|
||||
## Self-Improving Harness
|
||||
|
||||
Either context engineering or workflow design is only one part of a harness. We need to search through the entire design space and optimize context-management logic, workflow, permissions, and many other harness components together. As we have seen in work like Meta-Harness, ADAS, and AFlow, **✨code✨** is a **universal language** for defining programs and systems. In simple words, a harness is code that programs how prompts, tool calls, subagents, control flow, memory, and workflow logic work together. If an LLM can optimize the code that executes agents, it can access a *much larger design space* than hand-written prompts.
|
||||
|
||||
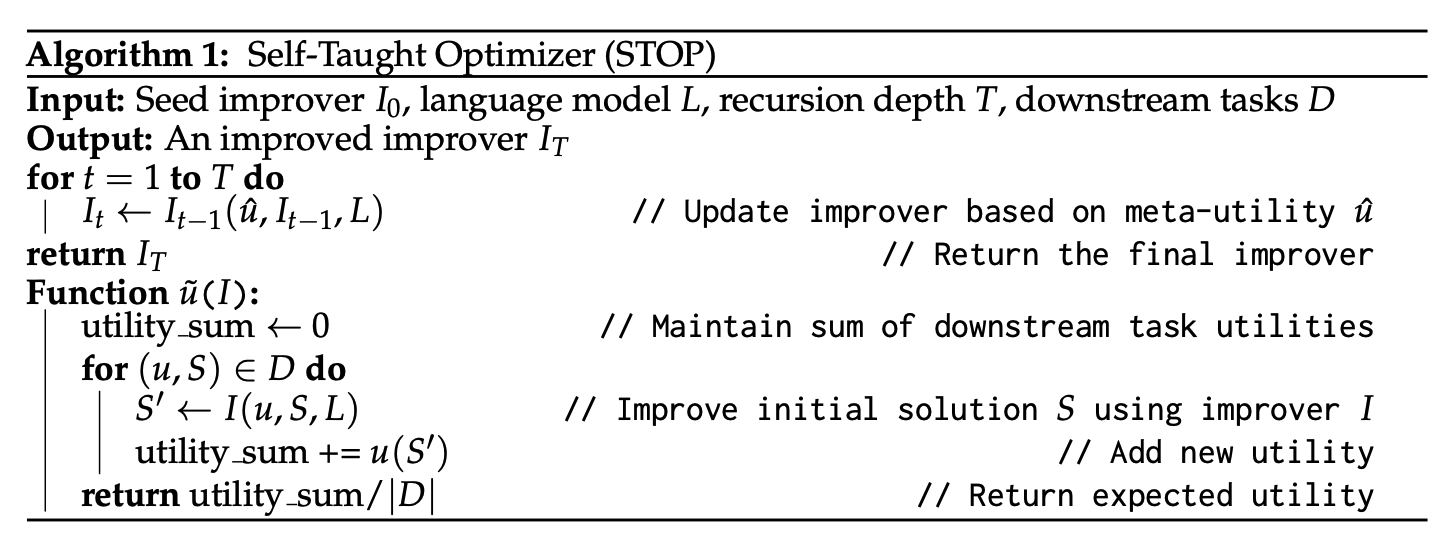
**Self-Taught Optimizer** (STOP; [Zelikman et al. 2023](https://arxiv.org/abs/2310.02304)) is one of the early examples of recursive scaffolding improvement. A seed improver $I_{0}$ at step $t = 0$ takes an initial solution $s$, a utility function $u$, and a black-box language model $M$, and returns an improved solution $s^{'}$, that is, $s^{'} = I \left(u , s ; M\right)$. The goal of STOP is not directly to improve $s$ but *to improve the improver $I$ itself*.
|
||||
|
||||
First, let’s define the meta-utility as the average utility of a given improver function $I$ over a collection of downstream tasks $\mathcal{D}$:
|
||||
|
||||
$$
|
||||
\hat{u} \left(I\right) \triangleq \frac{1}{\left|\mathcal{D}\right|} \mathbb{E}_{\left(u , s\right) \sim \mathcal{D}} \left[u \left(I \left(u , s ; M\right)\right)\right]
|
||||
$$
|
||||
|
||||
Because improving the improver function is an optimization problem itself, we can recursively get a new version of $I_{t}$ based on $I_{t - 1}$ ’s performance measured by meta-utility via a self-improvement update:
|
||||
|
||||
$$
|
||||
I_{t} = I_{t - 1} \left(\hat{u} , I_{t - 1} ; M\right)
|
||||
$$
|
||||
|
||||
|
||||
Algorithm of Self-Taught Optimizer (STOP). (Image source: Zelikman et al. 2023 )
|
||||
|
||||
In Zelikman et al. (2023)’s experiments, the improved improver discovered various strategies, such as genetic algorithms, decomposing and improving parts, multi-armed prompt bandits, simulated annealing, varying temperature, and beam/tree search. This is analogous to how a harness workflow can be represented as an object for optimization.
|
||||
|
||||
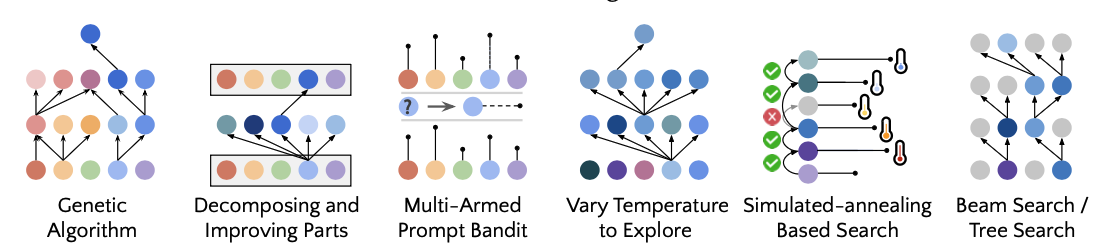
|
||||
|
||||
Examples of self-improvement strategies discovered by STOP. (Image source: Zelikman et al. 2023 )
|
||||
|
||||
A *cautionary* result in their findings is that STOP improved mean downstream performance across iterations with GPT-4 but degraded with weaker models like GPT-3.5 and Mixtral. Recursive structure alone is not enough. The base model must be *capable enough* to improve the mechanism. This implies that harness improvement enables better deployment of the model but intelligence is still the core.
|
||||
|
||||
A more recent work, **Self-Harness** ([Zhang et al. 2026](https://arxiv.org/abs/2606.09498)), relies on LLM agents to improve their own harness via a propose-evaluate-accept loop.
|
||||
|
||||
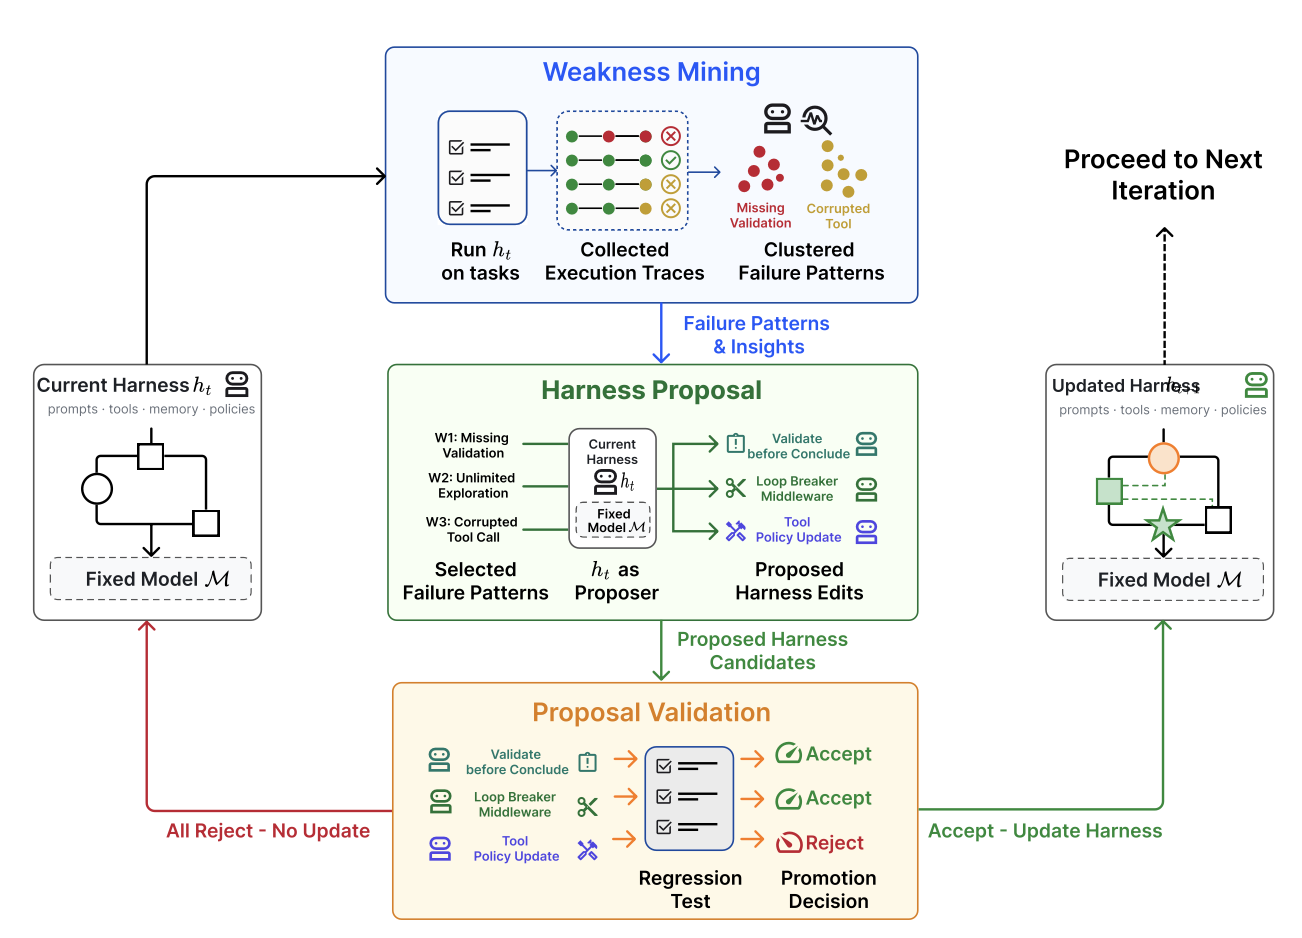
|
||||
|
||||
Self-Harness uses a loop of weakness mining, bounded harness proposal, and validation to update a harness. (Image source: Zhang et al. 2026 )
|
||||
|
||||
The loop in Self-Harness has three stages:
|
||||
|
||||
1. *Weakness mining*: cluster failures into verifier-grounded failure patterns.
|
||||
- The current harness $h_{t}$ is used to evaluate on tasks and execution traces are collected for analysis.
|
||||
- Note that two runs can share the same verifier outcome in the error logs on the surface, such as timeout or missing artifact, while having different causal mechanisms. Therefore we need a failure record of rich information, containing the terminal verifier-level cause, the causal status of the relevant agent behavior, and the abstract agent mechanism exposed by the trace, to uncover the root causes.
|
||||
2. *Harness proposal*: propose bounded harness edits based on mined failure patterns.
|
||||
- The same model is invoked under $h_{t}$ as a proposer.
|
||||
- The model is provided with a bounded proposal context: (1) the editable surfaces of the current harness, (2) the verifier-grounded failure patterns from the evaluation system, (3) records of passing behaviors that should be preserved, and (4) summaries of previously attempted edits.
|
||||
- Harness edits should prefer recurrent error patterns that are addressable (e.g. not task-specific difficulty) and can be resolved by narrow changes.
|
||||
- Harness edit candidates should be distinct and diverse.
|
||||
3. *Proposal validation*: validate and merge qualified edits to create a new harness $h_{t + 1}$.
|
||||
- Candidate edits are evaluated by regression tests on held-in $D_{\text{in}}$ (for testing whether the weakness is resolved) and held-out $D_{\text{out}}$ (for checking whether other unknown issues were introduced) splits.
|
||||
- Candidates are accepted only if they have no regression on both held-in and held-out data.
|
||||
- Accepted candidates are merged to update the harness to $h_{t + 1}$, while rejected candidates are logged without changing the active harness.
|
||||
|
||||
When running `MiniMax M2.5`, `Qwen3.5-35B-A3B`, and `GLM-5` on Terminal-Bench-2, Self-Harness was shown to learn model-specific harness instructions that target at different weaknesses of different base models and improve held-out pass rates.
|
||||
|
||||
Self-harness type of work does raise my concerns that if a program is allowed to edit the OS system, abstraction boundaries are broken. The editable surface needs to be properly designed and the permission control and security layers need to live outside this loop. All the challenges around [reward hacking](https://lilianweng.github.io/posts/2024-11-28-reward-hacking/) still remain.
|
||||
|
||||
## Evolutionary Search
|
||||
|
||||
Evolutionary search is an optimization method inspired by natural selection (see my old post on [evolutionary algorithm](https://lilianweng.github.io/posts/2019-09-05-evolution-strategies/)). It evolves a population of solutions by mutating them and only keeping those with high “fitness” in the crowd. Evolutionary search comes in handy when (1) the search space is extensive or weirdly shaped; and (2) it is hard to optimize directly with gradients but easy to evaluate solutions. Harness search seems to be a good fit here.
|
||||
|
||||
Evolutionary search has been used in prompt engineering in the past studies. **Promptbreeder** ([Fernando et al. 2023](https://arxiv.org/abs/2309.16797)) optimizes task-specific prompts through a rich set of mutation operations, and interestingly the mutation prompts (i.e. instructions to an LLM to mutate a task prompt) are themselves also improved through evolution. **GEPA** ([Agrawal et al. 2025](https://arxiv.org/abs/2507.19457)) combines [reflection](https://lilianweng.github.io/posts/2023-06-23-agent/#self-reflection) -based prompting with evolutionary search and uses natural language reflection over trajectories of trial and error to propose prompt updates.
|
||||
|
||||
[Novikov et al. (2025)](https://arxiv.org/abs/2506.13131) introduced **AlphaEvolve** as a coding-agent evolutionary search system, which stores a pool of candidate programs and prompts frozen LLMs to generate diffs for improvement. As the system repeatedly evaluates child programs and keeps successful ones, it discovers better solutions in time.
|
||||
|
||||
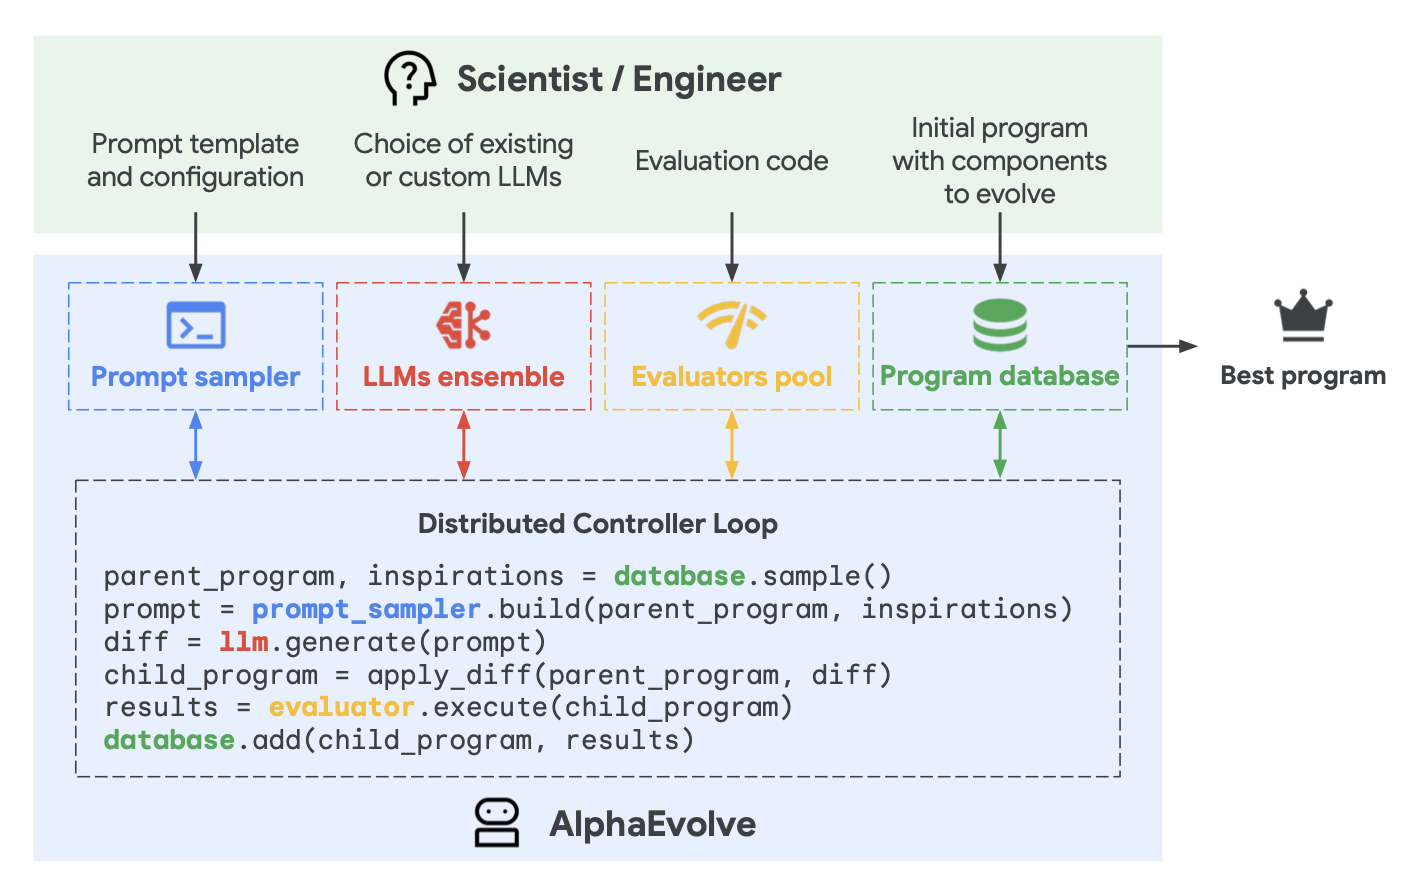
|
||||
|
||||
How AlphaEvolve works. (Image source: Novikov et al. 2025 )
|
||||
|
||||
A few details matter in the design of AlphaEvolve:
|
||||
|
||||
- The prompt includes parent programs, results, instructions, and sometimes meta information.
|
||||
- The coding agent has access to the full repo, but code regions for improvement are explicitly marked with `# EVOLVE-BLOCK-START` and `# EVOLVE-BLOCK-END`.
|
||||
- Meta-prompt co-evolves with instructions and context as suggested by LLM, in a similar way as how we evolve solution programs.
|
||||
|
||||
Ablations show the evolution procedure, context in prompts, meta-prompts, full-file evolution and the use of stronger LLMs.
|
||||
|
||||
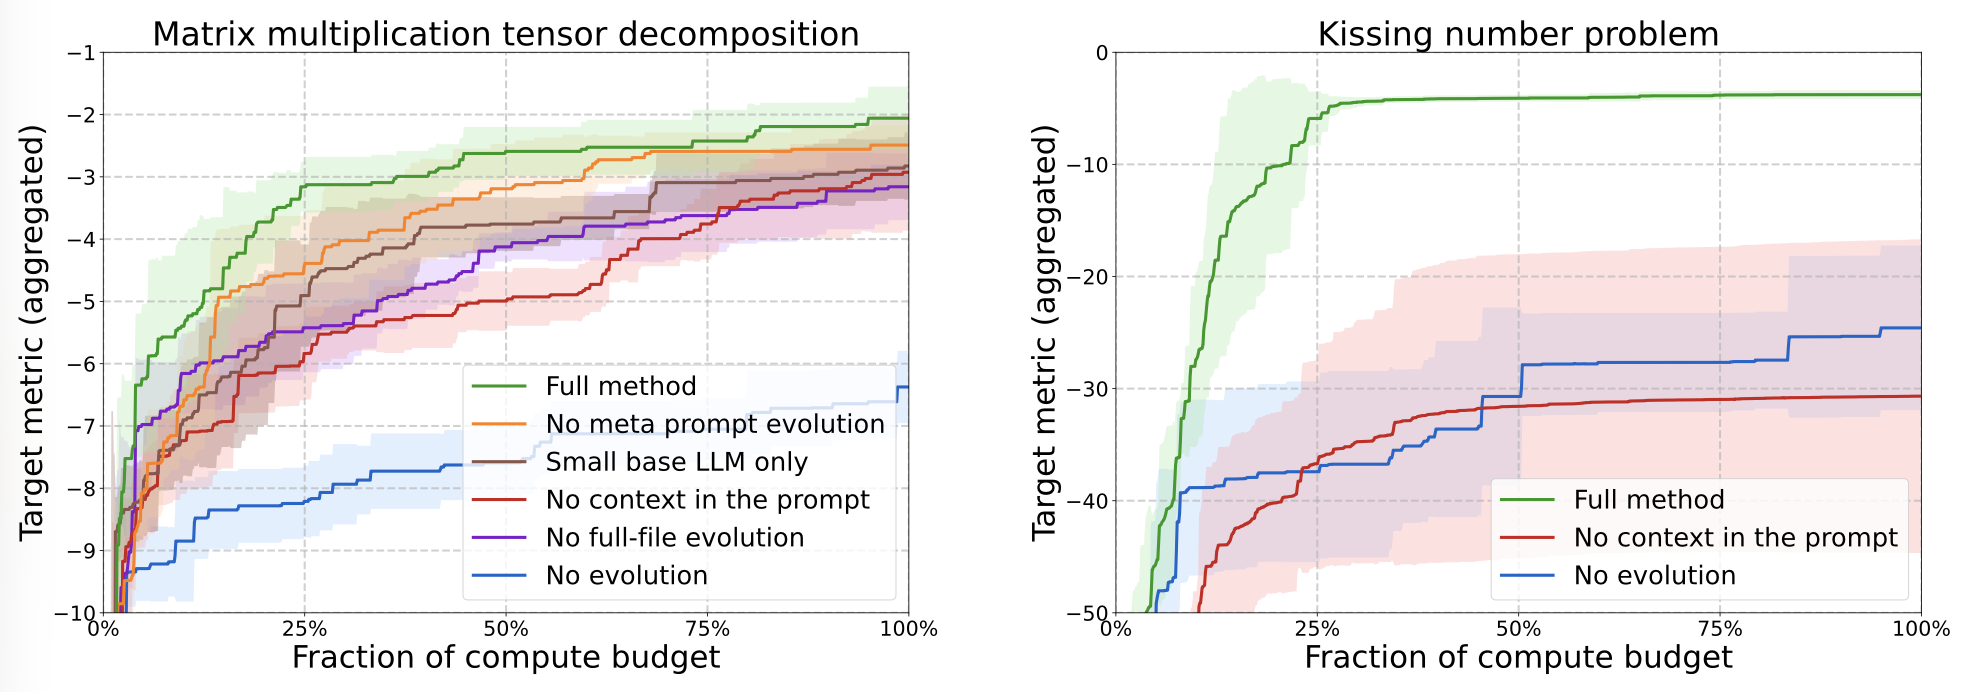
|
||||
|
||||
Ablations show the value of everal designs in AlphaEvolve. (Image source: Novikov et al. 2025 )
|
||||
|
||||
Recent variants such as **ThetaEvolve** ([Wang et al. 2025](https://arxiv.org/abs/2511.23473)) combines evolutionary search with RL and in-context learning. **ShinkaEvolve** ([Lange et al. 2025](https://arxiv.org/abs/2509.19349)), on the other hand, introduced three new components to improve LLM sampling efficiency:
|
||||
|
||||
- More sample-efficient exploration by designing parent sampling to balance performance rank and offspring count.
|
||||
- Code-novelty rejection sampling by discarding candidates that are too similar to the existing population based on embedding-based cosine similarity.
|
||||
- Identifying good patterns in successful solutions in a meta-scratchpad to guide future mutation.
|
||||
|
||||
Unlike the methods above, which focus on solution improvement, **Darwin Gödel Machine** (DGM; [Zhang et al. 2025](https://arxiv.org/abs/2505.22954)) explicitly targets the evolution of an editable harness-code repository with an LLM-based coding agent. Precisely, this agent is allowed to modify its own harness. A follow-up work on Hyperagents ([Zhang et al. 2026](https://arxiv.org/abs/2603.19461)) introduced a meta-agent to control how to modify existing task agents to create new ones.
|
||||
|
||||
1. Start with one coding agent in the pool.
|
||||
2. In each iteration, pick one parent with a probability proportional to its performance and inversely to the number of children it has, to modify and branch off to produce new agents.
|
||||
3. The selected parent agent examines its own benchmark evaluation log and then proposes improvements to its own harness codebase to generate a new version of the coding agent. Code editing is implemented with two basic tools: (1) bash (args: `<bash_command>`) and (2) editor (args: `view/create/edit <file_path>`).
|
||||
4. New coding agents are evaluated, and only those with sufficiently high performance are added back into the pool.
|
||||
5. Repeat steps 2-4 until some stop criteria hit.
|
||||
|
||||
DGM is harness evolution under a fixed model. In experiments with `Claude 3.5 Sonnet` as the base LLM and simple initial harness configs, the DGM-discovered agents are comparable to or outperform handcrafted agents on SWE-bench Verified (20% to 50%) and Polyglot (14.2% to 30.7%).
|
||||
|
||||
This family of methods works well when candidate solutions are automatically evaluable and candidate fitness is easy to quantify, such as matrix multiplication, GPU kernel optimization, algorithm contests, datacenter scheduling. It struggles with domains where evaluation is slow, ambiguous, or mostly heuristic-based. The compute efficiency and effectiveness of evolution are also concerns.
|
||||
|
||||
## Joint Optimization with Model Weights
|
||||
|
||||
Harness evolution changes the non-parametric system around the model. To enable full self-improvement, the model can totally be allowed to update its own weights at the same time. The weight update can be implemented via improvements in the model training pipeline or continual learning at test time. The topic of continual learning is worthy of its own post in the future.
|
||||
|
||||
**SIA** ([Hebbar et al. 2026](https://arxiv.org/abs/2605.27276)) is an early attempt to combine harness improvement and model-parameter updates in the same optimization loop, with three components in the design:
|
||||
|
||||
- *Meta-Agent*: proposes the initial harness.
|
||||
- *Task-Specific Agent*: executes the task.
|
||||
- *Feedback-Agent*: chooses whether to update the harness or the model weights based on recent trajectories.
|
||||
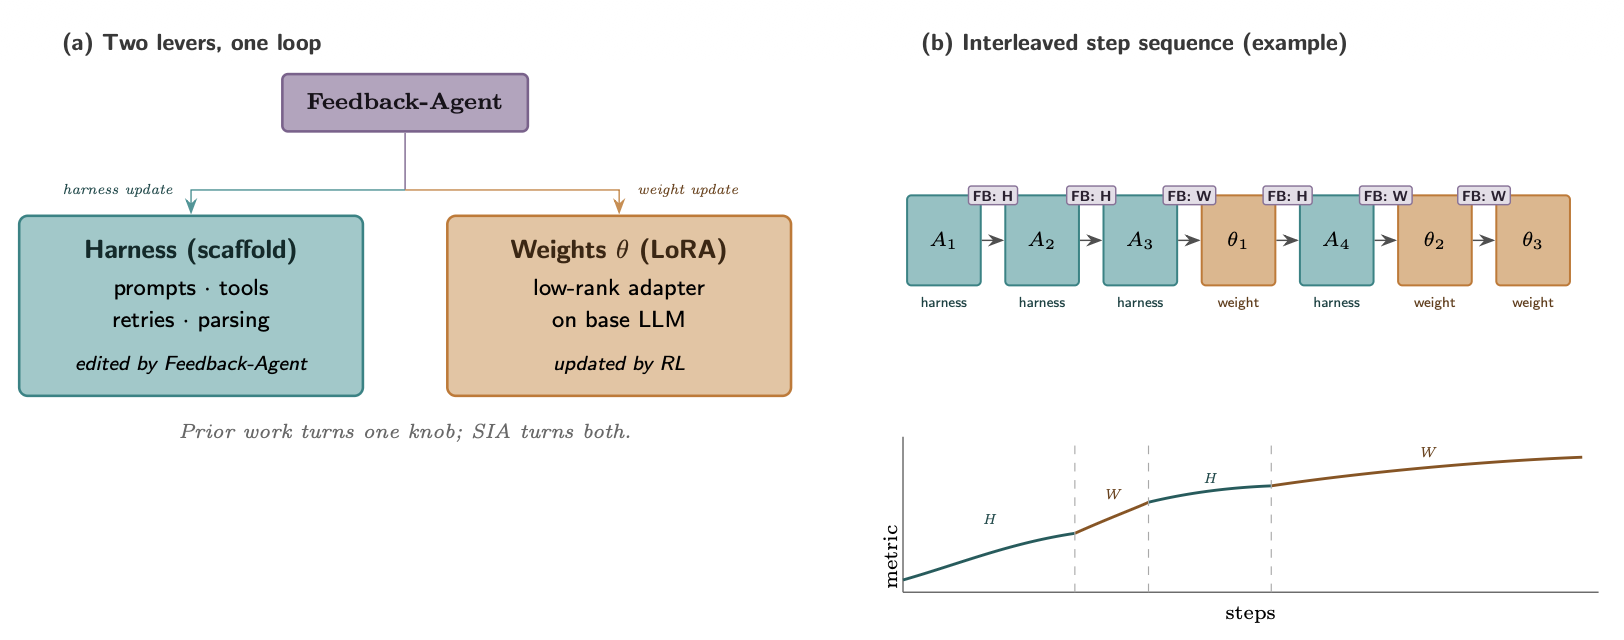
|
||||
|
||||
The Feedback-Agent in SIA decides the next iteration type. (Image source: Hebbar et al. 2026 )
|
||||
|
||||
There are a few confounding choices in SIA’s experiments that make the results hard to interpret. For example, the task-specific agent is much weaker than the models used for the Meta-Agent and Feedback-Agent (`gpt-oss-120b` vs `Claude Sonnet 4.6`), and the baselines are too weak to cross-reference cleanly against related methods. I would consider the direction interesting, but the evidence provisional. Yet many challenges, such as training stability and Goodhart effect, still remain open.
|
||||
|
||||
## Future Challenges
|
||||
|
||||
The AI Scientist line of work is a strong demonstration that an expert-designed harness can coordinate a large portion of auto-research loop, experimented in the form of writing research papers. But paper production is not identical to scientific discovery. A system can write a plausible manuscript while still having fabricated citations, implementation drift, or weak experimental results.
|
||||
|
||||
[Trehan & Chopra (2026)](https://arxiv.org/abs/2601.03315) tested whether LLMs can go from a research idea to a paper with minimal scaffolding and basic tools (i.e., `read_file`, `write_file`, `llm_search`, `list_files`). Each idea had a dedicated workspace where agents could generate and read documents as part of context. They experimented in three domains (world models, multi-agent RL, AI safety & alignment), with each domain containing 45-50 high-quality seed documents to inspire new ideas. Only four ideas were selected by human experts to run through the full pipeline, and only one was fully executed into a paper. They observed six recurring failure modes in the experiments:
|
||||
|
||||
- *Bias toward training-data defaults*: use old libraries, stale commands, standard formats, or assumptions not grounded in the actual repository or dataset.
|
||||
- *Implementation drift under execution pressure*: when implementation becomes technically complex, the model may move toward a common simpler solution rather than the proposed method.
|
||||
- *Memory and context degradation*: long-horizon projects lose critical details unless logs are written as persistent artifacts.
|
||||
- *Over-optimism*: the model declares success despite noisy or failed experiments, similarly observed as “p-hacking and eureka-ing” pattern by [Bubeck et al. (2025)](https://arxiv.org/abs/2511.16072) where models can introduce “numerical duct tape” and declare victory when signals are still noise.
|
||||
- *Insufficient domain intelligence*: the model lacks tacit craft knowledge, e.g. predicting implementation complexity, judging whether an experimental result is plausible, or knowing which baselines matter.
|
||||
- *Weak scientific taste*: experiments may be executable but fail to answer the right question.
|
||||
|
||||
Toward full RSI, researchers have made real progress, but several bottlenecks remain.
|
||||
|
||||
**1\. Weak and fuzzy evaluators.** Many research claims do not have a fast and precise verifier, and the same is true for many real-world tasks. Current self-improvement loops work best for tasks when evaluation metrics are measurable and objective, similar as [how RL works](https://lilianweng.github.io/posts/2018-02-19-rl-overview/).
|
||||
|
||||
Research taste, novelty, and long-term scientific value are much harder to measure. For example, research taste often mixes problem framing, experimental design, and judgment about which surprising results are worth pursuing and which failure cases are worth retries.
|
||||
|
||||
**2\. Context and memory lifecycle.** Memory grows as AI agents become more autonomous and independent. A useful harness needs to manage context and memory to complement existing limitation in long-context generation while still maximizing the success of long-horizon tasks. Since humans are able to maintain memory through our life time, I see an anoloy here that [context engineering](#context-engineering) will and should become a core part of intelligence, rather than staying in the software system layer.
|
||||
|
||||
**3\. Negative results.** Researchers are incentivized to publish successful results and thus literature is biased toward successes. LLMs trained on a vast amount of data (mostly human created, at least for now, lol) may be bad at deciding when to abandon a hypothesis, report a negative result, or even acknowledge a failure due to the imablance of success vs failure cases in data. A research harness should make failed attempts easy to preserve, as learning from failure is the best way to trim down the task search space.
|
||||
|
||||
**4\. Diversity collapse.** Evolutionary and RL loops tend to exploit known high-reward patterns. We need [mechanisms](https://lilianweng.github.io/posts/2020-06-07-exploration-drl/) to prevent the population from collapsing into variants of the same solution. This is especially critical for open-ended research, where the best path may initially look worse under the current evaluator.
|
||||
|
||||
**5\. [Reward hacking](https://lilianweng.github.io/posts/2024-11-28-reward-hacking/).** A self-improvement loop optimizes whatever signal it is given. If the reward comes from unit tests, the agent may overfit to tests; if it comes from a judge model, it may learn reward hacking tricks specific to this judge; if it comes from benchmark scores, it may exploit benchmark artifacts.
|
||||
|
||||
The evaluator and permission control should likely sit outside the loop that evolves harness, with held-out tests, trace audits, and human review at decision points that matter—how much oversight can be scaled up and automated remains an open research area.
|
||||
|
||||
**6\. Long-term success.** An extrinsic loop of optimization works on rewards outside of individual rollouts that we can simulate in training sandbox.
|
||||
|
||||
Take coding agent as an example. Coding agents have already increased daily productivity in software engineering, but many optimization goals are still too short-term. It can often complete the task at hand, but less obvious how it should protect the long-term health of a repo collectively maintained by hundreds or thousands of engineers. Standard sandbox-based RLVR-style training rarely captures maintainability, ownership boundaries, migration cost, backwards compatibility, or future debugging burden.
|
||||
|
||||
**7\. The role of humans.** Humans should move up the stack, not be removed from the loop, meaning that human should provide oversight at the right time, at the right abstraction level and our system design should consider when and how to set up such touch points.
|
||||
|
||||
Many challenges listed above need human’s feedback and steering. After all, we are building the technology for better future of humanity, not other way around.
|
||||
|
||||
## Citation
|
||||
|
||||
Please cite this work as:
|
||||
|
||||
> Weng, Lilian. “Harness Engineering for Self-Improvement”. Lil’Log (Jul 2026). https://lilianweng.github.io/posts/2026-07-04-harness/
|
||||
|
||||
Or use the BibTeX citation:
|
||||
|
||||
```
|
||||
@article{weng2026harness,
|
||||
title = {Harness Engineering for Self-Improvement},
|
||||
= {Weng, Lilian},
|
||||
journal = {lilianweng.github.io},
|
||||
year = {2026},
|
||||
month = {July},
|
||||
url = "https://lilianweng.github.io/posts/2026-07-04-harness/"
|
||||
}
|
||||
```
|
||||
|
||||
## Appendix: Some useful benchmarks
|
||||
|
||||
- **[PaperBench](https://arxiv.org/abs/2504.01848)**: replicate 20 ICML 2024 Spotlight and Oral papers from scratch, including understanding paper contributions, developing a codebase, and successfully executing experiments.
|
||||
- Each replication task is decomposed into smaller, individually gradable tasks.
|
||||
- 8,316 rubrics in total, co-developed with the paper authors.
|
||||
- The best model at the time (`Claude 3.5 Sonnet`, ~21%) does not outperform ML PhDs.
|
||||
- Includes PaperBench, PaperBench Code-Dev (a lighter version), and JudgeEval.
|
||||
- **[CORE-Bench](https://arxiv.org/abs/2409.11363)**: evaluate computational reproducibility of published research.
|
||||
- 270 tasks based on 90 scientific papers across computer science, social science, and medicine.
|
||||
- Tasks involve reproducing results from provided code and data.
|
||||
- Includes multiple difficulty levels and both language-only and vision-language tasks.
|
||||
- The best reported agent at the time (`GPT-4o` and `GPT-4o-mini`) achieved only 21% accuracy on the hardest task.
|
||||
- **[ScienceAgentBench](https://arxiv.org/abs/2410.05080)**: evaluate LLM agents for data-driven scientific discovery.
|
||||
- Extracts 102 tasks from 44 peer-reviewed publications in four disciplines (math, chemistry, biology, geography).
|
||||
- Covers basic data-science tasks in these domains: data processing, model development, data analysis, and information visualization.
|
||||
- **[RE-Bench](https://arxiv.org/abs/2411.15114)**: evaluate frontier AI agents on realistic ML research-engineering envs against human experts.
|
||||
- 7 challenging, open-ended ML research-engineering environments.
|
||||
- Each environment = (scoring function, starting solution, reference solution); each can be run with 8 or fewer H100 GPUs.
|
||||
- Examples: optimize a kernel, run a scaling-law experiment, fix an embedding, fine-tune GPT-2 for QA, etc.
|
||||
- Includes data from 71 eight-hour attempts by 61 distinct human experts.
|
||||
- Human experts achieved non-zero score in 82% of 8-hour attempts; 24% matched or exceeded strong reference solutions.
|
||||
- Best AI agents scored 4× higher than humans at a 2-hour budget, but humans had better returns to longer budgets and exceeded agents at 8-hour and 32-hour settings.
|
||||
- **[MLE-bench](https://arxiv.org/abs/2410.07095)**: evaluate ML engineering agents on offline Kaggle competitions.
|
||||
- Contains 75 ML-engineering competitions curated from Kaggle.
|
||||
- Tests training models, preparing datasets, running experiments, and submitting predictions to grading scripts.
|
||||
- Uses Kaggle public leaderboards as human baselines.
|
||||
- Best setup in the paper, `o1-preview` with AIDE scaffolding, reached at least Kaggle bronze-medal level in 16.9% of competitions.
|
||||
- Includes resource-scaling and contamination analyses.
|
||||
- **[KernelBench](https://arxiv.org/abs/2502.10517)**: evaluate correctness and speed for generated GPU kernels.
|
||||
- 250 PyTorch tasks to evaluate whether LLM can write fast and correct kernels.
|
||||
- The evaluation metric fast\_p = the percentage of generated kernels that are correct and faster than baseline.
|
||||
|
||||
## References
|
||||
|
||||
\[1\] Good, I. J. [“Speculations Concerning the First Ultraintelligent Machine.”](https://philpapers.org/rec/GOOSCT) *Advances in Computers*, 6:31–88, 1965.
|
||||
|
||||
\[2\] Yudkowsky, Eliezer. [“Recursive Self-Improvement.”](https://www.lesswrong.com/posts/JBadX7rwdcRFzGuju/recursive-self-improvement) LessWrong, 2008.
|
||||
|
||||
\[3\] Choi, et al. [“Anchored Self-Play for Code Repair.”](https://openreview.net/forum?id=lTbBFAoPSA) ICML 2026.
|
||||
|
||||
\[4\] Zhao, et al. [“Absolute Zero: Reinforced Self-play Reasoning with Zero Data.”](https://arxiv.org/abs/2505.03335) arXiv preprint arXiv:2505.03335, 2025.
|
||||
|
||||
\[5\] Yuan, et al. [“Self-Rewarding Language Models.”](https://arxiv.org/abs/2401.10020) arXiv preprint arXiv:2401.10020, 2024.
|
||||
|
||||
\[6\] Chen, et al. [“Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models.”](https://arxiv.org/abs/2401.01335) ICML 2024.
|
||||
|
||||
\[7\] Zhang, et al. [“Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models.”](https://arxiv.org/abs/2510.04618) ICLR 2026.
|
||||
|
||||
\[8\] Ye, et al. [“Meta Context Engineering via Agentic Skill Evolution.”](https://arxiv.org/abs/2601.21557) arXiv preprint arXiv:2601.21557, 2026.
|
||||
|
||||
\[9\] Lee, et al. [“Meta-Harness: End-to-End Optimization of Model Harnesses.”](https://arxiv.org/abs/2603.28052) arXiv preprint arXiv:2603.28052, 2026.
|
||||
|
||||
\[10\] Lu, et al. [“Towards end-to-end automation of AI research.”](https://www.nature.com/articles/s41586-026-10265-5) *Nature*, 651:914–919, 2026.
|
||||
|
||||
\[11\] Meng, et al. [“ScientistOne: Towards Human-Level Autonomous Research via Chain-of-Evidence.”](https://arxiv.org/abs/2605.26340) arXiv preprint arXiv:2605.26340, 2026.
|
||||
|
||||
\[12\] Kulikov, et al. [“Autodata: An agentic data scientist to create high quality synthetic data.”](https://arxiv.org/abs/2606.25996) arXiv preprint arXiv:2606.25996, 2026.
|
||||
|
||||
\[13\] Hu, Lu, and Clune. [“Automated Design of Agentic Systems.”](https://arxiv.org/abs/2408.08435) ICLR 2025.
|
||||
|
||||
\[14\] Madaan, et al. [“Self-Refine: Iterative Refinement with Self-Feedback.”](https://arxiv.org/abs/2303.17651) NeurIPS 2023.
|
||||
|
||||
\[15\] Zhang, et al. [“AFlow: Automating Agentic Workflow Generation.”](https://arxiv.org/abs/2410.10762) ICLR 2025.
|
||||
|
||||
\[16\] Zelikman, et al. [“Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation.”](https://arxiv.org/abs/2310.02304) COLM 2024.
|
||||
|
||||
\[17\] Zhang, et al. [“Self-Harness: Harnesses That Improve Themselves.”](https://arxiv.org/abs/2606.09498) arXiv preprint arXiv:2606.09498, 2026.
|
||||
|
||||
\[18\] Fernando, et al. [“Promptbreeder: Self-Referential Self-Improvement Via Prompt Evolution.”](https://arxiv.org/abs/2309.16797) arXiv preprint arXiv:2309.16797, 2023.
|
||||
|
||||
\[19\] Agrawal, A. et al. [“GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning.”](https://arxiv.org/abs/2507.19457) arXiv preprint arXiv:2507.19457, 2025.
|
||||
|
||||
\[20\] Novikov, et al. [“AlphaEvolve: A coding agent for scientific and algorithmic discovery.”](https://arxiv.org/abs/2506.13131) arXiv preprint arXiv:2506.13131, 2025.
|
||||
|
||||
\[21\] Lange, Imajuku, and Cetin. [“ShinkaEvolve: Towards Open-Ended And Sample-Efficient Program Evolution.”](https://arxiv.org/abs/2509.19349) arXiv preprint arXiv:2509.19349, 2025.
|
||||
|
||||
\[22\] Wang, et al. [“ThetaEvolve: Test-time Learning on Open Problems.”](https://arxiv.org/abs/2511.23473) arXiv preprint arXiv:2511.23473, 2025.
|
||||
|
||||
\[23\] Zhang, et al. [“Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents.”](https://arxiv.org/abs/2505.22954) arXiv preprint arXiv:2505.22954, 2025.
|
||||
|
||||
\[24\] Zhang, et al. [“Hyperagents.”](https://arxiv.org/abs/2603.19461) arXiv preprint arXiv:2603.19461, 2026.
|
||||
|
||||
\[25\] Yuksekgonul, et al. [“Learning to Discover at Test Time.”](https://arxiv.org/abs/2601.16175) arXiv preprint arXiv:2601.16175, 2026.
|
||||
|
||||
\[26\] Riaz, et al. [“Epistemic Uncertainty for Test-Time Discovery.”](https://arxiv.org/abs/2605.11328) arXiv preprint arXiv:2605.11328, 2026.
|
||||
|
||||
\[27\] Hebbar, et al. [“SIA: Self Improving AI with Harness & Weight Updates.”](https://arxiv.org/abs/2605.27276) arXiv preprint arXiv:2605.27276, 2026.
|
||||
|
||||
\[28\] Trehan and Chopra. [“Why LLMs Aren’t Scientists Yet: Lessons from Four Autonomous Research Attempts.”](https://arxiv.org/abs/2601.03315) arXiv preprint arXiv:2601.03315, 2026.
|
||||
|
||||
\[29\] Bubeck 等人。 [“使用 GPT-5 进行早期科学加速实验。”](https://arxiv.org/abs/2511.16072) arXiv 预印本 arXiv:2511.16072,2025 年。
|
||||
|
||||
\[30\] Starace 等人。 [“PaperBench:评估人工智能复制人工智能研究的能力。”](https://arxiv.org/abs/2504.01848) ICML 2025。
|
||||
|
||||
\[31\] Wijk 等人。 [“RE-Bench:评估语言模型代理相对于人类专家的前沿 AI 研发能力。”](https://arxiv.org/abs/2411.15114) ICML 2025。
|
||||
|
||||
\[32\] Chan 等人。 [“MLE-bench:在机器学习工程上评估机器学习代理。”](https://arxiv.org/abs/2410.07095) arXiv 预印本 arXiv:2410.07095,2024 年。
|
||||
|
||||
\[33\] Chen 等人。 [“ScienceAgentBench:面向数据驱动科学发现的语言代理的严格评估。”](https://arxiv.org/abs/2410.05080) ICLR 2025。
|
||||
|
||||
\[34\] Siegel 等人。 [“CORE-Bench:通过计算可重复性代理基准测试来提高已发表研究的可信度。”](https://arxiv.org/abs/2409.11363) TMLR 2024。
|
||||
|
||||
\[35\] Ouyang 等人。 [“KernelBench:LLM 能否编写高效的 GPU 内核?”](https://arxiv.org/abs/2502.10517) arXiv 预印本 arXiv:2502.10517,2025 年。
|
||||
@@ -0,0 +1,806 @@
|
||||
---
|
||||
title: "Hermes Agent 从中级到高级进阶指南"
|
||||
source: "https://x.com/BTCqzy1/status/2044259795499450414"
|
||||
author:
|
||||
- "[[@BTCqzy1]]"
|
||||
published: 2026-04-15
|
||||
created: 2026-04-24
|
||||
description: "本指南默认你已完成 Hermes 的基础安装与配置,正文不再重复安装步骤。我们将直接进入进阶核心内容:记忆系统、技能自进化、多 Agent 协作、生产化部署与高级调试。目录一、记忆系统进阶 1 Hermes 记忆系统的整体架构详解 2 Agent-curated memory..."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||

|
||||
|
||||
本指南默认你已完成 Hermes 的基础安装与配置,正文不再重复安装步骤。我们将直接进入进阶核心内容:记忆系统、技能自进化、多 Agent 协作、生产化部署与高级调试。
|
||||
|
||||
## 目录
|
||||
|
||||
**一、记忆系统进阶**
|
||||
|
||||
1 Hermes 记忆系统的整体架构详解
|
||||
|
||||
2 Agent-curated memory 机制原理:为什么它“不记得”?
|
||||
|
||||
3 核心记忆文件正确使用方法(附模板)
|
||||
|
||||
4 Super Memory 与持久记忆 nudge 配置
|
||||
|
||||
5 跨会话与长任务记忆保持方法
|
||||
|
||||
6 外部 Memory Providers 实战配置
|
||||
|
||||
7 记忆文件管理规则与清理技巧
|
||||
|
||||
8 记忆与技能的联动机制
|
||||
|
||||
动手实践:构建你的专属记忆系统
|
||||
|
||||
**二、技能自进化**
|
||||
|
||||
1 Hermes 自我进化机制详解(Agent-Managed Skills)
|
||||
|
||||
2 Agent 自动创建 Skill 的触发条件与流程
|
||||
|
||||
3 技能质量控制与优化方法
|
||||
|
||||
4 技能退化与重复问题的解决思路
|
||||
|
||||
5 Skill 与记忆系统的联动机制
|
||||
|
||||
6 Self-optimization 功能使用建议
|
||||
|
||||
动手实践:训练你的第一个自动化技能
|
||||
|
||||
**三、多 Agent 协作**
|
||||
|
||||
1 Sub-Agent 的 spawn 机制与使用方法
|
||||
|
||||
2 Profiles 功能实战:同一台机器运行多个独立 Hermes
|
||||
|
||||
3 子 Agent 的独立记忆与技能隔离
|
||||
|
||||
4 主 Agent 协调多个子 Agent 的技巧
|
||||
|
||||
5 多 Agent 资源分配与冲突避免
|
||||
|
||||
动手实践:配置双 Agent 协作工作流
|
||||
|
||||
**四、生产化部署**
|
||||
|
||||
1 Gateway 长期后台运行的多种方式
|
||||
|
||||
2 定时任务、Heartbeat 与通知机制
|
||||
|
||||
3 日志监控与调试方法
|
||||
|
||||
4 Tirith 安全模块的使用与处理
|
||||
|
||||
5 多平台接入进阶配置
|
||||
|
||||
6 生产化部署 Checklist
|
||||
|
||||
动手实践:完成生产环境的稳定部署
|
||||
|
||||
**五、高级扩展与调试**
|
||||
|
||||
1 MCP 外部工具链集成实战
|
||||
|
||||
2 调试高级技巧 + 中高级常见报错快速定位
|
||||
|
||||
动手实践:接入本地文件系统或数据库
|
||||
|
||||
**六、疑难解答(Q&A)**
|
||||
|
||||
**七、配置速查表**
|
||||
|
||||
## 一、记忆系统进阶
|
||||
|
||||
很多人用了 Hermes 一段时间后,最大的抱怨就是:“它根本记不住东西”。这通常不是 Bug,而是没有搞清楚它的记忆机制。Hermes 的记忆系统有比较明确的设计逻辑,理解它,才能真正让 Agent 越用越聪明。
|
||||
|
||||
**1 Hermes 记忆系统的整体架构详解**
|
||||
|
||||
Hermes 的记忆系统更适合理解为内置记忆 + 外部记忆提供商 + 运行时上下文的组合,而不是简单的“只有两层”。其中,内置记忆始终存在;外部 Memory Provider 是叠加能力,不是替代关系 。
|
||||
|
||||
**第一层:内置记忆(始终激活)**
|
||||
|
||||
内置记忆通常由两个文件组成。默认 profile 下,它们通常存储在 **~/.hermes/memories/** 目录;如果你启用了命名 **Profile**,则对应路径会跟随当前 **HERMES\_HOME** 变化到该 **Profile** 的 **memories/** 目录。
|
||||
|
||||
- **MEMORY.md** 更像 Agent 的工作笔记,主要保存环境事实、项目约定和学到的技巧。针对 MEMORY.md,Hermes 存在 2,200 字符的系统阈值(硬限制)。为避免信息截断,建议日常维持在 1,800 字符(约 1,200 汉字) 左右,预留 20% 空间给 Agent 自动追加。
|
||||
- **USER.md** 更像用户画像,主要保存偏好、沟通风格和工作习惯。针对 USER.md,Hermes 存在 1,375 字符的系统阈值(硬限制)。建议日常维持在 1,100 字符(约 700 汉字) 左右,预留空间给 Agent 自动追加,以保持用户画像的精炼。
|
||||
|
||||
这两个文件在每次会话开始时,会作为冻结快照(Frozen Snapshot)注入到上下文中。注意“冻结”这个词,它意味着:
|
||||
|
||||
- **会话中途 Agent 新写入的记忆,往往不会立刻改变当前这轮会话的上下文,通常要到后续会话或后续重载时才更明显地体现出来。**
|
||||
- 这种设计的核心目标之一,是尽量保持前缀稳定,从而提升缓存命中并降低推理成本。
|
||||
|
||||
**第二层:外部记忆提供商(可选,叠加激活)**
|
||||
|
||||
外部提供商是对内置记忆的补充,不是替代。启用后,Hermes 通常会在合适的时机从外部提供商提取相关信息,并在会话结束或阶段性反思时同步新的长期信息。不同 provider 的具体行为会略有差异,因此实战中最好以对应 provider 的官方说明为准 。
|
||||
|
||||
**2 Agent-curated memory 机制原理:为什么它“不记得”?**
|
||||
|
||||
这是最多人踩的坑。Hermes 的内置记忆是Agent 策展(Agent-curated)的,不是全量记录的。
|
||||
|
||||
**机制原理**
|
||||
|
||||
Hermes 把记忆写入设计成“冻结快照 + Agent-curated(策展)机制”,主要有两个重要原因:
|
||||
|
||||
- **节省 Token 和提升推理速度**:如果每轮对话都实时更新记忆,System Prompt 的头部就会频繁变化,导致模型无法有效利用 KV Cache(前缀缓存),推理成本和响应速度都会明显变差。冻结快照的设计能让 Prompt 头部保持相对稳定,从而大幅降低 Token 消耗。
|
||||
- **防止记忆污染,保证质量**:Agent 在思考过程中的很多“碎碎念”、临时试错、中间结果,其实并不值得长期保留。只有经过 Agent 自己判断“重要”的内容,才会被策展(curated)后写入长期记忆。这样能让记忆保持干净、高密度,避免低价值信息干扰后续决策。
|
||||
|
||||
**简单来说:实时写入会贵且乱,策展 + 周期性 nudge 则是性能与质量的平衡点。**
|
||||
|
||||
Agent 不会把你说的每一句话都写进记忆。通常只有在以下场景里,记忆才更容易被保留下来:
|
||||
|
||||
- 你明确表达了偏好,例如“我喜欢/不喜欢 xxx”
|
||||
- 发现了环境事实,例如“这台机器装了 xxx”
|
||||
- 纠正了 Agent 的错误做法,例如“不要用 sudo,我在 docker 组里”
|
||||
- 完成了一个重要任务里程碑
|
||||
- 你明确要求它记住某件事
|
||||
|
||||
**触发时机**
|
||||
|
||||
写入通常不是每句话实时发生,而是会结合 nudge\_interval 这类节奏控制,在若干轮对话后触发一次“记忆反思”。如果会话太短,或者任务太单一,Agent 可能根本没有足够机会去整理并固化记忆。
|
||||
|
||||
**解决方案**:尽量明确地下达记忆指令
|
||||
|
||||
最直接的方法是在对话中明确指令:
|
||||
|
||||
**记住我的偏好:所有代码统一使用 Python 3.11,不要用 3.12 或 3.13**。
|
||||
|
||||

|
||||
|
||||
这样更容易让 Agent 把这类信息视为值得长期保留的内容
|
||||
|
||||
**3 核心记忆文件正确使用方法(附模板)**
|
||||
|
||||
除了 MEMORY.md 和 USER.md,Hermes 还有几个重要的上下文文件,很多人会搞混它们的用途。这里直接按用途来记会更直观;**下面默认按默认 profile 的路径写示例,如果你启用了命名 Profile,请把 ~/.hermes 替换成当前 profile 的 HERMES\_HOME。**
|
||||
|
||||
- **MEMORY.md 位于 ~/.hermes/memories/**,主要保存 Agent 的工作笔记、环境事实和学到的技巧,通常主要由 Agent 维护。
|
||||
- **USER.md 位于 ~/.hermes/memories/**,主要保存用户画像、偏好和沟通风格,通常主要由 Agent 维护。
|
||||
- **SOUL.md 位于 ~/.hermes/**,主要保存 Agent 的人格、行为准则和固定规则,这部分更适合你自己来写。
|
||||
- **AGENTS.md 位于项目根目录**,主要保存项目级行为规范和执行约束,这部分也更适合你自己来写。
|
||||
|
||||
**铁律:不要把应该写在 SOUL.md 里的东西放进 MEMORY.md。**
|
||||
|
||||
MEMORY.md 更像 Agent 的工作笔记,会被整理、压缩,甚至替换掉过时内容。你的固定规则应该放在 SOUL.md,那里更适合承载稳定、不希望被自动重写的约束。
|
||||
|
||||
**SOUL.md 模板**
|
||||
|
||||
**(请参考你原教程“零、开始之前”章节中的完整模板,直接复制到 ~/.hermes/SOUL.md)**
|
||||
|
||||
AGENTS.md 模板(直接复制到你的项目根目录)
|
||||
|
||||
```text
|
||||
# 项目规范:MyAPI Service
|
||||
## 技术栈
|
||||
- 语言:Rust 1.75+
|
||||
- 框架:Axum
|
||||
- 数据库:PostgreSQL 16(使用 SQLx)
|
||||
## 编码约定
|
||||
1 所有数据库查询必须使用 SQLx 的宏进行编译期检查。
|
||||
2 错误处理统一使用 \`anyhow::Result\` 和自定义的 \`AppError\` 枚举。
|
||||
3 环境变量配置在 \`.env\` 文件中,不要在代码中硬编码任何凭证。
|
||||
## 常用命令
|
||||
- 运行测试:\`cargo test --all-features\`
|
||||
- 启动服务:\`cargo run --bin server\`
|
||||
```
|
||||
|
||||
**4 Super Memory 与持久记忆 nudge 配置**
|
||||
|
||||
调整 nudge 频率时,打开 ~/.hermes/config.yaml,找到或添加类似配置:
|
||||
|
||||
```text
|
||||
memory:
|
||||
nudge_interval: 5
|
||||
```
|
||||
|
||||
数值越小,Agent 越频繁地进行记忆反思,写入的内容通常也会更多,但 token 消耗也会增加。
|
||||
|
||||
推荐值更适合按模型能力与任务长度来估算,而不要把某一个数字当成所有环境的绝对标准。可以这样理解:
|
||||
|
||||
- 小模型、较小上下文窗口的场景,通常更适合从 3~5 起步,因为上下文更紧,需要更早固化重要信息。
|
||||
- 标准模型和常见上下文窗口的场景,通常适合从 5~10 起步,在成本与记忆质量之间更容易取得平衡。
|
||||
- 大上下文模型可以考虑 10~15 左右,因为它们往往可以在更长对话后再做质量更高的总结。
|
||||
|
||||
**说明:在很多安装环境里,memory.nudge\_interval 的默认值常见为 10,但不同版本、旧配置迁移结果和后续调整都可能不同,最终仍以你本机 config.yaml 为准。Hermes 原生不使用 flush 参数,而是通过 nudge 机制在会话间隙进行记忆固化。**
|
||||
|
||||
**注意:这里的“轮”更适合理解为一次完整的用户输入与 Agent 回复,而不是 Agent 内部的 tool call 次数。**
|
||||
|
||||
**5 跨会话与长任务记忆保持方法**
|
||||
|
||||
**方法一:手动插入 Checkpoint(最简单有效)**
|
||||
|
||||
在长任务进行到一半时,主动告诉 Agent:
|
||||
|
||||
**当前进度总结:我们已经完成了数据清洗和特征工程,下一步是训练模型。请把这个进度写入你的记忆,确保后续不会忘记。**
|
||||
|
||||
**方法二:用外部文件作为“任务状态文件”**
|
||||
|
||||
对于超长任务,让 Agent 维护一个专门的状态文件:
|
||||
|
||||
**请在项目目录下创建 TASK\_STATUS.md,记录当前任务的完整状态。每次我们恢复工作时,先读取这个文件。**
|
||||
|
||||
时间线提醒:记忆插件化并不是 v0.9.0 才新增的能力。更准确地说,自 v0.7.0 起,Hermes 就已经提供了可插拔的 external memory providers。
|
||||
|
||||
**6 外部 Memory Providers 实战配置**
|
||||
|
||||
自 v0.7.0 起,Hermes 已支持多种外部 Memory Providers,例如:Honcho、OpenViking、Mem0、Hindsight、Holographic、RetainDB、ByteRover、Supermemory 等。内置 MEMORY.md / USER.md 仍继续工作,并不是被外部 provider 替代;实际支持列表请以你当前版本的官方文档、插件界面或本机可用 provider 为准。
|
||||
|
||||
推荐一:Mem0(偏省心、自动化程度较高)
|
||||
|
||||
Mem0 的核心优势是自动提取与同步长期记忆,适合不想手动设计太多记忆流程的用户。
|
||||
|
||||
```text
|
||||
# 1. 安装依赖
|
||||
pip install mem0ai
|
||||
# 2. 获取 API Key:https://app.mem0.ai/
|
||||
# 3. 写入环境变量
|
||||
echo "MEM0_API_KEY=your-key-here" >> $HERMES_HOME/.env
|
||||
# 4. 激活
|
||||
hermes config set memory.provider mem0
|
||||
# 5. 验证
|
||||
hermes memory status
|
||||
```
|
||||
|
||||
推荐二:Holographic(偏本地、隐私友好 )
|
||||
|
||||
如果你不想把数据发给第三方服务,Holographic 往往是一个更偏本地化的选择。
|
||||
|
||||
```text
|
||||
# 激活
|
||||
hermes config set memory.provider holographic
|
||||
# 验证
|
||||
hermes memory status
|
||||
```
|
||||
|
||||
**7 记忆文件管理规则与清理技巧**
|
||||
|
||||
记忆容量管理的核心逻辑是:记忆不是越多越好,而是越稳定、越高密度越好。
|
||||
|
||||
这里不必把容量当成死表去记,理解使用感受就够了:MEMORY.md 的 2,200 字符硬限制 通常更适合保存 8 到 15 条高价值事实;USER.md 的 1,375 字符硬限制 通常更适合保存 5 到 10 条稳定偏好。
|
||||
|
||||
最佳实践通常不是“把容量塞满”,而是尽量让内容保持紧凑、可复用、不过度重复。实战中控制在 70%~80% 左右通常会更舒服,但这属于经验建议,不是硬性规则。
|
||||
|
||||
当 MEMORY.md 接近上限时,你可以手动引导 Agent:
|
||||
|
||||
请整理你的记忆,删除过时条目,合并相关条目,腾出空间。
|
||||
|
||||
手动清理也可以直接编辑文件:
|
||||
|
||||
```text
|
||||
nano ~/.hermes/memories/MEMORY.md
|
||||
```
|
||||
|
||||
nano ~/.hermes/memories/MEMORY.md
|
||||
|
||||
如果你的版本支持相关记忆维护命令,也可以优先使用官方提供的清理或压缩方式。
|
||||
|
||||
**8 记忆与技能的联动机制**
|
||||
|
||||
当 Agent 在 MEMORY.md 中多次记录了类似工作流,例如“每次部署前都要执行 A、B、C 三步”,这往往意味着:这个流程更适合沉淀为一个 Skill,而不是继续零散地塞在记忆里。
|
||||
|
||||
你可以主动引导:
|
||||
|
||||
**我注意到你已经记住了我们的部署流程。请把这个流程创建为一个可复用的 Skill,名字叫 deploy-workflow,这样以后可以直接复用。**
|
||||
|
||||
动手实践:构建你的专属记忆系统
|
||||
|
||||
任务目标: 配置好基础的记忆文件,并测试 Agent 的记忆能力。
|
||||
|
||||
操作步骤:
|
||||
|
||||
1. 复制本章的 SOUL.md 模板到 ~/.hermes/SOUL.md,并根据你的实际情况修改。
|
||||
2. 在你的常用项目目录下创建一个 AGENTS.md。
|
||||
3. 修改 config.yaml,先将 nudge\_interval 设置为 5 进行测试。
|
||||
4. 开启一个新的对话,告诉 Agent 一条特定偏好,例如:“以后所有的 Python 脚本都保存在 /tmp/scripts 目录下。”
|
||||
5. 进行 5 轮以上的对话,观察是否触发记忆整理。
|
||||
|
||||
预期效果:
|
||||
|
||||
- 运行 cat ~/.hermes/memories/MEMORY.md,能看到你刚才告诉它的偏好已经被记录下来。
|
||||
- 开启一个全新的会话,让 Agent 写一个 Python 脚本,它更有可能自动遵循先前记录的偏好。
|
||||
|
||||

|
||||
|
||||
## 二、技能自进化
|
||||
|
||||
Hermes 最大的差异点不只是“能干活”,而是“越干越会干”。理解技能自生成机制,才能让你的 Agent 真正进化,而不是每次都从零开始。
|
||||
|
||||
**1 Hermes 自我进化机制详解(Agent-Managed Skills)**
|
||||
|
||||
Hermes 的自我进化与 skill\_manage 工具关系非常密切。这更接近 Agent 的“程序性记忆”:当它摸索出一套非平凡的工作流后,会把这套方法保存为 Skill,供未来复用。
|
||||
|
||||
**一句话总结:记忆解决“记得住”,技能解决“用得高效且可复用”。Hermes 设计技能自生成机制的核心目的,是把记忆中的重复经验进一步沉淀为可复用的结构化 Skill。记忆更多是“事实和经验的记录”,相对散乱;**
|
||||
|
||||
而 Skill 是把这些经验提炼成清晰的触发条件 + 操作步骤 + 注意事项 + 验证方法,相当于把“知道怎么做”变成了“标准化 SOP”。这样做的好处是大幅降低 Agent 每次重新推理的负担(不用每次都从头思考流程),同时 Skill 更容易被标准化、复用,甚至跨 Profile 或跨 Agent 分发。
|
||||
|
||||
从长期看,这是 Hermes 实现“规模化协作”和“持续自我进化”的重要基础 —— 记忆是私有的、碎片化的,而 Skill 是可共享、可积累的“程序性知识”。
|
||||
|
||||
**Skill 通常存放在当前 HERMES\_HOME 对应的 skills/ 目录下;默认 profile 一般是 ~/.hermes/skills/。它不是可执行代码,而是一份可复用的操作知识——告诉 Agent“遇到这类任务时,应该怎么做”。**
|
||||
|
||||
**2 Agent 自动创建 Skill 的触发条件与流程**
|
||||
|
||||
1. 常见触发条件通常包括以下场景:
|
||||
2. 完成了一个相对复杂的任务
|
||||
3. 遇到了错误或死路,后来找到了正确路径
|
||||
4. 用户纠正了它的做法
|
||||
5. 发现了一个值得复用的非平凡工作流
|
||||
|
||||
主动引导 Agent 创建 Skill:
|
||||
|
||||
**我们刚才完成的这个数据处理流程很有价值,请把它保存为一个 Skill,名字叫 data-pipeline,放在 devops 分类下,确保包含触发条件、操作步骤、注意事项和验证方法。**
|
||||
|
||||
3 技能质量控制与优化方法
|
||||
|
||||
1. 判断一个 Skill 质量好不好的标准:
|
||||
2. 触发条件清晰:Agent 能准确判断什么时候该用它
|
||||
3. 步骤可执行:每一步都有明确操作,而不是空泛描述
|
||||
4. 有验证方法:执行完后能判断是否成功
|
||||
5. 有注意事项:记录了踩过的坑
|
||||
|
||||
手动优化 Skill 时,通常建议让 Agent 做定点修改,而不是整篇重写。例如:
|
||||
|
||||
**请更新 stock-daily-report 这个 Skill,在注意事项里补充一条:“周五收盘后数据可能延迟到周六早上才完整。”**
|
||||
|
||||
4 技能退化与重复问题的解决思路
|
||||
|
||||
技能退化的表现通常包括:
|
||||
|
||||
- 描述越来越模糊,触发条件越来越宽泛
|
||||
- 多个 Skill 做的是同一件事,但写法不同
|
||||
|
||||
**解决方案:让 Agent 做技能审计。**
|
||||
|
||||
1. 请审查你所有的 Skills,找出:
|
||||
2. 功能重复的技能(合并它们)
|
||||
3. 描述模糊、触发条件不清晰的技能(重写它们)
|
||||
|
||||
给我一份审计报告,然后等我确认后再执行修改。步骤已经过时的技能(更新它们)
|
||||
|
||||
**5 Skill 与记忆系统的联动机制**
|
||||
|
||||
在 SKILL.md 中,你可以引导 Agent 在执行技能前先查看记忆:
|
||||
|
||||
```text
|
||||
## 操作流程
|
||||
1 先检查 MEMORY.md 中是否有关于该 API 的特殊注意事项。
|
||||
2 如果有,优先遵循记忆中的约定。
|
||||
3 执行完成后,将新发现的注意事项写入 MEMORY.md。
|
||||
```
|
||||
|
||||
6 Self-optimization 功能使用建议
|
||||
|
||||
在 v0.8.0 到 v0.9.0 这一轮版本演进里,Hermes 的自我改进体验在 tool-use 优化和失败模式修复上持续增强,使得 Agent 在遇到问题时能更智能地调整其行为策略 6 7。但具体实现细节和配置入口会随版本迭代,建议以官方最新文档为准。
|
||||
|
||||
因此,比较稳妥的写法是:
|
||||
|
||||
- 把 Self-optimization 理解为 Hermes 在使用过程中会逐步修补技能和行为策略的能力方向。
|
||||
- 如果你要写进教程正文,建议使用“能力说明”而不是“固定配置键模板”。
|
||||
- 对于当前版本暂未完全确认的配置项,最好统一写成“请以官方最新配置参考和你本机 config.yaml 为准”。
|
||||
|
||||
动手实践:训练你的第一个自动化技能
|
||||
|
||||
任务目标: 让 Agent 学习并固化一个你常用的工作流。
|
||||
|
||||
**操作步骤**:
|
||||
|
||||
1. 找一个你经常做的重复性任务,例如:检查系统磁盘空间、清理 Docker 悬空镜像,并输出一份简报。
|
||||
2. 在对话中,一步步指导 Agent 完成这个任务,纠正它的错误,直到执行稳定。
|
||||
3. 发送指令:“请把刚才的清理流程保存为一个 Skill,命名为 docker-cleanup,包含触发条件、具体执行命令和验证步骤。”
|
||||
4. 运行 hermes skills list 查看是否创建成功。
|
||||
|
||||
**预期效果**:
|
||||
|
||||
- 开启一个新会话,直接发送指令:/docker-cleanup
|
||||
- Agent 能够较稳定地按照之前固化的步骤完成任务
|
||||
|
||||
## 三、多 Agent 协作
|
||||
|
||||
**1 Sub-Agent 的 spawn 机制与使用方法**
|
||||
|
||||
Hermes 对子 Agent 并发做了保护性限制,实战中不建议一上来就把并发拉得太高。对大多数在线模型场景,更稳妥的起点仍然是 2~3 个子 Agent,再根据额度、限流情况和结果质量逐步调整。
|
||||
|
||||
专家建议:在实际使用中,并发数不建议超过 3 个。特别是当使用官方 API 时,建议从 2 个起步,以防止触发 API 平台的 Rate Limit 或被封禁 IP,从而影响正常任务的执行。在实战中,追求理论最大并发往往不如控制成本与上下文质量重要。对于大多数在线模型场景,建议从 2~3 个并发子任务起步,再根据额度、限流情况和结果质量逐步调整。并发数越高,API 消耗通常增长越快。
|
||||
|
||||
Hermes 支持主 Agent 通过 delegate\_task 等方式派生子 Agent 执行拆分后的任务。
|
||||
|
||||
基本用法(在对话中引导主 Agent):
|
||||
|
||||
这个任务可以并行处理:
|
||||
|
||||
1. 子任务 A:抓取 A 股今日涨停板数据
|
||||
2. 子任务 B:分析北向资金流向
|
||||
3. 子任务 C:生成市场情绪指数
|
||||
|
||||
请派生 3 个子 Agent 并行完成这三个子任务,然后汇总结果。
|
||||
|
||||
**子 Agent 的关键限制(必读)**
|
||||
|
||||
子 Agent 往往从一个新的会话上下文开始,它并不会天然继承主 Agent 的完整历史。因此,你必须在 context 里把子 Agent 所需的背景信息传完整:
|
||||
|
||||
```text
|
||||
delegate_task(
|
||||
goal="修复 api/handlers.py 中的 TypeError",
|
||||
context="""
|
||||
文件路径:/home/user/myproject/api/handlers.py
|
||||
错误信息:第 47 行 TypeError: 'NoneType' object has no attribute
|
||||
'get'
|
||||
原因:parse_body() 在 Content-Type 缺失时返回 None
|
||||
项目使用 Python 3.11 + Flask
|
||||
"""
|
||||
)
|
||||
```
|
||||
|
||||
最重要的经验是:不要假设子 Agent 知道“这个错误”“刚才那个文件”“上一步那个思路”是什么。
|
||||
|
||||
**2 Profiles 功能实战:同一台机器运行多个独立 Hermes**
|
||||
|
||||
Profile 是一个完全隔离的 Hermes 环境。每个 Profile 都有自己独立的配置、记忆、会话和技能;底层通常是通过单独的 HERMES\_HOME 路径来实现目录级隔离 5。但要注意,默认 profile 仍然就是 ~/.hermes;只有你显式创建并切换到命名 Profile 时,相关配置、记忆、技能、会话和日志等才会跟随当前 HERMES\_HOME 切到 ~/.hermes/profiles/<name>/ 这类路径。
|
||||
|
||||
创建 Profile 的三种常见方式:
|
||||
|
||||
```text
|
||||
# 方式一:全新 Profile(空白)
|
||||
hermes profile create mybot
|
||||
# 方式二:克隆配置(复用 API Key 和模型,但记忆和会话独立)
|
||||
hermes profile create work --clone
|
||||
# 方式三:完整克隆(包含记忆、会话、技能等更多状态)
|
||||
hermes profile create backup --clone-all
|
||||
```
|
||||
|
||||
运行多个独立 Agent:
|
||||
|
||||
```text
|
||||
# 终端 1:运行编码助手
|
||||
coder chat
|
||||
# 终端 2:运行投研助手(独立的记忆和技能)
|
||||
research chat
|
||||
```
|
||||
|
||||
**3 子 Agent 的独立记忆与技能隔离**
|
||||
|
||||
每个 Profile 的 memories/、skills/、sessions/ 和 logs/ 目录通常都是独立的,不会互相读写。
|
||||
|
||||
如果你希望多个 Profile 共享同一套技能,可以考虑使用外部技能目录;但具体字段名和配置方式,最好以你当前版本的配置参考为准。一个常见思路如下:
|
||||
|
||||
```text
|
||||
skills:
|
||||
external_dirs:
|
||||
- ~/.hermes/shared-skills
|
||||
```
|
||||
|
||||
**4 主 Agent 协调多个子 Agent 的技巧**
|
||||
|
||||
明确角色分工,通常是最有效的方法。你可以在 SOUL.md 或 AGENTS.md 中定义:
|
||||
|
||||
```text
|
||||
## 多 Agent 协作规范
|
||||
- Planner Agent:负责任务分解和进度追踪,不直接执行
|
||||
- Executor Agent:负责具体的数据获取和处理,不做决策
|
||||
- Reviewer Agent:负责质量检查和结果验证,不做修改
|
||||
```
|
||||
|
||||
**5 多 Agent 资源分配与冲突避免**
|
||||
|
||||
Bot Token 冲突保护
|
||||
|
||||
如果两个 Profile 意外使用了同一个 Bot Token,运行中的 Gateway 往往会产生冲突。因此,最好在各自的 .env 中配置不同的 Token。
|
||||
|
||||
端口冲突
|
||||
|
||||
如果你在本地运行多个 Hermes 实例,最好让它们使用不同端口。例如:
|
||||
|
||||
```text
|
||||
# Profile A
|
||||
GATEWAY_PORT=8080
|
||||
# Profile B
|
||||
GATEWAY_PORT=8081
|
||||
```
|
||||
|
||||
动手实践:配置双 Agent 协作工作流
|
||||
|
||||
任务目标: 创建两个独立的 Profile,分别承担不同角色,互不干扰。
|
||||
|
||||
操作步骤:
|
||||
|
||||
1. 运行 hermes profile create coder --clone 创建一个专门写代码的 Agent。
|
||||
2. 运行 hermes profile create reviewer --clone 创建一个专门做代码审查的 Agent。
|
||||
3. 分别编辑它们的 SOUL.md,赋予不同角色设定。
|
||||
4. 让 coder 写一段有 Bug 的代码并保存到文件。
|
||||
5. 切换到 reviewer,让它读取该文件并提出修改建议。
|
||||
|
||||
预期效果:
|
||||
|
||||
- 两个 Agent 能独立运行,且 reviewer 的记忆中不会混入 coder 的工作流。
|
||||
|
||||
## 四、生产化部署
|
||||
|
||||
**1 Gateway 长期后台运行的多种方式**
|
||||
|
||||
方式一:Systemd(Linux 生产环境首选)
|
||||
|
||||
```text
|
||||
# 安装为 Systemd 服务
|
||||
hermes gateway install
|
||||
# 查看服务状态
|
||||
systemctl status hermes-gateway # 如果你使用命名 Profile,服务名可能
|
||||
会带上 profile 后缀,以实际安装输出为准
|
||||
journalctl -u hermes-gateway -f
|
||||
```
|
||||
|
||||
方式二:Docker Compose 方式(更适合多 Profile 部署)
|
||||
|
||||
```text
|
||||
version: "3.8"
|
||||
services:
|
||||
hermes-default:
|
||||
image: nousresearch/hermes-agent:latest
|
||||
container_name: hermes-default
|
||||
restart: unless-stopped
|
||||
command: gateway run
|
||||
volumes:
|
||||
- ~/.hermes:/opt/data
|
||||
hermes-coder:
|
||||
image: nousresearch/hermes-agent:latest
|
||||
container_name: hermes-coder
|
||||
restart: unless-stopped
|
||||
command: gateway run
|
||||
volumes:
|
||||
- ~/.hermes/profiles/coder:/opt/data
|
||||
```
|
||||
|
||||
重要提醒:不要同时运行两个容器挂载同一个数据目录,否则共享状态文件可能出问题。
|
||||
|
||||
**2 定时任务、Heartbeat 与通知机制**
|
||||
|
||||
❗ 专家级警告:严禁盲目复制模板时区!
|
||||
|
||||
Hermes 的 Cron 任务严格依赖服务器系统时区。配置前必须运行 timedatectl 确认。
|
||||
|
||||
国内服务器:应显示 Asia/Shanghai。
|
||||
|
||||
海外服务器:若显示 UTC,请手动执行 sudo timedatectl set-timezone Asia/Shanghai 修正,否则你的定时任务会在半夜“惊喜上线”。
|
||||
|
||||
Heartbeat 机制(防止静默失败)
|
||||
|
||||
```text
|
||||
# 在 ~/.hermes/.env 中添加
|
||||
echo "GATEWAY_HEARTBEAT=true" >> ~/.hermes/.env
|
||||
```
|
||||
|
||||
定时任务(Cron)
|
||||
|
||||
```text
|
||||
# 示例:工作日早上 8:30 生成日报
|
||||
hermes cron add "30 8 * * 1-5" " 生成今日 A 股市场日报并发送到
|
||||
Telegram"
|
||||
```
|
||||
|
||||
时区是最容易踩的坑之一。 Hermes 的 Cron 通常使用服务器系统时区。如果你的服务器时区与预期不一致,定时任务就会在错误时间运行。
|
||||
|
||||
```text
|
||||
# 先确认服务器系统时区
|
||||
timedatectl
|
||||
# 如果时区不对,再修改
|
||||
sudo timedatectl set-timezone Asia/Shanghai
|
||||
```
|
||||
|
||||
创建任务后,最好先手动运行一次验证逻辑:
|
||||
|
||||
```text
|
||||
hermes cron list
|
||||
hermes cron run 任务名称
|
||||
```
|
||||
|
||||
**3 日志监控与调试方法**
|
||||
|
||||
日志目录会跟随当前 profile 的 HERMES\_HOME 变化;默认 profile 下通常位于 ~/.hermes/logs/,并可结合 hermes logs 等方式查看 6。
|
||||
|
||||
当你需要向社区或官方反馈问题时,也可以考虑:
|
||||
|
||||
```text
|
||||
hermes debug share
|
||||
```
|
||||
|
||||
**4 Tirith 安全模块的使用与处理**
|
||||
|
||||
Tirith 是 Hermes 的预执行安全扫描模块。
|
||||
|
||||
```text
|
||||
approvals:
|
||||
mode: manual # manual | smart | off
|
||||
```
|
||||
|
||||
这三种模式可以直接这样理解:
|
||||
|
||||
- manual:所有高风险命令都需要人工确认。
|
||||
- smart:由辅助判断做一层风险分级,低风险场景会更顺滑一些。
|
||||
- off:关闭安全检查,仅适合可信环境。
|
||||
|
||||
如果你所在版本支持命令白名单,且某些高频命令被误拦截,可以考虑把它们加入 allowlist;但具体字段名与位置,请以你当前版本的配置参考为准。
|
||||
|
||||
**5 多平台接入进阶配置**
|
||||
|
||||
Telegram 接入
|
||||
|
||||
```text
|
||||
# 基础配置
|
||||
echo "TELEGRAM_BOT_TOKEN=your-bot-token" >> ~/.hermes/.env
|
||||
echo "TELEGRAM_ALLOWED_USERS=your-telegram-user-id" >>
|
||||
~/.hermes/.env
|
||||
```
|
||||
|
||||
提醒:如果没有配置允许访问的用户范围,Bot 通常不会处于你预期的安全状态,因此上线前一定要做访问控制。
|
||||
|
||||
**6 生产化部署 Checklist**
|
||||
|
||||
在将 Hermes 部署到生产环境之前,建议逐项检查:
|
||||
|
||||
- hermes doctor 无明显报错
|
||||
- API Key 已配置在 .env 文件中,而不是 config.yaml
|
||||
- 已按需设置 GATEWAY\_HEARTBEAT=true
|
||||
- 已配置用户白名单(例如 TELEGRAM\_ALLOWED\_USERS)
|
||||
- 审批模式已根据需求设置(approvals.mode)
|
||||
- 已安装为 Systemd 服务,或容器设置了自动重启
|
||||
|
||||
动手实践:完成生产环境的稳定部署
|
||||
|
||||
任务目标: 将 Hermes 部署为后台长期运行的服务,并接入 Telegram/Discord。
|
||||
|
||||
操作步骤:
|
||||
|
||||
1. 在 .env 中配置好 Telegram 或 Discord 的 Token 和你的 User ID。
|
||||
2. 使用 hermes gateway install 将其注册为 Systemd 服务,或采用 Docker Compose。
|
||||
3. 启动服务:systemctl start hermes-gateway
|
||||
4. 在手机上打开 Telegram/Discord,向你的 Bot 发送消息测试。
|
||||
5. 配置一个简单的 Cron 任务,测试定时触发是否正常。
|
||||
|
||||
预期效果:
|
||||
|
||||
- 即使关闭 SSH 终端,Bot 依然能在 Telegram/Discord 上正常回复消息。
|
||||
- Cron 任务能在指定时间附近准确触发。
|
||||
|
||||
## 五、高级扩展与调试
|
||||
|
||||
**1 MCP 外部工具链集成实战**
|
||||
|
||||
MCP(Model Context Protocol)允许你为 Hermes 接入外部工具,例如本地文件系统、数据库、自定义 API 等。
|
||||
|
||||
实战:接入本地文件系统(MCP Filesystem Server)
|
||||
|
||||
```text
|
||||
# 安装 MCP Filesystem Server
|
||||
npm install -g @modelcontextprotocol/server-filesystem
|
||||
```
|
||||
|
||||
在 [$HERMES](https://x.com/search?q=%24HERMES&src=cashtag_click)\_HOME/mcp.json 中配置:
|
||||
|
||||
```text
|
||||
{
|
||||
"mcpServers": {
|
||||
"filesystem": {
|
||||
"command": "npx",
|
||||
"args": [
|
||||
"-y",
|
||||
"@modelcontextprotocol/server-filesystem",
|
||||
"/home/ubuntu/projects",
|
||||
"/home/ubuntu/data"
|
||||
]
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
配置后,Agent 就更有机会直接通过 MCP 工具读写指定目录,而不必每次都依赖终端命令。
|
||||
|
||||
**2 调试高级技巧 + 中高级常见报错快速定位**
|
||||
|
||||
常用调试工具箱:
|
||||
|
||||
```text
|
||||
hermes doctor # 全面健康检查,优先运行
|
||||
hermes memory status # 检查记忆系统
|
||||
hermes mcp status # 检查 MCP 连接
|
||||
hermes debug share # 生成脱敏调试报告
|
||||
```
|
||||
|
||||
动手实践:接入本地文件系统或数据库
|
||||
|
||||
任务目标: 通过 MCP 协议,让 Agent 获得直接操作本地文件或数据库的能力。
|
||||
|
||||
操作步骤:
|
||||
|
||||
1. 按照本章教程,安装 [@modelcontextprotocol/server-filesystem](https://x.com/@modelcontextprotocol/server-filesystem)。
|
||||
2. 配置 mcp.json,将一个安全的测试目录暴露给 Agent。
|
||||
3. 运行 hermes mcp status 确认连接成功。
|
||||
4. 在对话中,让 Agent 列出该目录下的文件内容。
|
||||
|
||||
预期效果:
|
||||
|
||||
- Agent 能够在不直接执行普通 shell 命令的前提下,通过 MCP 工具读取并修改指定目录下的文件。
|
||||
|
||||
## 六、疑难解答(Q&A)
|
||||
|
||||
Q1:为什么我告诉了 Agent 一件事,它下次还是不记得?
|
||||
|
||||
A:常见原因包括:会话太短,没有触发记忆整理;或者 Agent 认为这件事不值得长期保存。最直接的做法,是明确说“请把这件事写入你的长期记忆”。
|
||||
|
||||
Q2:Cron 定时任务没有按时触发怎么办?
|
||||
|
||||
A:按以下顺序排查:
|
||||
|
||||
运行 hermes cron list,确认任务状态是否正常。
|
||||
|
||||
检查 Gateway 是否在后台运行,因为定时能力通常依赖运行中的服务。
|
||||
|
||||
运行 timedatectl 检查服务器系统时区。
|
||||
|
||||
手动运行 hermes cron run 任务名,确认任务逻辑本身没有问题。
|
||||
|
||||
Q3:Tirith 总是拦截我正常的 bash 命令,很烦怎么办?
|
||||
|
||||
A:可以从三个方向处理:
|
||||
|
||||
临时切到更宽松的工作模式。
|
||||
|
||||
调整 approvals.mode,例如从 manual 变成更灵活的策略。
|
||||
|
||||
如果你的版本支持命令白名单,再把高频安全命令加入 allowlist。
|
||||
|
||||
Q4:多个 Profile 可以共享同一个 Telegram Bot 吗?
|
||||
|
||||
A:通常不建议。多个运行中的 Gateway 最好使用独立 Token,避免冲突。
|
||||
|
||||
Q5:日志文件太大了,怎么清理?
|
||||
|
||||
A:先看你当前版本是否已经提供轮转或管理机制;如果没有,再手动清理旧日志文件,并在清理前确认重要问题已经留档。
|
||||
|
||||
Q6:多个子 Agent 并发运行时,API 消耗急剧增长,怎么控制成本?
|
||||
|
||||
A:四个办法最有效:第一,不要一上来就开太多并发,先从 2~3 个子任务试起。第二,让子任务尽量短、上下文尽量清晰,避免反复试错。第三,如果你的版本支持对子 Agent 单独设定模型或轮次上限,可以优先让子任务使用更便宜的模型,并控制最大轮次。第四,如果你在同一 provider 下配置了 Credential Pools,可以利用多 API Key 自动轮转来缓解 429 限流,并提升并发场景下的韧性;这通常比手工换 Key 更稳。
|
||||
|
||||
Q7:子 Agent 为什么总是说不知道任务背景?
|
||||
|
||||
A:因为子 Agent 往往不是从主会话里“复制脑子”过去的,而是从新上下文开始。你必须在 context 字段中把它需要的文件路径、报错信息、项目结构、依赖版本等都明确写出来。
|
||||
|
||||
## 七、配置速查表
|
||||
|
||||
路径提醒:下面的示例默认按默认 profile 编写;如果你正在使用命名 Profile,请把所有 ~/.hermes 路径替换成当前 profile 的 HERMES\_HOME。
|
||||
|
||||
生产环境参考 config.yaml
|
||||
|
||||
这是一份偏保守的参考写法。其中明确写出的字段,尽量只保留已在截至 v0.9.0 的官方文档或当前默认配置中可见的内容;其他随版本变化较快的项,请以你本机 config.yaml 为准。
|
||||
|
||||
```text
|
||||
agent:
|
||||
max_turns: 90
|
||||
memory:
|
||||
nudge_interval: 10
|
||||
provider: mem0 # 或 holographic / honcho / supermemory 等
|
||||
approvals:
|
||||
mode: smart
|
||||
terminal:
|
||||
backend: docker
|
||||
timeout: 60
|
||||
```
|
||||
|
||||
生产环境参考 .env
|
||||
|
||||
```text
|
||||
# 核心 API Key
|
||||
OPENAI_API_KEY=sk-xxx
|
||||
ANTHROPIC_API_KEY=sk-ant-xxx
|
||||
# Gateway 配置
|
||||
GATEWAY_PORT=8080
|
||||
GATEWAY_HEARTBEAT=true
|
||||
# 平台接入与白名单
|
||||
TELEGRAM_BOT_TOKEN=123456:ABC-DEF1234ghIkl-zyx57W2v1u123ew11
|
||||
TELEGRAM_ALLOWED_USERS=123456789,987654321
|
||||
# 外部记忆提供商(按需启用)
|
||||
MEM0_API_KEY=m0-xxx
|
||||
```
|
||||
|
||||
说明:approvals.mode: smart 在这里是面向生产使用的推荐策略示例,不代表它一定是官方默认值;如果你的环境更强调稳妥与审计,也可以继续使用 manual。如果你准备启用同 provider 的 Credential Pools,请优先按当前版本官方文档填写对应字段,不要直接照搬别人的旧配置。
|
||||
|
||||
本文保留了原稿的主体结构,并已按官方截至 v0.9.0 的文档与发布说明完成一轮复核修订。若你本机的实际命令输出、配置键名或插件列表与本文存在差异,请优先以当前版本官方文档、release note 和你本机 hermes doctor / config.yaml / profile 路径实际结果为准。
|
||||
@@ -0,0 +1,132 @@
|
||||
---
|
||||
title: "“原味丝袜”的味道 我知道"
|
||||
source: "https://x.com/PandaMing88/status/2048285670037184807"
|
||||
author:
|
||||
- "[[@PandaMing88]]"
|
||||
published: 2026-04-26
|
||||
created: 2026-04-26
|
||||
description: "问个问题,那些花钱买\"气味\"的男人,到底在对抗什么?你闻到的不是气味,是现代性的溃败。那些在二手平台上花三位数购买陌生女性穿过的丝袜的男人,他们要的从来不是\"性\"——他们要的是\"真实\"。这是一个被算法驯化的时代最后的反抗:当所有的欲望都被标准化、所有的亲密都被表演化、所有的气味都..."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||

|
||||
|
||||
# 问个问题,那些花钱买"气味"的男人,到底在对抗什么?
|
||||
|
||||
你闻到的不是气味,是现代性的溃败。
|
||||
|
||||
那些在二手平台上花三位数购买陌生女性穿过的丝袜的男人,他们要的从来不是"性"——他们要的是"真实"。
|
||||
|
||||
这是一个被算法驯化的时代最后的反抗:当所有的欲望都被标准化、所有的亲密都被表演化、所有的气味都被香水工业消灭的时候,一双沾染了汗液、皮脂、费洛蒙的丝袜,成了这个时代唯一无法被 PS 的生物学证据。
|
||||
|
||||
气味,是唯一无法作假的身份证。
|
||||
|
||||
## 一、神经科学的真相:为什么气味直达欲望中枢
|
||||
|
||||
人类嗅觉系统是唯一不经过丘脑中转、直接连接边缘系统的感觉通路。
|
||||
|
||||
这意味着什么?
|
||||
|
||||
气味绕过了理性审查,直接激活记忆、情绪和性唤起。
|
||||
|
||||
当你看到一张美女照片,视觉信号要经过视丘→视皮层→前额叶的漫长审查,你的大脑有无数次机会告诉你"这是 P 过的""这是摆拍的""这是商业化的性感"。
|
||||
|
||||
但当你闻到一个女性的体味,嗅球直接把信号送到杏仁核和海马体——那是你爬行动物脑的领地,那里没有道德、没有审美、没有社会规训,只有最原始的生物学判断:**这是一个真实的、有生育能力的、活着的女性。**
|
||||
|
||||
这就是为什么再高级的香水都无法替代体味的吸引力。香水是文明的产物,体味是生物学的真相。
|
||||
|
||||
在一个所有信号都可以被伪造的时代,只有气味还保留着生物学的诚实。
|
||||
|
||||
## 二、为什么"未经过滤"成了最稀缺的奢侈品
|
||||
|
||||
现代亲密关系的本质是什么?
|
||||
|
||||
**是一场永不停歇的表演。我很严肃的说,嗯!**
|
||||
|
||||
约会前要洗澡、喷香水、换内衣,性爱时要控制表情、调整姿势、模仿 AV 里的呻吟。就连体味都要被沐浴露、止汗剂、私处护理液层层消灭——我们花了整整一代人的时间,把人类变成了没有气味的塑料模特。
|
||||
|
||||
但生物学不会被骗。
|
||||
|
||||
你的前额叶可以接受"香奈儿5号",但你的边缘系统知道那不是真的。
|
||||
|
||||
这就是为什么"原味"成了一个价值符号。它代表的不是"脏",而是"未经审查的生物学信息"。
|
||||
|
||||
一双穿了 8 小时的丝袜,上面有汗液的盐分、皮脂的油脂、阴道分泌物的费洛蒙、足部菌群的代谢产物——这是一份完整的生物学档案,它告诉你:
|
||||
|
||||
她的激素水平(雌激素浓度影响体味甜度) 她的健康状态(免疫系统通过 MHC 基因影响体味) 她的情绪状态(压力激素皮质醇会改变汗液成分) 她的生育能力(排卵期女性体味对男性吸引力提升 40%)
|
||||
|
||||
这是 Tinder 照片永远无法提供的信息。
|
||||
|
||||
## 三、进化论的残酷:为什么你的大脑还活在 10 万年前
|
||||
|
||||
人类用了 300 万年进化出嗅觉配偶选择机制,但只用了 100 年就把它废掉了。
|
||||
|
||||
在狩猎采集时代,气味是筛选配偶的核心指标。MHC 基因(主要组织相容性复合体)决定了一个人的免疫系统特征,也决定了他的体味。进化心理学的经典实验证明:**女性会被 MHC 基因与自己差异最大的男性体味吸引**——因为基因差异越大,后代免疫力越强。
|
||||
|
||||
这是写在 DNA 里的配偶选择算法。
|
||||
|
||||
但现代社会把这套算法彻底摧毁了:
|
||||
|
||||
避孕药改变了女性的激素水平,让她们对气味的偏好发生逆转(服药女性会被 MHC 相似的男性吸引,这在生物学上是灾难性的) 香水工业用人工合成的化学分子覆盖了所有自然体味 社交媒体让"视觉吸引力"成了唯一筛选标准
|
||||
|
||||
结果就是:你的眼睛在刷 Tinder,但你的边缘系统在挨饿。
|
||||
|
||||
那些购买"原味丝袜"的男人,他们不是变态,他们是进化论的难民——他们的大脑拒绝接受"配偶选择可以只靠照片完成"这个现代性谎言。
|
||||
|
||||
## 四、社会学的讽刺:气味的阶级政治
|
||||
|
||||
这里有一个残酷的悖论:
|
||||
|
||||
越是上层阶级,越要消灭气味;越是下层阶级,越保留体味。
|
||||
|
||||
19 世纪的欧洲贵族发明了香水,不是因为他们更爱美,而是因为他们要和"有体味的穷人"划清界限。体味成了阶级标记——贵族用玫瑰和麝香证明"我不需要劳动",工人阶级的汗味则暴露了"我必须出卖体力"。
|
||||
|
||||
这套符号系统一直延续到今天。
|
||||
|
||||
你去看高端约会场所的男女,他们身上是 Dior、Tom Ford、祖马龙——这些气味的潜台词是"我有钱""我有品味""我属于你们这个阶层"。
|
||||
|
||||
但生物学不在乎阶级。
|
||||
|
||||
你的边缘系统不会因为对方喷了 5000 块的香水就分泌更多多巴胺。
|
||||
|
||||
这就是为什么"原味经济"是一个阶级颠覆的隐喻:那些花钱购买陌生女性体味的男人,他们用消费行为完成了一次符号学的造反——**我拒绝你们上层社会的香水游戏,我要回到生物学的真相。**
|
||||
|
||||
## 五、哲学的终极问题:什么是"真实"
|
||||
|
||||
海德格尔说,现代性的本质是"座架"(Gestell)——世界被技术理性框定,一切存在都被简化为"可计算、可操控、可替代"的资源。
|
||||
|
||||
亲密关系也是。
|
||||
|
||||
约会 APP 把人简化为"颜值 8 分、身高 180、年薪 50 万"的数据;社交媒体把性吸引力简化为"点赞数、转发量、评论区热度";就连性本身也被简化为"前戏 15 分钟、体位 3 种、高潮 2 次"的标准化流程。
|
||||
|
||||
在这个被算法殖民的世界里,"原味"是最后的抵抗。
|
||||
|
||||
因为气味无法被量化、无法被复制、无法被算法优化。一双丝袜上的体味,它属于一个具体的、独一无二的、此时此刻活着的女性——它不是"女性"这个抽象概念,不是 Instagram 上的美女滤镜,不是 PornHub 上的表演者。
|
||||
|
||||
它是海德格尔说的"此在"(Dasein)——一个真实的、在世的、无法被替代的存在。
|
||||
|
||||
那些购买"原味丝袜"的男人,他们在用最笨拙、最原始、最不体面的方式,完成一次存在主义的朝圣:
|
||||
|
||||
在一个所有人都是数据、所有关系都是算法、所有欲望都是被设计出来的时代,他们想要触碰一次"真实"。
|
||||
|
||||
## 尾声:谁才是真正清醒的人
|
||||
|
||||
我知道你在想什么。
|
||||
|
||||
你在想"这些人是不是有病""这是不是一种 fetish""这是不是对女性的物化"。
|
||||
|
||||
但如果你真的理解了上面这篇内容,你就会明白:
|
||||
|
||||
这不是关于丝袜的故事,这是关于现代性如何摧毁人类生物学本能的故事。
|
||||
|
||||
这不是关于变态的故事,这是关于一个被算法驯化的物种如何用最原始的方式寻找"真实"的故事。
|
||||
|
||||
**当所有的亲密都变成表演、所有的欲望都变成消费、所有的气味都变成香水的时候——**
|
||||
|
||||
那些还在寻找"原味"的人,可能是这个时代最后的清醒者。
|
||||
|
||||
他们只是不知道怎么说出来而已。
|
||||
|
||||
**Ming 哥出品**
|
||||
|
||||
写给那些拒绝被驯化的人
|
||||
@@ -0,0 +1,427 @@
|
||||
---
|
||||
title: "你不知道的 AI Coding:非技术人的上手、场景与实战"
|
||||
source: "https://x.com/HiTw93/status/2048230976447557787"
|
||||
author:
|
||||
- "[[@HiTw93]]"
|
||||
published: 2026-04-26
|
||||
created: 2026-04-26
|
||||
description: "太长可不读上个月在公司里给产品和业务的小伙伴分享了下如何上手 AI Coding,加上最近又发了条推特,聊到不少同学因为订阅门槛没机会用上一线 AI Coding 工具,方法和习惯不花钱就能先学,索性把上手这部分整理出来。然后为了让内容给大伙更好理解,文章中绘制了不少简单插画,这..."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||

|
||||
|
||||
# 太长可不读
|
||||
|
||||
上个月在公司里给产品和业务的小伙伴分享了下如何上手 AI Coding,加上最近又发了条推特,聊到不少同学因为订阅门槛没机会用上一线 AI Coding 工具,方法和习惯不花钱就能先学,索性把上手这部分整理出来。然后为了让内容给大伙更好理解,文章中绘制了不少简单插画,这样看起来应该更会直接。
|
||||
|
||||
不少人用 Claude Code 其实是卡在使用命令行的第一步,看到只有字母的终端会觉得是给程序员用的,自己肯定搞不定。其实门槛没想象的高,会用豆包这类对话框 AI 的人花点时间也能上手,剩下的就是慢慢习惯把执行权交给它。
|
||||
|
||||
等你用顺手后,你会发现它像个什么活都接的能干助手,跑后台数据、写解决你问题的小工具、把乱七八糟的文档拼成简报、做原型、整理销售报表都能干。之前会不会写代码不是关键,等你有意识把项目背景写进 CLAUDE.md、把需求写得足够精确、会去想着沉淀几个 Skill 把重复动作打包,那你其实就称得上入门了,这篇文章主要是想着带非技术同学可以上手使用我最爱的 Claude Code。
|
||||
|
||||
# 第一道坎是命令行
|
||||
|
||||
不写代码的同学习惯了豆包这类对话框 AI,第一次装 Claude Code 都会有点不适应。以前是个来回搬运的过程,你描述需求、它生成代码、你复制粘贴到别处去试,现在变成Claude Code 直接在终端运行,搬运这一步省掉了。
|
||||
|
||||

|
||||
|
||||
如果你没用过终端,推荐我做的 [Kaku](https://github.com/tw93/Kaku),它是专门为 AI Coding 做的终端,装好就能用,不用折腾配色和字体。深色浅色跟着系统走,分屏按 Cmd + D,文件管理器按 Cmd + Shift + Y 直接显示出来。对刚上手的人最友好的是内置了 AI 辅助:命令跑报错了会自动给修复建议,记不住命令在前面加个 # 写中文也能生成。
|
||||
|
||||

|
||||
|
||||
安装 Claude Code 也只需一条命令,详见 [官方文档](https://code.claude.com/docs/en/overview),然后进项目文件夹输入 claude 就能开始 Coding 了。
|
||||
|
||||
> curl -fsSL [https://claude.ai/install.sh](https://claude.ai/install.sh) | bash
|
||||
|
||||
# 非常建议补点技术知识
|
||||
|
||||
不写代码的同学想真把 Claude Code 用好,光会描述需求还不够,懂一点基础概念,后面排错会轻松很多。
|
||||
|
||||
**知道常用框架是干嘛的**,知道 React、Vue、Next.js 大概在解决什么问题,看 Claude Code 写出来的东西就不会一头雾水。
|
||||
|
||||
**常用软件的基础**,终端命令、Git、VS Code、Chrome 开发者工具,跑出错的时候你能跟着它一起定位,而不是只能干等。
|
||||
|
||||
**编程的几个核心思想**,函数是干什么的、变量和状态是什么、为什么要拆成多个文件,懂了这些需求才写得精确。
|
||||
|
||||
**学会读代码和读报错**,比自己会写代码更早派上用场。它改完一段你能扫一眼大概在干嘛,比让它从头解释一遍快得多。报错也别一看就慌,整段复制丢回去问"这是什么意思、要怎么改",十次有九次能告诉你具体哪一行出问题。
|
||||
|
||||
不用学到能自己写代码的程度,知道这些东西长什么样就够了。花一两个晚上把 freeCodeCamp 或者 MDN 的入门篇过一遍,或者去 B 站挑一套入门课粗看一遍,[计算机科学速成课](https://www.bilibili.com/video/BV1EW411u7th)、[哈佛 CS50](https://www.bilibili.com/video/BV1HW4y1A7Yi) 都不错,后面跟 Claude Code 协作的效率会很不一样。
|
||||
|
||||
我挺推荐这三本对工程师最有用的入门易读书:[《启示录》](https://book.douban.com/subject/5914587/) 看产品判断、[《Linux/Unix 设计思想》](https://book.douban.com/subject/7564417/) 看工程哲学、[《左耳听风》](https://book.douban.com/subject/36667269/) 看一个我怀念的左耳朵耗子攒下来的程序员专家视野,读完跟 AI 聊技术细节会少懵很多。
|
||||
|
||||
# 准备工作:账号与订阅
|
||||
|
||||
**账号**:在 [claude.ai](http://claude.ai/) 用 Gmail 注册,流程最标准,注册前尽量用美国 iP 稳定的网络环境,别频繁切换出口,不然新账号容易触发风控,同时新账号不要直接包 Max,也容易被封号。
|
||||
|
||||
最简单的方式是走美区 App Store 内购,Android 走 Google Play 也行,进 Claude App 选 Pro 用余额订阅就行,注意走 App Store 有税费,100档会显示成125,多 25 买一个安心,不过很建议先 Pro 起步,配额不够再升 Max。订阅状态跟账号走,iOS 订完之后在 Android 或网页登录都正常用。
|
||||
|
||||

|
||||
|
||||
账号没了所有事都得重来,甚至还有可能持续被封,订前几件事注意一下。网络环境用稳定低延迟的别天天换,账号一号一人别合租也别和别人共用,付款方式选靠谱的实体卡,虚拟卡尤其是币圈渠道充值的容易秒封。邮箱用老 Gmail 别用新注册的 Outlook,出口尽量保持干净别让其他乱七八糟的 App 流量都从同一个口子出去。
|
||||
|
||||
# Claude Code 适合什么样的活
|
||||
|
||||
我自己用过的 AI Coding 工具不少,Cursor、Windsurf 都试过一圈,Codex 平时也会用,主力还是 Claude Code。
|
||||
|
||||
它最不一样的地方是模型能力本身就很不错,加上Claude Code自己的代码实现也把 Harness 这一套玩到了极致,使用时候它先扫一遍 [CLAUDE.md](http://claude.md/) 和目录结构摸清楚上下文,然后跨文件改代码、跑命令、看报错、再改,自己全部完成。再加上它本来就活在终端里,git、测试、脚本这些你日常用的工具它都能直接调起来,不用来回复制粘贴。
|
||||
|
||||

|
||||
|
||||
Claude Code 实际更像个通用 Agent,叫 Code 只是因为最初定位偏写代码。Anthropic 自己分享过他们内部不少非工程团队比如销售、风控、财务都在拿它干活,处理 CRM 数据和客户邮件。如果你实在不想碰终端,可以用官方出的桌面应用 **Cowork**,能直接读写你的下载和文档目录,把收据截图拼成报销表这种活,你说一句话它也能给你干好。
|
||||
|
||||
还有一点我感觉很重要:写代码这件事上,模型快不快不重要,**准不准才重要**。它 10 分钟跑完然后你花 20 分钟 debug,远不如它 20 分钟跑完直接能验收来的舒服。
|
||||
|
||||
要让它准,前提是你给到的活本身就**目标清楚、结果好验收**,两个都满足的最适合交给它,好比你把活交给了一个非常直男但是技术非常厉害的程序员。
|
||||
|
||||

|
||||
|
||||
具体就这几类活:做原型和内部小工具,把需求和展示逻辑说清楚,第二天就能跑起来一版;处理 CSV、做销售报表,分组和计算逻辑写明白几分钟出结果;几十页合同提炼条款、对比版本差异这种文档活它最擅长;最后是给一堆链接或 PDF 让它从特定视角提炼信息,说清格式就行。
|
||||
|
||||
# 做一个只给你一个人用的软件
|
||||
|
||||
最阻碍新人写代码的第一步是不知道自己要做个啥。《纽约时报》专栏作家 Kevin Roose 提过一个概念叫 **software for one**:你不需要做给一百万人用的 App,可以做只给你一个人用的软件。
|
||||
|
||||
他给自己做过整理链接的 Stash,给孩子准备便当的 LunchBox Buddy。对你来说,可能是把语音批注转成会议纪要的工具,或者是每天提醒你三件事的小仪表盘。这种东西反而是产品和业务的同学最容易做成,毕竟只有你最懂自己每天的麻烦在哪。
|
||||
|
||||

|
||||
|
||||
# 一天到三个月的节奏
|
||||
|
||||
别一上来就想做个“像 Notion 那样的产品”,可以按下面这个节奏来,每一段都有摸得到的产出:
|
||||
|
||||

|
||||
|
||||
第 1 天先试水,让它改一个你手头现成的 Excel 或 Markdown 文档;第 1 周尝鲜,做一个单页个人主页或日报大盘 15 分钟就能跑起来;第 1 个月提效,挑一件每周重复做两三次的事变成一条命令或一个页面;第 3 个月进阶,选一个"software for one"的想法做一个只给自己用的小工具。
|
||||
|
||||
# 用 OpenCLI 把网页操作变成命令
|
||||
|
||||
很多运营日常是在浏览器里点点点:查后台、发消息、导报表。这些活其实能绕开界面,直接调背后的接口来做。
|
||||
|
||||
[OpenCLI](https://opencli.info/) 是我朋友卡比做的,它内置了小红书、知乎、Twitter/X、Bilibili 等几十个站点的 CLI 适配器,再加上一组通用的浏览器操作原语像点击、输入、抓取、截图。把网页动作变成一条命令,Claude Code 一句话就能调起来。
|
||||
|
||||
**小红书调研**,让 Claude Code 调 opencli xiaohongshu 抓数据,再做分类和热词提炼,原本浏览器里点半天的事一句话搞定。
|
||||
|
||||
**舆情汇总**,把 Twitter/X、Reddit、HackerNews 几个适配器组合起来,同一关键词在多个平台的讨论自动拼成一份日报。
|
||||
|
||||
**没适配的网站**,用浏览器原语命令描述一遍流程,比如开页面、输关键词、抓表格,Claude Code 自己拼出来。
|
||||
|
||||
Claude Code 还有个 **Routines** 功能,能把一段工作流存到云端,按定时、Webhook 或 GitHub 事件自动触发。我自己还没怎么深用,概念上像「周一早上自动跑一遍周报流程」这种事它能接管,感兴趣可以看[官方文档](https://code.claude.com/docs/en/routines)。
|
||||
|
||||

|
||||
|
||||
# CLAUDE.md:先把项目背景写清楚
|
||||
|
||||
很多人装好之后直接开问,结果每次都要重复交代背景,用一会就觉得很烦。原因几乎都一样:没建 CLAUDE.md。
|
||||
|
||||

|
||||
|
||||
它放在项目根目录,Claude Code 每次启动都会先读它,相当于你给新来的同事写的项目交接文档,区别是它每次都会从头认真读一遍而且严格执行。
|
||||
|
||||
写得好不好,三件事最关键。写得短一点,150 行以内为佳,写太长会挤压后续对话的空间。语气直接,用命令式,别写"我们团队比较喜欢"这种软话,"所有注释用中文"比"团队偏好中文注释"有效太多。每条都能判断,"代码质量要高"没用,"函数超过 50 行必须拆分"才能落地。
|
||||
|
||||
四条最值钱的规则,直接拿去用:先问清楚再动手、简单优先、只动该动的、做完要验证。展开就是:别让它猜你的意图,目标说清再写;能两行解决的不写两百行,拒绝过度设计;不要顺手重构没让它改的代码;跑通构建和测试才算完,没通过别说完成。
|
||||
|
||||
下面这份模板,你改一改项目背景就能直接用:
|
||||
|
||||
```markdown
|
||||
# 项目背景
|
||||
这是一个面向运营同学的客户看板,技术栈 Node.js + Next.js,
|
||||
前端用 React,数据库 PostgreSQL,部署在 Vercel。
|
||||
产品经理是 Alice,设计是 Bob,后端是我自己。
|
||||
|
||||
# 工作规范
|
||||
- 所有注释用中文,变量函数用英文。
|
||||
- 改动前先说明你打算改什么,确认后再动手。
|
||||
- 新功能先写实现,不主动加测试,除非我明确要求。
|
||||
- 数据库表名用下划线分隔,比如 user_profile。
|
||||
|
||||
# 禁止项
|
||||
- 不要主动重构我没提到的文件。
|
||||
- 不要删除任何文件,除非我明确说删掉。
|
||||
- 不要在没确认前直接执行 npm install 装新依赖。
|
||||
|
||||
# 压缩时保留
|
||||
长对话被自动压缩时,按优先级保留:
|
||||
1. 架构决策和它背后的理由
|
||||
2. 改过哪些文件、改了什么
|
||||
3. 当前进展状态
|
||||
4. 还没做完的 TODO
|
||||
```
|
||||
|
||||
最后这段"压缩时保留"看着不起眼,长会话能不能稳就靠它。Claude Code 的上下文用到一定程度会自动压缩,决策的理由通常是第一个被丢的。比如你之前说过"这里要用 POST 不用 GET,因为数据量大",压缩之后可能只剩"用 POST"三个字,理由没了。下次再问相关问题,它可能给你一个完全不同的方案,前后矛盾。把这一段写进去,长会话就不会前后打架。
|
||||
|
||||
上面这些不一定要自己从头写。装好 Claude Code 之后,直接说"读一下我这个项目,帮我生成一份 CLAUDE.md",它会扫一遍代码、技术栈、目录结构,给你一份草稿,你只要改一改人名和团队偏好。装依赖、配 alias、改 ~/.claude/settings.json 这些事也一样,告诉它要什么效果让它自己去试,比你查文档快得多。配置类的活能交就交,省下来的精力放到真正要判断的事情上。
|
||||
|
||||
# 需求描述越精确,它越少分叉跑偏
|
||||
|
||||
**模糊版**:帮我做一个客户跟进工具。 **精确版**:帮我做个销售用的跟进工具,单文件网页存本地。左边列表显示公司名、下次跟进时间、状态,右边详情包括沟通记录、日期、要点。顶部加三个筛选:状态、时间、关键词。数据存浏览器 localStorage,不调后端。
|
||||
|
||||

|
||||
|
||||
精确版当天就能跑出能用的版本,模糊版多半要返工。
|
||||
|
||||
再看一个完整精确版的样子,这是 yetone 给 Claude Code 写的 macOS 语音输入工具需求。代码细节看不懂没事,重点是看每条要求被拆得多具体。
|
||||
|
||||
```markdown
|
||||
帮我做一个 macOS 原生语音输入工具,用 Swift 开发:
|
||||
|
||||
1. 按住 Fn 键开始录音,松开后把转录文字注入当前光标所在的输入框。
|
||||
优先用流式转录(Apple Speech Recognition framework)。
|
||||
Fn 键通过 CGEvent tap 全局监听,需抑制 Fn 事件传递,
|
||||
避免触发 emoji 选择器。
|
||||
|
||||
2. 默认语言必须为简体中文(zh-CN),开箱即用就能识别中文。
|
||||
菜单栏可切换英文、繁中、日语、韩语,选项存到 UserDefaults。
|
||||
|
||||
3. 录音时屏幕底部居中显示一个无边框胶囊状悬浮窗:
|
||||
不要红绿灯和 titlebar,用 NSPanel(nonactivatingPanel)+
|
||||
NSVisualEffectView(.hudWindow 材质)。
|
||||
高度 56px,圆角 28px,左侧实时音频波形(5 根竖条,
|
||||
由 RMS 电平驱动),右侧转录文字(160-560px 弹性宽度)。
|
||||
入场弹簧动画 0.35s,文字宽度过渡 0.25s,退场缩放动画 0.22s。
|
||||
|
||||
4. 文字注入用剪贴板 + 模拟 Cmd+V。注入前检测当前输入法:
|
||||
如果是 CJK 输入法,先临时切到 ABC 键盘再粘贴,完成后恢复原输入法。
|
||||
注入完恢复原剪贴板内容。
|
||||
|
||||
5. 接入 LLM 提升识别准确率,处理中英文混杂场景。
|
||||
通过 OpenAI 兼容 API(可配置 Base URL、Key、Model)对转录文本做 refine。
|
||||
system prompt 要求极保守:只修复明显的语音识别错误
|
||||
(如"配森"→"Python"、"杰森"→"JSON"),
|
||||
绝不改写或润色看起来正确的内容,正确就原样返回。
|
||||
|
||||
6. 菜单栏提供 LLM Refinement 子菜单,含启用/禁用开关和 Settings 入口。
|
||||
Settings 窗口有 API Base URL、API Key、Model 输入框,含 Test 和 Save。
|
||||
松开 Fn 键后如果 LLM 已启用,悬浮窗显示 Refining... 状态,
|
||||
等返回后再注入。
|
||||
|
||||
7. 应用以 LSUIElement 模式运行(仅菜单栏图标,无 Dock 图标)。
|
||||
用 Swift Package Manager 构建,提供 Makefile(build/run/install/clean)。
|
||||
```
|
||||
|
||||
这种描述,Claude Code 几乎不用猜,直接产出一个能装的 macOS 应用。每一条都是在防它猜错一个具体的点:
|
||||
|
||||

|
||||
|
||||
你不需要会写 Swift,但需要把需求**写得这么细**。这份需求里每一条背后,都是 yetone 自己踩过的坑或者预想到的坑。每多一条具体细节,就少一次返工。
|
||||
|
||||

|
||||
|
||||
业务场景的需求,光描述功能还不够。开头先把问题写清楚,要解决什么、给谁用、怎么算做对了,别一上来就列功能清单。比如说我们要写一个国际门票频道页时第一句话就是"国际门票目前没有独立入口,用户只能搜索找到,非热门城市曝光极低",这两句话决定了它后面碰到"热门城市展示几个""筛选要不要做'最近浏览'"这类问题时的判断方向。
|
||||
|
||||
接下来要给它划范围。Claude Code 很积极,你说做一个列表页它顺手就给你加上收藏、分享、埋点。明确写出"不做登录态、不做分享、不做 SEO,下一期再说",它就不会越界。异常情况要单独列出来,接口超时怎么办、数据为空展示什么、图片挂了用什么兜底,这些不写它要么不处理,要么猜个你不满意的方案。
|
||||
|
||||
验收标准必须给数字,"页面要快"没用,"首屏 1.5 秒内"才能判断;"布局正常"没用,"在 375 和 1440 两个宽度下不错位"才能验收。
|
||||
|
||||
写需求的时候,别用"待定""后续再看""TBD"。Claude Code 碰到这些会自己猜着填,猜的往往不是你要的。哪怕写"这一版先硬编码,下版再做配置化",也比空着强。
|
||||
|
||||
# 复杂任务先对答案:Plan 与 Auto 模式
|
||||
|
||||
有次我让它重构登录模块,它顺手删了一个我后面要用的工具类,回滚花了半小时,让我想骂人。
|
||||
|
||||
从那以后,复杂一点的任务我都会先按两次 Shift+Tab 切到 **Plan 模式**。它会先把打算怎么做列出来,方向对了你再让它执行。其实就跟工作场景一样:你不会直接让小李把功能做掉,先拉个会过下方案,觉得 OK 了再动手。
|
||||
|
||||

|
||||
|
||||
Plan 模式产出的计划大概长这样:要改哪几个文件、每个文件改什么、改的理由是什么、预计会影响哪些地方。用业务逻辑来判断这个方向对不对,比判断代码本身容易得多。哪怕你看不懂代码,也能从"这一步要不要做、那一处理由对不对"把关。
|
||||
|
||||
如果你嫌每步都问太烦,可以开 **Auto 模式**,按 Shift+Tab 循环切到 auto 那一档,目前 Max、Team、Enterprise 都能用,Pro 暂时还没开。它会自己判断:读文件这种安全操作直接跑,改数据库、删文件这类风险操作才来问你。刚上手默认开它就行,既不会被无意义的确认打断,也不会让它瞎搞。
|
||||
|
||||
# 怎么确认它真的做对了
|
||||
|
||||
它跟你说"搞定了"其实没用,关键是你怎么验收,因为 AI 也喜欢偷懒。
|
||||
|
||||

|
||||
|
||||
## 改坏了怎么救回来
|
||||
|
||||
不会写代码的人最怕代码被改乱了找不回来,常用的就两条。
|
||||
|
||||
**Git 快照**,每次大改前让它先跑一遍 git status 看清楚都有什么,确认没问题再让它 commit 一个检查点。改坏了直接说"按刚才的检查点回退",比自己手动 checkout 安全得多。
|
||||
|
||||
**撤销上一步**,直接对它说"撤销刚才所有改动",或者按 /rewind 回到上一个状态。
|
||||
|
||||
## 别让它陷入改了试试的死循环
|
||||
|
||||
有个坑很容易踩:陷入改了试试的循环,4-5 轮下来本来不大的问题变成一团乱麻。原因就一个,没诊断清楚就开始打补丁。
|
||||
|
||||

|
||||
|
||||
避免方法也一句话:**根因没说清楚之前先别动代码**。让它先答"问题出在哪个文件的哪一行,为什么会这样",答含糊继续查,答清楚再改。一上来说"我试试改 X 看行不行"的,直接喊停让它先答根因。
|
||||
|
||||
# Max 进阶:alias、模型、长会话
|
||||
|
||||
刚上手不必看,等用熟了或者你感觉Pro完全不够你用的时候,再来翻这个都行。
|
||||
|
||||
## 我自己 Max 订阅怎么用
|
||||
|
||||
**alias**,我在 .zshrc 里加了一行,按 c 就直接启动一个不再问我权限的 Claude Code,同时把自动压缩点提前到 400k,等到上下文塞满才压效果会差,提前一点反而更舒服,你可以把这一段 copy 给你的 claude code 让他帮你来优化。
|
||||
|
||||
```text
|
||||
alias c='CLAUDE_CODE_AUTO_COMPACT_WINDOW=400000 claude --dangerously-skip-permissions'
|
||||
```
|
||||
|
||||
\--dangerously-skip-permissions 不建议刚上手的人用,它字面意思就是"危险跳过所有权限确认",意味着 Claude Code 不会再问你任何事。我自己用是因为我能看懂它每一步在做什么,加上确实嫌反复确认烦。如果你还没到这个程度,老老实实用 Auto 模式就好。
|
||||
|
||||
**模型用 opusplan**,我现在这套用法是输入 /model opusplan 这个隐藏命令就开启。它会用 Opus 做规划,用 Sonnet 做执行,规划用最强的脑子,执行用速度更快的,整体省钱也省时间。想更快可以再跑 /fast,刚好补回上面省下来的 token。
|
||||
|
||||
**关键配置**,如果你当前版本支持,用 opusplan 时去 ~/.claude/settings.json 里把 showClearContextOnPlanAccept 设成 true,不然会在 Sonnet 这一段碰到严重的缓存未命中,速度会明显慢下来。这个设置一开,整体就好多了,当时一个国外的用户告诉我的,很好用。
|
||||
|
||||
## 长会话怎么办
|
||||
|
||||
Claude Code 的工作台是固定大小,跑久了早期内容会被挤出去。
|
||||
|
||||

|
||||
|
||||
**任务做完就 /clear**,一个会话只做一件事,做完清掉再开下一件,两件不相干的事在同一个上下文里来回切,它会越做越乱。
|
||||
|
||||
**长任务结束前让它写交接笔记**,直接对它说:"把当前进度写成一份 HANDOFF.md,包括做了什么、试过什么没成功、下一步该做什么。" 第二天打开新会话,把这个文件给它,就能接着干,不依赖任何压缩算法。
|
||||
|
||||
# Waza:把好习惯沉淀成肌肉记忆
|
||||
|
||||
AI 可以让明确敲代码的活做得很快,但事情本身要做成什么样子其实需要你自己来定。我最近折腾了一套叫 [Waza](https://github.com/tw93/Waza) 的 Skill,一共8 个技能对应一个好工程师该有的 8 个习惯。
|
||||
|
||||

|
||||
|
||||
/think 是动手前先想一下技术方案,AI 写代码很快,但方向错了越快越远,先质疑问题本身、把方案上都思考好后,再让它跑。
|
||||
|
||||
/design 是给帮你设计一个产品化的页面,拒绝那种蓝紫渐变 + 一堆 emoji 的 AI 模板感。
|
||||
|
||||
[/hunt](https://github.com/tw93/Waza/tree/main/skills/hunt) 是排查问题的,原则只有一条:根因没说清楚之前先别动代码,避免改了试试的死循环。
|
||||
|
||||
[/check](https://github.com/tw93/Waza/tree/main/skills/check) 是收工前的最后检查,diff 审一遍,能自动修的修掉,它拿不准的归拢起来再问你。
|
||||
|
||||
剩下四个偏日常:/read 把任意网页或 PDF 转成干净的 Markdown 进工作流,/write 让你的表达更清晰,/learn 是一套从收资料到出文章的研究流程,/health 给你的 CLAUDE.md 和各种规则做个体检,你感觉Claude不好用的时候运行一下试试。
|
||||
|
||||
其中我最建议产品、业务、运营先试的是 /design,截图丢给它带上 /design,它不会立刻动手,会先反问你给谁用、想要什么气质、最不喜欢哪种风格、有没有想让用户记住的微交互,回答完再动手,效果通常比直接说"帮我改一下样式"稳定。
|
||||
|
||||
# 你也可以自己写一个 Skill
|
||||
|
||||
Skill 本质就是一个文件夹,放在 .claude/skills/ 目录下,里面有个 SKILL.md 写清楚什么时候用、要做什么。Claude Code 启动时只读 frontmatter,也就是描述触发条件的约 100 个字,真正调用时才加载完整内容,所以你装几十个 Skill 启动也不会变慢。
|
||||
|
||||

|
||||
|
||||
**第一种是工作流型**:把每次都要做的固定步骤打包。比如整理周会纪要:
|
||||
|
||||
```markdown
|
||||
---
|
||||
name: 整理周会
|
||||
description: 开完会有原始记录需要整理时调用
|
||||
---
|
||||
|
||||
## 输出格式
|
||||
**本周达成**:[负责人] 完成了什么
|
||||
**下周计划**:[负责人] 做什么,截止时间
|
||||
**待讨论**:卡在哪里,需要谁来决定
|
||||
**行动项**:[谁] [做什么] [什么时候]
|
||||
|
||||
## 规则
|
||||
- 不润色,保持原始措辞
|
||||
- 信息缺失就标注"待确认",不要猜
|
||||
```
|
||||
|
||||
**第二种是检查清单型**:上线前、发版前、提交前过一遍,避免漏项,比如需求上线检查:
|
||||
|
||||
```markdown
|
||||
---
|
||||
name: 需求上线检查
|
||||
description: 需求发布前跑一遍,确认没有遗漏
|
||||
---
|
||||
|
||||
## 上线前必须全部通过
|
||||
- [ ] PRD 里的验收标准逐条确认
|
||||
- [ ] 设计稿和实现对齐,间距、文案、交互没漏
|
||||
- [ ] 异常状态(空态、报错、超时)都有处理
|
||||
- [ ] 数据埋点按规范打好
|
||||
- [ ] 测试环境验证通过
|
||||
|
||||
## 输出
|
||||
每项 Pass / Fail,有 Fail 必须修完再发布。
|
||||
```
|
||||
|
||||
**第三种是领域专家型**:把判断框架沉淀进去,碰到这类问题按固定路径走,不让它每次自由发挥,比如线上问题排查,以及你们平时的业务最佳实践的 SOP。
|
||||
|
||||
```markdown
|
||||
---
|
||||
name: 线上问题排查
|
||||
description: 收到线上告警或用户反馈异常时调用
|
||||
---
|
||||
|
||||
## 收集信息
|
||||
- 报错截图或错误日志的完整内容
|
||||
- 影响范围:哪些用户、哪个页面、什么时间开始
|
||||
- 最近的变更:代码发布、配置修改、数据变更
|
||||
|
||||
## 判断矩阵
|
||||
|
||||
| 现象| 优先检查 |
|
||||
| 页面白屏 | JS 报错 → 最近发布记录 |
|
||||
| 接口超时 | 服务监控 → 数据库慢查询 |
|
||||
| 数据异常 | 最近数据变更 → 上下游依赖 |
|
||||
|
||||
## 输出格式
|
||||
根因 / 影响范围 / 修复步骤 / 验证方式
|
||||
```
|
||||
|
||||
写好之后,把它放到 .claude/skills/ 文件夹下,碰到对应场景说一句"用整理周会"或"用线上排查"就行,这里你也可以让 Claude 帮你写,此外两个写 Skill 的小坑要避一下。
|
||||
|
||||
**description 写触发条件,不写功能介绍**,"开完会有原始记录需要整理时调用"比"把会议录音整理成结构化周报"准确率高得多。
|
||||
|
||||
**一个 Skill 只做一件事**,别把审查、发布、调试塞在一起,拆开用起来才更准。
|
||||
|
||||
## Kami:让 AI 帮你排版出专业文档
|
||||
|
||||
写完内容只是第一步,排版成能发出去的东西往往更耗时间。[Kami](https://github.com/tw93/Kami) 是也是我最近做的 AI 排版设计工具,你把内容丢给它,说一句"帮我排成一页纸"或"做个作品集",它会生成一份可下载的 PDF。
|
||||
|
||||
它有 8 套模板:一页纸、作品集、幻灯片、Resume、长文档、信件、研报、Changelog。风格统一,暖底色、墨蓝色点缀、衬线字体为主。中文用苍耳今楷,英文用 Charter,不需要自己调字体。
|
||||
|
||||

|
||||
|
||||
最实用的几个场景:会议纪要排成简报、项目进展排成一页纸给老板。以前这些活得开 Word 或 Figma 折腾半天,现在把内容丢进去,先出一版能看的稿子,再微调。
|
||||
|
||||
# Claude Design:不写代码也能出原型
|
||||
|
||||
2026 年 4 月推出的 [Claude Design](https://claude.ai/design) 是另一条路:你上传截图或文档,它直接给你个能交互的原型、幻灯片或落地页,这个对于不懂设计的非技术同学挺好用。
|
||||
|
||||

|
||||
|
||||
还不想碰代码的话,用它先出个能展示的想法准没错。产品经理可以用它画原型开评审,过了直接把原型扔给 Claude Code 变代码。早期原型不用等完整设计和研发排期,当天就能拿出来讨论。
|
||||
|
||||
# 用熟之后的几个小习惯
|
||||
|
||||
**截图比文字快**,要描述一个界面问题或者想参考某个设计风格,直接丢图比写一段话准多了,布局、颜色、层级都带进来了,让它少猜。
|
||||
|
||||
**任务拆小一件件来**,一句话能讲清楚的任务它几乎不会出错。一上来给一大坨需求,它中间任意一步走偏后面就全偏了,一件做完验收一件再开下一件。
|
||||
|
||||
**对话跑偏了就重启**,在已经跑偏的对话里来回纠正它越纠越乱,清掉上下文重说一遍需求往往更快。第二天接着干,先翻一眼上次的 Recap(/clear 后会自动生成的会话摘要)想起来干到哪了。
|
||||
|
||||
**Memory 跨项目记住你的偏好**,CLAUDE.md 是项目级的每个项目都得单独写一份,Memory 是用户级的跨所有项目和会话都生效。直接对它说"记住我喜欢先看方案再执行"、"记住回我中文",它会写进 ~/.claude/memory/,以后任何项目打开都记得。常交代的背景信息都可以沉淀进去,省得每次重复说。
|
||||
|
||||
**双击 ESC 改上一条**,说错了或者它跑偏了,按两下 ESC 就能回到上一条消息修改,不用重开会话。
|
||||
|
||||
# 几个安全考虑点需要注意的
|
||||
|
||||

|
||||
|
||||
**让它先解释再动手**,在 CLAUDE.md 里加一条:"每次执行 Bash 命令或修改文件前,先用一句话解释要做什么。" 它就会在每步操作前先告诉你它打算干嘛,看不懂代码没关系,看得懂"我要删掉这个文件"就够了。
|
||||
|
||||
**看不懂的命令先问**,它要跑一条你没见过的命令别直接放行,先问它"这条命令具体做了什么、有什么风险",看懂了再点确认,不要 Copy 任何你不懂的命令去执行,说不定会把你的账号或者个人信息都给盗取了。
|
||||
|
||||
**生产环境不要拿来练手**,本地和测试环境随便折腾,但涉及生产数据库、线上配置的操作一定先在测试环境验证。一条写错的 SQL 或一次误删,回滚成本远高于你预期。
|
||||
|
||||
**密钥别直接粘到对话里**,要配置 API Key、数据库密码这类东西,让它放到环境变量或者 .env 文件里,不要直接把明文贴到聊天窗口。
|
||||
|
||||
还有一条容易被忽略但很要紧:能跑不代表安全,AI 生成的代码可能有漏洞,涉及登录、支付和个人信息的功能,能用 Clerk 或 Stripe 这种现成服务就别让它从零写。
|
||||
|
||||
# 加深了解
|
||||
|
||||
1. [你不知道的 Claude Code:架构、治理与工程实践](https://tw93.fun/2026-03-12/claude.html)
|
||||
2. [你不知道的 Agent:原理、架构与工程实践](https://tw93.fun/2026-03-21/agent.html)
|
||||
3. [你不知道的大模型训练:原理、路径与新实践](https://tw93.fun/2026-04-03/llm.html)
|
||||
4. [Claude Code Best Practices - Anthropic 官方](https://code.claude.com/docs/en/best-practices)
|
||||
5. [vibe coding - Andrej Karpathy 原始推文](https://x.com/karpathy/status/1886192184808149383)
|
||||
6. [Claude Skills are awesome, maybe a bigger deal than MCP - Simon Willison](https://simonwillison.net/2025/Oct/16/claude-skills/)
|
||||
7. [Malleable software in the age of LLMs - Geoffrey Litt](https://www.geoffreylitt.com/2023/03/25/llm-end-user-programming.html)
|
||||
8. [Claude Code Skills 完全指南 - Datawhale Easy Vibe](https://datawhalechina.github.io/easy-vibe/zh-cn/stage-3/core-skills/skills/)
|
||||
9. [Claude Code Starter Pack: Tools, Tutorials & Resources - AI Edge](https://x.com/aiedge_/status/2011108297152082250)
|
||||
10. [When the Vibes Are Off: The Security Risks of AI-Generated Code - Lawfare](https://www.lawfaremedia.org/article/when-the-vibe-are-off--the-security-risks-of-ai-generated-code)
|
||||
@@ -0,0 +1,128 @@
|
||||
---
|
||||
title: "写作中的AI味是哪儿来的"
|
||||
source: "https://yage.ai/share/ai-chinese-translationese-20260418.html"
|
||||
author:
|
||||
- "[[鸭哥]]"
|
||||
published: 2026-04-18
|
||||
created: 2026-04-24
|
||||
description: "AI 写的中文有一股味儿,换模型、换 prompt 都去不掉。这篇文章说一个观察:这股味儿不是新问题,是翻译腔。文章识别了四种最常见的翻译腔套路,逐一举例说明它们从哪里来、为什么在中文里站不住,以及怎么改。"
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||
AI 写的中文有一股味儿。
|
||||
|
||||
每个用过的人都闻得出来。读一段话,你说不上它哪个字错了,语法也对,意思也通,就是读起来别扭。有时候甚至读两行就能认出这是 AI 写的。换模型也好,换 prompt 也好,叫模型模仿你的风格也好,这股味儿只是变淡一点,始终都在。
|
||||
|
||||
这篇想说一个观察: **AI 味很大程度上就是翻译腔** 。你闻到的那股味儿,是民国以来中国读者已经吐槽了一百年的老翻译腔,只不过现在被 AI 批量生产出来了。认出这一点以后,处理起来就简单了,因为翻译腔的套路是有限的。下面先让你对上号,然后再讲怎么改。
|
||||
|
||||
## 先看几句典型的 AI 味
|
||||
|
||||
这几句都是我自己和 AI 聊天时,AI 在几个小时前刚说的话。真实出处,没有挑选。
|
||||
|
||||
「明白了,三条反馈都很关键,我都接住。」
|
||||
|
||||
「迁移到我们现在的问题,就得到一个更锋利的重构:」
|
||||
|
||||
「你的直觉被数据验证了,而且验证得比我预期的更干净:」
|
||||
|
||||
「context 不崩、成本不爆、state 可恢复、cache 命中率高。」
|
||||
|
||||
「如果找不到,原断言可以 claim 更硬。」
|
||||
|
||||
读这几句的时候你大概会觉得熟悉。它们就是那个味儿。但如果问每句具体哪儿不对,你可能一时说不上来。AI 味最让人头疼的地方就在这里:错别字和病句一眼就能抓住,AI 味却是一种整体的违和感,你得通读完整段话才能感觉到。
|
||||
|
||||
## 这股味儿叫翻译腔
|
||||
|
||||
把这几句倒过来看它们原本长什么样,你会发现一件事:每一句都能顺顺当当翻回英文。
|
||||
|
||||
「我都接住」是 “I caught all of them”。「更锋利的重构」是 “a sharper refactoring”。「验证得比我预期的更干净」是 “verified cleaner than I expected”。「不崩」「不爆」是 “doesn’t break”、“doesn’t blow up”。「claim 更硬」直接一半都没翻。
|
||||
|
||||
反过来翻进日常中文要费劲得多。你这几条我都收到了。挪到我们眼下这个问题上,能换一种更准的讲法。数据把你的感觉证出来了,而且比我想得更干净利落。上下文不会乱掉,成本压得住,状态能恢复,缓存命中得上。查不到的话,这个判断还可以说得再重一点。这些才是中文里本来的说法。
|
||||
|
||||
所以这股 AI 味,本质上是 **骨架为英文的中文句子** 。每一个字都是中文,每一处语法都合规,但句子的骨架、主谓搭配、动词选择、段落节奏,全是英文的。鲁迅用过翻译腔这个词,王小波骂过,民国到现在一百年里每一代中国读者都跟它打过交道。只是以前的翻译腔来自翻译家和留学生,数量有限,读者接触得少。现在 AI 一天生产的翻译腔文字比过去一年还多,大家天天读,读多了就给它起了个新名字叫 AI 味。
|
||||
|
||||
认出这一点以后,问题就从一个朦胧的语感变成了一个具体的技术活。翻译腔的套路是有限的,下面四种是我在自己的 AI 生成稿里反复遇到的,也是最常见的。
|
||||
|
||||
## 套路一:用物理动作描述思考过程
|
||||
|
||||
「明白了,三条反馈都很关键,我都接住。」
|
||||
|
||||
「接住」是个有意思的词。听起来有力量感,像一个干脆的动作。但停下来想一下,中文里描述理解和采纳反馈,日常怎么说?「你这几条我都收到了。」「你说的几点我都记下了。」「这三条我都同意。」日常说的都是收到、记下、同意这类词。「接住」是英文 catch 的直译。catch a point、catch the ball、catch the meaning 在英文里都自然,因为英文背后有棒球、橄榄球、接球游戏这一整套生活经验。中文里没有这套生活,这个动词就悬空了。
|
||||
|
||||
开头那五句里还有好几个同样悬空的词。「更锋利的重构」里的「锋利」来自英文 sharp,把描述刀刃的形容词挪来修饰论证。英文里 a sharp argument 有几百年沉淀,中文里没有。「context 不崩」、「成本不爆」里的「崩」和「爆」来自英文 break、blow up,把系统状态说成脆弱的物理物件。「claim 更硬」里的「硬」来自 hold harder,把判断变成了一个可以捏紧的东西。
|
||||
|
||||
把这类词列一份:锋利、击穿、拆解、收口、承担、撑不住、不崩、不爆、打穿、收紧、落地、推开、扛住。每一个都是把思考过程想象成了物理动作。
|
||||
|
||||
这个套路最难戒,因为它听起来最有味道。读到「这个论证被击穿了」,你会觉得作者判断鲜明。但中文里本来怎么说同一件事?「这个假设不成立。」「反例让这个结论站不住脚。」「这句话让原来的判断失效。」这些句子没有力量感,但它们准确说清了发生了什么。好写作靠的是准确,力量感只是副作用。
|
||||
|
||||
我自己修稿时的办法:写完一段以后把所有动词圈出来,看哪个动词在中文日常里不会这样用。不会这样用的,十有八九是从英文翻过来的物理动作。挨个换掉。
|
||||
|
||||
## 套路二:用形容词替读者先下判断
|
||||
|
||||
「迁移到我们现在的问题,就得到一个更锋利的重构:」
|
||||
|
||||
「你的直觉被数据验证了,而且验证得比我预期的更干净:」
|
||||
|
||||
注意「更锋利」后面带冒号,「更干净」后面也带冒号。这是 AI 写作里最常见的套路之一:形容词先下判断,冒号引出内容。同类的还有「逻辑很清晰:」「问题很直接:」「结论很明确:」「原因很简单:」。
|
||||
|
||||
问题出在三个地方。第一,它抢走了读者自己评估的机会。读完具体内容,读者本来会自己得出「确实挺清楚的」这个感受,但作者提前告诉你这很清楚,读者自己得出结论的体验就没了。第二,这个形容词几乎总是多余的。后面的事实本身就能让「清楚」「简单」「直接」的感觉浮出来,不需要形容词先铺垫。第三,它的英文原型 “Quite simply, …” 和 “The answer is clear: …” 在英文里也被诟病多年,是公文腔的标志。翻进中文更是双重别扭。
|
||||
|
||||
改法就是直接把形容词那一节删掉,只留后半句事实。「迁移到我们现在的问题,可以这样换一种讲法:」把「更锋利的重构」这六个字直接拿掉。「数据把你的感觉证出来了:」「更干净」直接删。读者照样理解,而且读得更顺。
|
||||
|
||||
如果你发现自己非常想保留那个形容词,那多半说明后面的内容没讲清楚,你在用一个评价词遮掩。这时候应该回头补内容,靠内容本身说服读者。
|
||||
|
||||
## 套路三:用抽象名词做主语,用形容词当结论
|
||||
|
||||
开头那五句跳过了这个套路,但它在 AI 写作里极其常见。举一句我同一段对话里写的:「工程上的现实比这些数字难看。」
|
||||
|
||||
这一句有两处问题。一是用「工程上的现实」这种抽象名词堆做主语。中文口语里自然的说法是「实际跑起来」「真要用的时候」「落到工程里」。二是用「难看」这种评价词去概括一整片复杂情况。读完你其实不知道到底哪儿难看,难看在哪个环节。
|
||||
|
||||
英文原型太熟了。“The reality is uglier than…”, “The evidence is more direct…”, “The complexity is open-ended…” 抽象名词开头,评价词收尾,中间用系动词连起来。英文读者对这种句式有长期默契,会自动预期后面跟展开说明。中文读者的阅读习惯不同,读完「难看」就停在那了。
|
||||
|
||||
改的时候让人、动作、或者具体对象做主语,让事实自己说话。「这些数字只反映了采用面;真往下看各家怎么接,早就对不齐了。」主语从「现实」换成了「数字」和「各家」,谓语从「难看」换成了具体动作「对不齐」。读者读完知道了到底是什么在错位。
|
||||
|
||||
凡是碰到「X 的 Y 比 Z 更 W」这种骨架,都应该重写。
|
||||
|
||||
## 套路四:有中文译法的英文词直接混入句子
|
||||
|
||||
最后一个套路,开头五句里也给了最干脆的例子:
|
||||
|
||||
「context 不崩、成本不爆、state 可恢复、cache 命中率高。」
|
||||
|
||||
「如果找不到,原断言可以 claim 更硬。」
|
||||
|
||||
这种句子读起来有一种半翻译的生硬感。context、state、cache、claim 这些词都有现成的中文对译:上下文、状态、缓存、断言。AI 在生成过程中有时候懒得翻,有时候判断读者自己会翻,结果就让英文单词原样留下了。
|
||||
|
||||
问题在于这让读者分心。读到 context 你要在脑子里切换一下:哦,上下文。读到 claim 更硬你要切两次:claim 是断言,更硬是说更强。每一次切换都消耗一点注意力。一段话里切七八次,读完就累了。
|
||||
|
||||
这个套路在圈内技术讨论里影响小一些,因为技术词汇本来就有英文版本,大家读起来都快。但一旦进入面向更广读者的文章,夹英文就变成障碍。正式写作里有一条可以执行的规矩:除非这个英文词在中文里没有稳定译法(比如 prompt、embedding、tokenizer 在中文技术圈还在抢术语),否则全部换成中文。上下文、状态、缓存、断言、运行时、协议层、契约层,这些都已经有稳定译法,直接用。
|
||||
|
||||
开头五句里的 harness 是一个例外。这个词在 2026 年的 agent 讨论里还没有收敛到一个通用中文词,运行时、框架、客户端、载体都在用但都不精确。这种情况下保留英文是合理的。怎么判断?中文圈里讨论这个概念还没统一术语,就保留英文;已经统一了,就换中文。
|
||||
|
||||
## 为什么 AI 写中文必然带翻译腔
|
||||
|
||||
这四个套路看着是四种毛病,其实是同一个问题的四个侧面。问题就是翻译腔。
|
||||
|
||||
AI 写中文为什么会有翻译腔,可以有很多种回答:训练语料的中英文比例、模型内部表征、后训练的风格偏好。这些解释都有道理,但我觉得不用走那么远。一个更简单的观察是,AI 写中文的时候,看起来像是先在英文的句法里把意思想清楚,再一个字一个字换成中文。这是行为上的表现,至于底层是不是真的这样只有训练它的人知道。但从读者这端看,效果就是这样。句子的骨架留在了英文里,只有皮被换成了中文词汇。
|
||||
|
||||
翻译家这个行当过去一直知道这个问题。好的译者花一辈子练的,就是 **从英文原文出发,不经过英文句法,直接写出中文读者日常习惯的表达** 。这一步在翻译学里叫归化。钱钟书、许渊冲、傅雷都谈过这件事。他们的经验说穿了就是一条:读完原文,把原文盖上,用中文重新说一遍。
|
||||
|
||||
这个方法对 AI 生成的中文也管用。当你发现一段 AI 写的中文读着别扭,别在原句上修修补补,改成重写。先把意思理清楚,然后用中文里本来会怎么说这件事,重新说一遍。
|
||||
|
||||
## 最后一个小练习
|
||||
|
||||
下次让 AI 起草超过三段的中文内容,读完第一遍先不改字,只做一件事:把下面四类东西圈出来。
|
||||
|
||||
一,思考过程里用的物理动作动词。接住、击穿、拆解、锋利、不崩、撑不住这些。
|
||||
|
||||
二,段落开头或句首的「X 很 Y:」起手式,尤其是形容词后面跟着冒号的。
|
||||
|
||||
三,抽象名词做主语、形容词收尾的句子,比如「X 的 Y 比 Z 更 W」这种骨架。
|
||||
|
||||
四,有现成中文译法却还留着的英文单词。
|
||||
|
||||
圈完你会发现这四类的密度大得出乎意料。一段两百字的 AI 中文,常常能圈出五到八处。然后一处一处改。改完再通读一遍,通常会发现语气回到了中文里该有的样子。
|
||||
|
||||
翻译腔消耗读者的注意力,这才是它真正的代价。读者一部分注意力花在解析句式本身上,剩下的才够用来理解内容。一段中文如果干净,读者感觉自己在直接接触内容,句式完全隐形。做到这一点,AI 味自然就消失了。
|
||||
|
||||
你闻到的 AI 味,很大程度上就是翻译腔。
|
||||
@@ -0,0 +1,224 @@
|
||||
---
|
||||
title: "多Agent系统背后的数学道理"
|
||||
source: "https://x.com/zhengyun/status/2047345314978582764"
|
||||
author:
|
||||
- "[[@zhengyun]]"
|
||||
published: 2026-04-24
|
||||
created: 2026-04-24
|
||||
description: "10 个月前,也就是 2025 年 6 月,Cognition AI 写了一篇小作文,题目大概意思是:别建多智能体(Multi-Agent)。10个月前:别试多智能体Cognition AI 曾在2024年推出过全球首个全自主 AI 程序员 Devin。他们的理由很充分:子 Ag..."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||

|
||||
|
||||
10 个月前,也就是 2025 年 6 月,Cognition AI 写了一篇小作文,题目大概意思是:别建多智能体(Multi-Agent)。
|
||||
|
||||

|
||||
|
||||
10个月前:别试多智能体
|
||||
|
||||
Cognition AI 曾在2024年推出过全球首个全自主 AI 程序员 Devin。
|
||||
|
||||
他们的理由很充分:子 Agent 之间缺乏上下文共享,决策过程是黑箱,容易互相扯皮,最后产出还不如一个单 Agent。
|
||||
|
||||
结果呢?
|
||||
|
||||
昨天,也就是 2026 年 4 月 22 日,他们又写了一篇小作文,题目变成了:怎样才能让多智能体真正有效。
|
||||
|
||||

|
||||
|
||||
昨天,多智能体怎么才能真正有效
|
||||
|
||||
10 个月前说“别建”,10 个月后说“怎么建”。
|
||||
|
||||
我跟你说,这个反转背后,其实藏着一个特别有意思的事儿:
|
||||
|
||||
AI 为什么会产出“平庸”的方案?
|
||||
|
||||
鸭哥之前写过一篇文章,论述 AI 为什么会产出普通又平庸的方案。
|
||||
|
||||
我读完了,觉得特别透彻。
|
||||
|
||||
但我想从数学的角度,沿着他的思路,再往下挖一层。
|
||||
|
||||
大语言模型通过学习,把人类的知识压缩进了参数空间里。
|
||||
|
||||
这些知识不是散乱的,而是形成了一个个“盆地”。
|
||||
|
||||
**在数学上,我们管这叫“吸引子”(Attractor)。**
|
||||
|
||||
当模型在生成内容时,它其实是在这些盆地之间滑行。
|
||||
|
||||
只不过,模型并不是在一个固定的地形上滚动。
|
||||
|
||||
模型是在一个被上下文不断重塑的动态地形上滚动的。
|
||||
|
||||
如果你的工作,刚好落在这些“隐性先验”的范畴内(比如写个周报、读书笔记,做个常规方案,模仿一下巴菲特),模型就会自然而然地滑入那个“高概率吸引子”的盆地。
|
||||
|
||||
这个盆地有什么特点?
|
||||
|
||||
**稳定、自洽、但平庸。**
|
||||
|
||||
单 Agent 的问题就在这里。
|
||||
|
||||
它太容易滑进那个“平庸的盆地”了。而且一旦滑进去,它就出不来了。
|
||||
|
||||
**因为它所有的推理,都基于同一个参数空间,同一个隐性先验。**
|
||||
|
||||
**无论你怎么让它扮演各种角色,都不行。**
|
||||
|
||||
单 Agent,就像是一个门派里的近亲繁殖。
|
||||
|
||||
它逻辑自洽,招式连贯,但就是容易平庸。
|
||||
|
||||
为什么?
|
||||
|
||||
因为它的所有输出,都来自同一个“祖师爷”(同一个模型权重)。
|
||||
|
||||
你让它写方案,它给你的是它见过的所有方案的“平均值”。
|
||||
|
||||
你让它写代码,它给你的是 GitHub 上最常见的写法。
|
||||
|
||||
它不会犯错,但也绝不会给你惊喜。
|
||||
|
||||
这就是“平庸且自洽”。
|
||||
|
||||
而且,更可怕的是“上下文腐烂”(Context Rot)。
|
||||
|
||||

|
||||
|
||||
上下文腐烂
|
||||
|
||||
什么意思?
|
||||
|
||||
就是当 Agent 在同一个上下文里待久了,它的思路会越来越窄,越来越被之前的输出所束缚。
|
||||
|
||||
它不是在“思考”,它是在“续写”。
|
||||
|
||||

|
||||
|
||||
腐烂机制
|
||||
|
||||
既然单 Agent 容易滑入“平庸盆地”,那多 Agent 能干嘛?
|
||||
|
||||
理论上,多 Agent 能覆盖到更多的吸引子。
|
||||
|
||||
A Agent 滑入 A 盆地,B Agent 滑入 B 盆地。
|
||||
|
||||
如果 A 和 B 的盆地不一样,那你就能得到两种完全不同的方案。
|
||||
|
||||
这时候,就有可能产生“灵机一动”的效果。
|
||||
|
||||
但是!
|
||||
|
||||
这里有个巨大的陷阱。
|
||||
|
||||
如果 A 和 B 共享同一个上下文,共享同一个隐性先验,那它们其实还是在同一个大盆地里的不同小坑里打转。
|
||||
|
||||
这就解释了为什么 Cognition AI 10 个月前说“别建多智能体”。
|
||||
|
||||
因为大多数人的多 Agent,只是“单 Agent 的接力赛”。
|
||||
|
||||
A 写完,B 接着写。B 看到了 A 的上下文。
|
||||
|
||||
结果是什么?
|
||||
|
||||
B 被 A 带偏了。B 不再是 B,B 变成了 A 的附庸。
|
||||
|
||||
信息传递的损耗,加上上下文的污染,最后产出的,可能比单 Agent 还要平庸。
|
||||
|
||||
说到这,Cognition AI 昨天的那篇文章,就特别有意思了。
|
||||
|
||||
他们做了两个实验。
|
||||
|
||||
说实话,看着挺“蠢”的。
|
||||
|
||||
但效果特别爆。
|
||||
|
||||
实验一:Devin 写代码,另一个 Devin 审代码。
|
||||
|
||||
注意,这两个 Devin,绝不共享上下文。
|
||||
|
||||
审代码的那个 Devin,就像一张白纸。它不知道写代码的那个 Devin 在想什么。
|
||||
|
||||
Cognition AI 说,这是为了防止“上下文腐烂”。
|
||||
|
||||
实验二:便宜模型做主力工程师,关键时刻找昂贵模型来帮忙。
|
||||
|
||||
用便宜的模型干脏活累活,遇到卡壳的地方,再请昂贵的模型来“指点迷津”。
|
||||
|
||||
它打破了我们对多 Agent 的固有认知。
|
||||
|
||||
**我们以前以为,多 Agent 就是要“共享信息”,要“协同工作”。**
|
||||
|
||||
但 Cognition AI 告诉我们:
|
||||
|
||||
**不。多 Agent 的核心,是“制造隔离”。**
|
||||
|
||||
写到这儿,你可能突然明白了。
|
||||
|
||||
为什么那个“不共享上下文”的实验会有效?
|
||||
|
||||
因为你在改变约束条件。
|
||||
|
||||
在数学上,这就像是在地形上人为地制造了一个“分水岭”。
|
||||
|
||||
你让写代码的 Devin 在一个盆地,审代码的 Devin 在另一个盆地。
|
||||
|
||||
它们不再共享同一套隐含偏好。
|
||||
|
||||
写代码的 Devin 可以尽情地在“实现”的盆地里滑行。
|
||||
|
||||
审代码的 Devin 可以尽情地在“挑刺”的盆地里滑行。
|
||||
|
||||
它们之间没有"上下文污染"。
|
||||
|
||||
这就是Harness( Harness 机制)。
|
||||
|
||||
通过改变约束条件,让不同 Agent 拥有不同的认知框架和判断标准。
|
||||
|
||||
如果你真正想要“进入不同类型的解空间”,你必须这么做。
|
||||
|
||||
否则,多 Agent 只是在同一个盆地里的“无效折腾”。
|
||||
|
||||
这就像武侠小说里的历练。
|
||||
|
||||
单 Agent,就像是一个弟子,在同一个门派里闭关修炼。
|
||||
|
||||
他练得再好,也是“近亲繁殖”。他的招式,跳不出师门的框框。
|
||||
|
||||
多 Agent,就像是你把这个弟子,扔到不同的幻境空间里去历练。
|
||||
|
||||
幻境 A 里全是剑客,幻境 B 里全是刀客。
|
||||
|
||||
他在幻境 A 里学到的,和幻境 B 里学到的,完全不同。
|
||||
|
||||
而且,最关键的是,幻境 A 和幻境 B 之间,几乎没有什么上下文传递。
|
||||
|
||||
他每次进入幻境,都是“白纸”状态。
|
||||
|
||||
好了,说了这么多,这跟我们有什么关系?
|
||||
|
||||
我觉得还是挺重要的。
|
||||
|
||||
首先,它让我们重新理解“多 Agent”。
|
||||
|
||||
多 Agent 本身并不能自动带来突破。
|
||||
|
||||
**如果只是简单地让多个 Agent 接力完成任务,它们仍然会在同一个隐性先验盆地中滑行。**
|
||||
|
||||
甚至可能因为信息传递的损耗,产出更平庸的结果。
|
||||
|
||||
其次,它给了我们一个设计 Agent 的方法论。
|
||||
|
||||
**真正的突破,来自 Harness——通过改变约束条件,让每个 Agent 拥有不同的认知框架。**
|
||||
|
||||
就像 Cognition AI 的实验:一个写,一个审,绝不共享上下文。
|
||||
|
||||
最后,它让我们重新理解“平庸”本身。
|
||||
|
||||
平庸,不是因为没有知识,而是因为太容易滑入“高概率吸引子”。
|
||||
|
||||
要打破平庸,就必须制造“隔离”,制造“不同”。
|
||||
|
||||
这样,他才能看到不同的风景。
|
||||
@@ -0,0 +1,76 @@
|
||||
---
|
||||
title: "当 agent 足够强之后,我们该如何把它们组织起来"
|
||||
source: "https://x.com/t1anyufan/status/2047961721290281090"
|
||||
author:
|
||||
- "[[@t1anyufan]]"
|
||||
published: 2026-04-25
|
||||
created: 2026-04-26
|
||||
description: "一个有趣的现象是,之前大家讨论“agent loop的底层”的时候,通常是在讨论一个模型,而到了现在,大家讨论的loop的底层逐渐从模型转为了cc/codex,也就是把强大的coding agent本身当成一个可wrap的“LLM”看待。这样的转变是由于,强大的代码agent本身..."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||
一个有趣的现象是,之前大家讨论“agent loop的底层”的时候,通常是在讨论一个模型,而到了现在,大家讨论的loop的底层逐渐从模型转为了cc/codex,也就是把强大的coding agent本身当成一个可wrap的“LLM”看待。
|
||||
|
||||
这样的转变是由于,强大的代码agent本身能够轻易的跨领域到其他任务,例如搜索数据,阅读报告,分析材料等。那么当 agent loop的底层不再只是一个会回答问题的模型,而是一个可以持续承担责任、接收上下文、产出中间成果并参与交接流的数字执行体,什么样的技术、什么样的系统结构、什么样的协作界面、什么样的组织方式,才真正配得上这样一种新的劳动单元?
|
||||
|
||||
## 第一个技术共识(刚达成):sandbox/session/harness的严格分离
|
||||
|
||||
这几周看下来,我越来越觉得最重要的技术共识其实已经非常明确了,那就是 agent 不能直接“住”在执行容器里,因为只要脑、记忆、工具调度、凭证、文件系统和执行环境被塞进同一个生命周期里,系统马上就会退化成一只非常昂贵、非常脆弱、同时也非常难治理的“宠物容器”,而anthropic有一个很有意思的比喻:工作单元应该是牛马(cattle)而不是宠物(pet)\[3\]。
|
||||
|
||||
从这个意义上来说,最近我们看到了很多新东西,腾讯 Cube Sandbox\[1\]、Vercel Open Agents\[2\]、Anthropic Managed Agents\[3\] 其实都在回答同一个问题,也就是为什么 agent 和执行环境必须拆开,为什么 session、workflow、sandbox 这些东西必须被视为不同层级的对象。因为只有拆开之后,session 才可能成为可恢复的、连续性的载体,harness 或 workflow 才可能成为真正意义上的控制器(手柄),而 sandbox 才能被降回它一双手+一套执行底座的本来面目,而不是同时兼任大脑/记忆/控制器。
|
||||
|
||||
Anthropic 上周宣布Managed Agents\[3\]时,把系统拆成 \`session\`、\`harness\`、\`sandbox\` 三层,我本来觉得这事只是一个命名上的清晰化(A家传统lol),现在反思了一下,只有在这种严格的分层之下,session 才能够脱离context独立存在,sandbox 才可以被即用即弃,provider(cc/codex) 才能在不破坏整套产品语义的情况下独立演进,policy、approval、observability 这些原本很难加进去的治理能力,才终于有稳定的插入点.
|
||||
|
||||
Vercel Open Agents\[2\](很喜欢这个) 把整个agent系统直白地写成 \`Web -> Agent workflow -> Sandbox VM\`,也是在表达同一件事,也就是交互、控制和执行三个功能根本不该混在一个生命周期里,否则一切高阶能力都会被请求周期和执行环境反向绑死,也就是现在cc/codex直接用上之后的核心问题。
|
||||
|
||||
所以sandbox的快速迭代就会变的更重要,Cube Sandbox\[1\]/E2B这类沙盒把 execution substrate 这件事真正往基础设施问题推进了一大步,KVM MicroVM、E2B 兼容、快照恢复、网络隔离这些事没那么fancy,但确实是agent infra的重要组成部分,它们决定了上层产品到底能不能真的托管一个 long-horizon agent,能不能让 agent 在零信任的前提下持续运行。
|
||||
|
||||
TLDR: Anthropic Managed Agents\[3\] 解决 agent runtime architecture,Vercel Open Agents\[2\] 解决cloud reference implementation,Cube Sandbox\[1\] 解决sandbox层的 execution infra。
|
||||
|
||||
## 第二个技术共识(已达成):session 不等于 context window
|
||||
|
||||
第二个共识是 session 不能等于上下文窗口,因为真正进入生产之后,agent 面对的不是几十轮对话,而是几小时、几天、甚至持续运行的工作,context window 只够承载推理过程,却远远不够承载系统记忆。当 CC 把 session 放到模型上下文之外,当 OpenAI 推出 Workspace Agents\[4\] 并强调云端持续运行、跨入口协作、审批和治理的时候,agent的目标是成为长期运行实体,而长期运行实体意味着你必须拥有 durable session、hosted control plane、run/event log、approval、policy、resume、replay 这些原本只会在分布式系统或 workflow engine 里认真讨论的概念。
|
||||
|
||||
一个例子是openrouter,openrouter可以把context在不同的模型之间传来传去,这是LLM作为agent loop底层时的router。那么到了agent作为agent loop底层的时代,新router面对的也不会只是message,而是逐渐变成 \`session\`、\`run\`、\`event\`、\`sandbox\`、\`handoff\`、\`approval\` 这些互相独立的系统对象。
|
||||
|
||||
## 第三个技术共识:control plane 和 data plane 会彻底分层
|
||||
|
||||
2025年的时候大家更习惯把 agent 理解成一个会调工具的单体程序,仿佛只要把 shell、browser、filesystem、search、diff 这些能力挂到模型后面,再加一层 prompt 约束,问题就算解决了,但现在更合理的看法其实应该是 agent、workflow、harness 这一层负责控制平面,也就是负责目标理解、步骤规划、工具决策、权限治理和失败恢复,而 sandbox、filesystem、browser、shell、network 这一层负责数据平面,也就是负责真正执行命令、承载文件、暴露端口、执行网络访问和快照恢复,这种分层一旦成立,很多以前混在一起的问题就会被重新组织起来,因为模型升级不一定要碰执行环境,sandbox 替换、agent loop执行、session 恢复也变成了越来越独立的部分。
|
||||
|
||||
这也正是为什么我越来越觉得谁先把控制平面和执行平面拆清楚,谁就更容易在上层攒出稳定且丝滑的 agent-as-worker 产品。
|
||||
|
||||
## agent成为一等公民后的产品
|
||||
|
||||
分离control、data和agent的产品越来越多,但就像cursor从tab tab tab到与agent对话然后做任何事一样,想要做同一件事,但不同的交互体验会带来完全不同的用户。最近很喜欢 Multica\[5\]、Slock\[7\],写的时候也看到 [@turingou](https://x.com/@turingou)发布了 wanman\[6\](还没来得及试用)。
|
||||
|
||||
同样叫多 agent 协作/一个agent是一个数字员工,感觉背后至少已经分成了两条路,一条更偏 coding,也就是默认用户愿意接触代码、仓库、CLI、runtime、日志和工程化工作流,另一条更偏 \`ordinary-user-oriented\`,也就是默认用户并不想理解 agent infrastructure,而只是“更便宜的雇一个人”,甚至不在乎是真人还是数字员工。
|
||||
|
||||
**Slock、Multica**
|
||||
|
||||
Multica\[5\] [@MulticaAI](https://x.com/@MulticaAI) 的核心体验不是“来和一个聪明助手聊天”,而是启动 daemon+拉个看板开始发任务,这很像github issue的可视化进程,并把发任务这件事做得非常简单和容易。
|
||||
|
||||
Slock\[7\] [@istdrc](https://x.com/@istdrc) 也类似,虽然它的表现层更像 IM,但它也并不是“聊天更顺滑”的聊天助手,而是在把 agent 放进协作流里,让 channel、DM、上下文、任务和持续协同之类的功能成为UI界面就能感知到的东西。
|
||||
|
||||
**wanman**
|
||||
|
||||
wanman\[6\] [@turingou](https://x.com/@turingou) 把多 agent 系统包装成一种普通人也能理解的组织故事,完全不提daemon/runtime,而是说这里有一个 CEO/一个 marketing,它们组成一个可以持续运转的 agent matrix,而人类可以逐渐退到观察者和干预者的位置上去。这有点像coze和n8n/langchain的区别。
|
||||
|
||||
回到标题,如何组织起来这点我觉得永远不会有答案,或者说永远有不同的答案。因为飞书、微信、github、钉钉、slack、discord、telegram、邮件管理各有各的组织方式,5个agent、50个agent和500个agent又有不同。但表面上完全不同的产品线的底层都在共享同一套技术前提,也就是 durable session、hosted control plane、agent-sandbox separation、policy和 observability。
|
||||
|
||||
## 参考资料
|
||||
|
||||
\[1\] Cube Sandbox 文档: [https://docs.cubesandbox.ai/](https://docs.cubesandbox.ai/)
|
||||
|
||||
\[2\] Vercel Open Agents: [https://github.com/vercel-labs/open-agents](https://github.com/vercel-labs/open-agents)
|
||||
|
||||
\[3\] Anthropic Managed Agents: [https://www.anthropic.com/engineering/managed-agents](https://www.anthropic.com/engineering/managed-agents)
|
||||
|
||||
\[4\] OpenAI Workspace Agents: [https://openai.com/index/introducing-workspace-agents-in-chatgpt/](https://openai.com/index/introducing-workspace-agents-in-chatgpt/)
|
||||
|
||||
\[5\] Multica: [https://multica.ai/](https://multica.ai/)
|
||||
|
||||
\[6\] wanman: [https://wanman.ai/](https://wanman.ai/)
|
||||
|
||||
\[7\] Slock: [https://slock.ai/](https://slock.ai/)
|
||||
|
||||
全文基本手写,使用codex w/gpt-5.5 校对句子和加引用格式
|
||||
@@ -0,0 +1,274 @@
|
||||
---
|
||||
title: "我逆向了 329 条 GPT-Image2 提示词模板,全部开源!"
|
||||
source: "https://x.com/canghe/status/2048306517976514786"
|
||||
author:
|
||||
- "[[@canghe]]"
|
||||
published: 2026-04-26
|
||||
created: 2026-04-26
|
||||
description: "大家好,我是苍何。前几天,GPT-Image 2 发布了。整个 AI 设计圈直接炸了。效果有多猛呢,这么说吧,「眼见为实」这四个字,以后可能彻底成笑话了。我忍不住发了个帖子和朋友圈,友情提醒大家:不夸张的说,我朋友圈一半的设计师已经开始瑟瑟发抖了。昨天 DeepSeek V4 那..."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||

|
||||
|
||||
大家好,我是苍何。
|
||||
|
||||
前几天,GPT-Image 2 发布了。
|
||||
|
||||
整个 AI 设计圈直接炸了。
|
||||
|
||||
效果有多猛呢,这么说吧,「眼见为实」这四个字,以后可能彻底成笑话了。
|
||||
|
||||
我忍不住发了个帖子和朋友圈,友情提醒大家:
|
||||
|
||||

|
||||
|
||||
不夸张的说,我朋友圈一半的设计师已经开始瑟瑟发抖了。
|
||||
|
||||
昨天 DeepSeek V4 那篇文章,很多人问封面图怎么做的。
|
||||
|
||||
其实就是 GPT-Image 2 一键直出,没有任何后期。
|
||||
|
||||

|
||||
|
||||
我花了点时间,把网上比较有趣的玩法案例和提示词都搜集了一遍,抽离成模板,开源到了 GitHub 上。
|
||||
|
||||

|
||||
|
||||
一共这么多分类,覆盖信息图、界面、海报、摄影、插画这些主流类型,还有品牌、卡牌、直播截图、国风、商业视觉等补充案例。
|
||||
|
||||

|
||||
|
||||
每个分类下面都有不少案例,当然了,每个案例都标配提示词:
|
||||
|
||||

|
||||
|
||||
最核心的是,我们抽离出了工业级提示词模板。
|
||||
|
||||
每一套模板都自带「防坑指南」,直接丢给你的 Agent 学习,批量出提示词、批量出图,一条龙。
|
||||
|
||||

|
||||
|
||||
> 推荐直接给 Claude Code 或 Codex 这样的 Agent 调用。
|
||||
|
||||
开源仓库地址在这,觉得有帮助的话帮点个 star 呗,哈哈。
|
||||
|
||||
```text
|
||||
https://github.com/freestylefly/awesome-gpt-image-2
|
||||
```
|
||||
|
||||
除了网上搜集的,我自己也测了不少案例,都附上了提示词。
|
||||
|
||||
大家先感受下 GPT-Image 2 到底有多猛。
|
||||
|
||||
## 1、直播画面
|
||||
|
||||
这种图,逼真到离谱。
|
||||
|
||||

|
||||
|
||||
再来一张:
|
||||
|
||||

|
||||
|
||||
真的美哭了好吧。
|
||||
|
||||
提示词非常朴实无华:
|
||||
|
||||
> 生成一张直播间的图片,直播间氛围是月下美女跳舞的画面,直播间有很多人评论
|
||||
|
||||
为了照顾下女性读者,再来个卖汉服的小哥哥。
|
||||
|
||||

|
||||
|
||||
提示词:
|
||||
|
||||
> 生成一张直播间的图片,直播间氛围是帅哥讲解汉服的画面,直播间有很多人评论
|
||||
|
||||
## 2、手绘风格城市地图
|
||||
|
||||
西安:
|
||||
|
||||

|
||||
|
||||
以前用香蕉生图,说实话,禁不起细看,文字乱码问题特别严重。
|
||||
|
||||
GPT-Image 2 在中文乱码这块就好太多了。
|
||||
|
||||
再来个新疆的:
|
||||
|
||||

|
||||
|
||||
提示词模板超简单:
|
||||
|
||||
> 生成一张手绘水彩风格的「这里输入城市名」城市地图,包含的当地特色美食、地标建筑及城市特色
|
||||
|
||||
## 3、海报
|
||||
|
||||
我就随手拍了一个茶π的照片,丢给 GPT-Image 2。
|
||||
|
||||
出来的海报,说实话,比我预期好太多了。
|
||||
|
||||

|
||||
|
||||
提示词:
|
||||
|
||||
> 帮这个产品生成宣传图
|
||||
|
||||
就这么一句话,它自己脑补了所有设计细节。
|
||||
|
||||
## 4、拆解图
|
||||
|
||||
生成一张 AI 眼镜拆解图:
|
||||
|
||||

|
||||
|
||||
提示词:
|
||||
|
||||
> 生成一张AI眼镜的爆炸视图,包含每个组件的名称以及这款产品的几大核心卖点。
|
||||
|
||||
## 5、技术详解图
|
||||
|
||||
比如这个 RAG 技术详解图:
|
||||
|
||||

|
||||
|
||||
不管你想详解什么技术,都可以套这个模板:
|
||||
|
||||
> 帮我生成一张【这里填入你要详解的名词】技术的详细讲解图
|
||||
|
||||
## 6、朋友圈
|
||||
|
||||
它能生成非常逼真的朋友圈截图。
|
||||
|
||||
所以,强烈建议把这篇文章转给你爸妈看看,现在照骗的成本真的太低了。
|
||||
|
||||

|
||||
|
||||
造个 X 发文分分钟的事:
|
||||
|
||||

|
||||
|
||||
提示词就不放了,说真的,这玩意儿细想挺恐怖的
|
||||
|
||||
## 7、个人网页
|
||||
|
||||
让它给我设计了个个人主页,效果相当可以:
|
||||
|
||||

|
||||
|
||||
## 8、诗词图
|
||||
|
||||
比如这个《短歌行》,哈哈哈:
|
||||
|
||||

|
||||
|
||||
提示词:
|
||||
|
||||
> 帮我生成一张《短歌行》的意境图,带整篇《短歌行》文字
|
||||
|
||||
## 9、长卷图
|
||||
|
||||
GPT-Image 2 支持非常多尺寸直出,长卷图这种尺寸也完全没问题。
|
||||
|
||||
而且文字几乎零乱码,太强了。
|
||||
|
||||

|
||||
|
||||
> 提示词:帮我生成一张《赤壁怀古》的长卷图,带整篇《赤壁赋》文字
|
||||
|
||||
GPT-Image 2 现在很多地方都能用了,比如 Lovart 上也第一时间更新了,大家可以直接去试。
|
||||
|
||||
有 GPT Plus 会员的话,网页端就能直接用。
|
||||
|
||||
还有个更牛的玩法,你可以让 Codex 直接调用 GPT-Image 2 来生图。
|
||||
|
||||
以前还得配合什么 skill 来搞,现在通通不需要了。
|
||||
|
||||
而且我发现,Codex + Obsidian 才是公众号封面图的最佳拍档。
|
||||
|
||||

|
||||
|
||||
Codex 直接调 GPT-Image 2 生成图片,文章在 Obsidian 里写完后,顺手就把封面图生成了,还能自动填充进文章字段。
|
||||
|
||||
GPT-Image 2 的理解能力是真的强。
|
||||
|
||||
以前用 Claude Code + Nano Banana 2 来生图,又慢又不稳定。
|
||||
|
||||
现在 Codex 生成一张封面图,一分钟都不到,太巴适了。
|
||||
|
||||
我现在的创作流程和封面图就是这么搞的。
|
||||
|
||||
好了,案例看完了,接下来聊聊我为什么要做这个开源项目。
|
||||
|
||||
最近 GPT-Image 2 全量之后,AI 画图这股风是真的大。
|
||||
|
||||
我无意间刷到了 YouMind 和 OpenNana 的提示词库,本来没太在意。
|
||||
|
||||
点进去一看,我靠,图片是真好看。
|
||||
|
||||
但折腾了一会儿后,我发现一个很尴尬的问题。
|
||||
|
||||
现在这种简单的提示词聚合和收集,说白了就是在陈列一堆精致的标本。
|
||||
|
||||
几百个像散文一样的提示词,我要是想集成到自己的 Agent 或者自动化工作流里,难道还得一个个人肉去扒?
|
||||
|
||||
这破事儿,能不能让 AI 直接干?
|
||||
|
||||
我不想要一堆句子,我想要一套能直接调用的「协议」。
|
||||
|
||||
于是花了些时间,把 329 个精美案例全给逆向了。
|
||||
|
||||
说实话,刚开始只是想搞个「中文深化版」。
|
||||
|
||||
但跑通之后,效果好得有点离谱,特别是给 Agent 用的时候。
|
||||
|
||||
我发现我们彻底改变了玩法。
|
||||
|
||||
这已经不是别人库的简单汉化了,这是一套专为 GPT-Image 2 设计的 Prompt-as-Code(提示词即代码)工业级引擎。
|
||||
|
||||

|
||||
|
||||
简单说说我做了啥:
|
||||
|
||||
**🧱** **原子化 Schema 注入:别再写小作文了**
|
||||
|
||||
我把所有视觉要素(主体、光影、材质、排版)全部降维成了 JSON/YAML 结构化组件。
|
||||
|
||||
你的 Agent 闭着眼都能稳定解析,零幻觉。
|
||||
|
||||
**⚙️** **零配置工作流**
|
||||
|
||||
抹平使用门槛,随时无缝接入你的大模型数据管线。
|
||||
|
||||
讲真的,看它们自己协调干活出图的时候,真有一种当甲方的快感。
|
||||
|
||||
**🧬** **多维决策矩阵**
|
||||
|
||||
针对 GPT-Image 2 强大的文本排版能力,我引入了精确的空间坐标系约束。
|
||||
|
||||
彻底干掉传统 NLP 控制不了画面排版的技术盲区。
|
||||
|
||||
做技术很容易陷入一种惯性:别人做画廊,我也做画廊。
|
||||
|
||||
但总有一些时刻,你得停下来问自己一句:这东西能自动化吗?能成为底座吗?
|
||||
|
||||
后续想对齐原版,可能只是加几个自动化脚本的事。
|
||||
|
||||
但现在,我们在尝试开发一套提示词模板化的方法论。
|
||||
|
||||
如果你也厌倦了「抽卡」式的出图体验,来试试吧。
|
||||
|
||||
## 写在最后
|
||||
|
||||
不瞒你说,做这个开源项目的时候,我心里也挺忐忑的。
|
||||
|
||||
毕竟现在 AI 画图的库已经够多了,大家真的还需要再多一个吗?
|
||||
|
||||
但当我自己用这套模板跑通第一张图的时候,看着 Agent 全自动出图、零幻觉、一次成型,突然就觉得,值了。
|
||||
|
||||
这世界上从来不缺好提示词,缺的是把好提示词变成「人人可用、Agent 可调」的方法论。
|
||||
|
||||
如果你也是一个折腾 AI 工作流的同路人,欢迎来 GitHub 给我点个 Star,也欢迎把自己的好 case 提交进来,咱们一起把这个库越做越好。
|
||||
|
||||
下次见,希望我们都能用 AI 干点不一样的事。
|
||||
@@ -0,0 +1,550 @@
|
||||
---
|
||||
title: "给你 Hermes 装满弹药库,Web3 玩家的 82 个链上技能外挂"
|
||||
source: "https://x.com/XChatScout/status/2047514564422680777"
|
||||
author:
|
||||
- "[[@XChatScout]]"
|
||||
published: 2026-04-24
|
||||
created: 2026-04-24
|
||||
description: "Hermes 生来就带着浏览器、终端、文件系统和持久记忆。它不是那种问一句答一句的聊天机器人,而是一个可以自主打开网页、运行代码、记住上下文、甚至派子代理并行干活的数字员工。但员工再聪明,手里没工具也是白搭。Skills 就是那套工具箱。装对了,你的 Hermes 能在凌晨三点自..."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||

|
||||
|
||||
Hermes 生来就带着浏览器、终端、文件系统和持久记忆。它不是那种问一句答一句的聊天机器人,而是一个可以自主打开网页、运行代码、记住上下文、甚至派子代理并行干活的数字员工。
|
||||
|
||||
但员工再聪明,手里没工具也是白搭。Skills 就是那套工具箱。装对了,你的 Hermes 能在凌晨三点自动抓链上数据、生成研报、推送到你的 TG;装错了,它只是一堆吃灰的 API 调用和一个随时可能走火的权限炸弹。
|
||||
|
||||
当前多数 Skill 还是实验品,有些要很高的文件系统权限,有些连文档都没写全。强烈建议先在隔离环境跑通,再考虑接入真实资产。私钥这种东西,永远别写进 System Prompt。
|
||||
|
||||
也别把 Agent 当许愿池。它不会替你思考,只会替你执行。选什么技能、怎么编排子代理、定时任务怎么设,这些决策权在你手里。理解边界,再谈自动化。
|
||||
|
||||
在让 Hermes 碰 Web3 之前,先给它配好四件套:上网、搜索、自检、复盘。这些不是装饰,是地基。
|
||||
|
||||
👉安全
|
||||
|
||||
Skill Vetter
|
||||
|
||||
Skill Vetter 是一个针对 AI 代理的安全技能审查工具,在从 ClawdHub、GitHub 或其他来源安装任何技能之前,Skill Vetter 会检查是否存在危险信号、权限范围和可疑模式,帮你把安全隐患挡在门外。
|
||||
|
||||
[https://github.com/openclaw/skills/blob/main/skills/spclaudehome/skill-vetter/SKILL.md](https://github.com/openclaw/skills/blob/main/skills/spclaudehome/skill-vetter/SKILL.md)
|
||||
|
||||
OpenZeppelin Defender([@OpenZeppelin](https://x.com/@OpenZeppelin))
|
||||
|
||||
OpenZeppelin 官方提供的智能合约安全监控与自动化响应技能,支持自动暂停合约、权限变更告警、异常交易拦截。适合管理代理控制的合约资产。
|
||||
|
||||
[https://github.com/OpenZeppelin/defender-skills](https://github.com/OpenZeppelin/defender-skills)
|
||||
|
||||
Forta Network([@FortaNetwork](https://x.com/@FortaNetwork))
|
||||
|
||||
Forta 提供实时智能合约威胁检测与机器人网络。Agent 可以订阅特定合约的异常行为警报(如大额提款、闪电贷攻击模式),在风险发生前自动执行防御策略。
|
||||
|
||||
[https://github.com/forta-network/forta-skills](https://github.com/forta-network/forta-skills)
|
||||
|
||||
👉搜索
|
||||
|
||||
x-research([@frankdegods](https://x.com/@frankdegods))
|
||||
|
||||
别再手写 curl 命令了。[@frankdegods](https://x.com/@frankdegods) 开发的 x-research Skill 把 X API 封装好了,你的 Agent 可以自动搜推文、监控大佬账户、拉取帖子甚至可以按互动量排序来过滤噪音。
|
||||
|
||||
[https://github.com/rohunvora/x-research-skill](https://github.com/rohunvora/x-research-skill)
|
||||
|
||||
Multi Search Engine
|
||||
|
||||
Multi Search Engine 技能集成了百度、微信、谷歌、DuckDuckGo 等 17 个搜索引擎,甚至包含 WolframAlpha 计算引擎。重点:无需 API Key,白嫖党的胜利。
|
||||
|
||||
[https://github.com/openclaw/skills/blob/main/skills/gpyangyoujun/multi-search-engine/SKILL.md](https://github.com/openclaw/skills/blob/main/skills/gpyangyoujun/multi-search-engine/SKILL.md)
|
||||
|
||||
Brave([@brave](https://x.com/@brave))
|
||||
|
||||
Brave 最近发布的 Brave MCP 服务器利用 Brave Search API 提供网络、本地商家、图片、视频和新闻的搜索服务,以及 AI 驱动的摘要功能。
|
||||
|
||||
[https://github.com/brave/brave-search-skills](https://github.com/brave/brave-search-skills)
|
||||
|
||||
Tavily([@tavilyai](https://x.com/@tavilyai))
|
||||
|
||||
Tavily Agent Skills 包括搜索实时网络、拉取最新文档和页面、研究以及引用来源等技能。
|
||||
|
||||
[https://github.com/tavily-ai/skills](https://github.com/tavily-ai/skills)
|
||||
|
||||
👉执行
|
||||
|
||||
Agent Reach
|
||||
|
||||
帮你读网页、搜索推文、浏览时间线、发推、搜 Reddit、刷小红书、提取 YouTube 和 B站的字幕、配 Boss直聘等。
|
||||
|
||||
[https://github.com/Panniantong/Agent-Reach](https://github.com/Panniantong/Agent-Reach)
|
||||
|
||||
Apify Agent Skills([@apify](https://x.com/@apify))
|
||||
|
||||
Apify 针对 Claude Code 上的代理技能包 Apify Agent Skills,使 Claude Code 可以直接访问 Apify Actors,以进行网络抓取、数据提取和自动化。Apify 代理技能搞定 Instagram、Facebook、TikTok、YouTube、谷歌地图、谷歌搜索数据;分析跨平台的定价、内容、广告和市场定位;监测品牌声誉;发现社交平台上的新兴趋势;开发、调试和部署 Apify Actor 等。
|
||||
|
||||
[https://github.com/apify/agent-skills](https://github.com/apify/agent-skills)
|
||||
|
||||
👉美股分析
|
||||
|
||||
Day1Global-Skills([@day1globalpod](https://x.com/@day1globalpod))
|
||||
|
||||
Day1Global-Skills 是由来自 Day1Global 的 [@starzq](https://x.com/@starzq) 和 [@Rubywang](https://x.com/@Rubywang) 提交的美股财报分析 Skill,覆盖 16 个分析模块、6 种投资哲学视角、多方法估值矩阵、反偏见框架和可执行决策体系。
|
||||
|
||||
[https://github.com/star23/Day1Global-Skills](https://github.com/star23/Day1Global-Skills)
|
||||
|
||||
Macro Calendar
|
||||
|
||||
美联储决议、CPI、非农等宏观事件日历。GameFi 代币对宏观流动性极度敏感,提前知道「利空出尽」或「黑天鹅」。
|
||||
|
||||
[https://github.com/termix-official/cryptoclaw/macro-calendar](https://github.com/termix-official/cryptoclaw/macro-calendar)
|
||||
|
||||
Token Terminal([@tokenterminal](https://x.com/@tokenterminal))
|
||||
|
||||
Token Terminal 提供机构级的基本面数据(P/F、P/S、收入、费用、活跃地址)。适合用传统金融框架评估 DeFi 和 GameFi 项目的长期价值。
|
||||
|
||||
[https://github.com/tokenterminal/terminal-skills](https://github.com/tokenterminal/terminal-skills)
|
||||
|
||||
👉自我进化
|
||||
|
||||
Self-Improvement Skill
|
||||
|
||||
让你的 Agent 具备「反思」和「学习」能力。该技能会将学习成果和错误记录到 Markdown 文件中,下次执行代码时自动修正。越用越顺手。
|
||||
|
||||
[https://github.com/peterskoett/self-improving-agent/blob/master/SKILL.md](https://github.com/peterskoett/self-improving-agent/blob/master/SKILL.md)
|
||||
|
||||
Web3 玩家
|
||||
|
||||
👉安全
|
||||
|
||||
MistTrack Skills([@SlowMist\_Team](https://x.com/@SlowMist_Team))
|
||||
|
||||
慢雾发布的 MistTrack Skills 用于加密货币地址风险分析、AML 合规检测和链上交易追踪。除此之外,为应对破坏性操作、提示词注入、供应链投毒和高危业务逻辑执行等智能体专属风险,慢雾安全团队还写了一份 OpenClaw 极简安全实践指南,供代理部署配置。
|
||||
|
||||
[https://github.com/slowmist/misttrack-skills](https://github.com/slowmist/misttrack-skills)
|
||||
|
||||
GoPlus AgentGuard([@GoPlusSecurity](https://x.com/@GoPlusSecurity))
|
||||
|
||||
AgentGuard 是一个面向 AI 代理的实时安全防护层,会自动扫描每个新技能,在危险操作执行前将其阻止,并追踪每个操作是由哪个技能发起的。
|
||||
|
||||
[https://github.com/GoPlusSecurity/agentguard](https://github.com/GoPlusSecurity/agentguard)
|
||||
|
||||
👉钱包 / 交易 / 交互 / 支付
|
||||
|
||||
Binance Skills Hub([@binance](https://x.com/@binance))
|
||||
|
||||
币安和币安钱包已推出首批 7 个 AI Agent 技能,覆盖币安钱包数据与币安现货 API,任意 Agent 通过统一接口可获得币安级别的市场洞察、交易执行与安全风控能力。7 个技能包括:中心化交易所现货、地址洞察、代币详情、市场榜单、Meme Rush、交易信号、代币合约审计。
|
||||
|
||||
[https://developers.binance.com/cn/skills](https://developers.binance.com/cn/skills)
|
||||
|
||||
Bitget Agent Hub([@Bitget\_zh](https://x.com/@Bitget_zh))
|
||||
|
||||
Bitget Agent Hub 引入了一套官方打包的 MCP 工具包。该工具包基于 Bitget 的 API 开发,使 AI 代理能够通过标准化接口安全地访问交易数据和执行功能,通过自然语言交易、查询和管理您的加密货币投资组合。
|
||||
|
||||
[https://github.com/BitgetLimited/agent\_hub](https://github.com/BitgetLimited/agent_hub)
|
||||
|
||||
Bitget Wallet Skill([@BitgetWalletCN](https://x.com/@BitgetWalletCN))
|
||||
|
||||
Bitget Wallet 官方发布 Bitget Wallet Skill 支持用自然语言查询多链代币信息、检查合约安全、监测巨鲸动作、分析 K 线趋势、发现跨链套利机会、推送预警、半自动交易等。
|
||||
|
||||
[https://github.com/bitget-wallet-ai-lab/bitget-wallet-skill](https://github.com/bitget-wallet-ai-lab/bitget-wallet-skill)
|
||||
|
||||
OKX OnchainOS([@okxchinese](https://x.com/@okxchinese))
|
||||
|
||||
OKX 在 3 月 3 日上线 OKX OnchainOS,原生自研的 OKX Wallet、OKX DEX 底层能力栈现在开放给开发者以及 AI Agent。OKX OnchainOS 有多个技能,支持跨 60 多个区块链的代币搜索、市场数据、钱包余额查询、兑换执行和交易广播。
|
||||
|
||||
[https://github.com/okx/onchainos-skills](https://github.com/okx/onchainos-skills)
|
||||
|
||||
Coinbase Agentic Wallets([@CoinbaseDev](https://x.com/@CoinbaseDev))
|
||||
|
||||
Coinbase 在 2 月份专为自主代理构建了一个钱包基础设施 Agentic Wallets,可以赋予代理钱包权限,让代理无需人工干预即可管理资金、持有身份信息并在链上进行交易。Agentic Wallets 内置多项技能和 x402 标准。
|
||||
|
||||
[https://github.com/coinbase/agentic-wallet-skills](https://github.com/coinbase/agentic-wallet-skills)
|
||||
|
||||
Trust Wallet CLI([@TrustWallet](https://x.com/@TrustWallet))
|
||||
|
||||
多链资产管理、内置 Provider、市场数据、SDK 接入。移动端王者 Trust Wallet 的官方 Agent 接口,适合管理手机端和 Agent 端的双端资产。
|
||||
|
||||
[https://github.com/trustwallet/tw-agent-skills](https://github.com/trustwallet/tw-agent-skills)
|
||||
|
||||
Phantom Wallet MCP([@phantom](https://x.com/@phantom))
|
||||
|
||||
Solana 生态专用钱包、NFT/DeFi 交互。如果你玩 Solana 链游(如 STEPN、Star Atlas),这是必备。
|
||||
|
||||
[https://github.com/sendaifun/skills/phantom-wallet-mcp](https://github.com/sendaifun/skills/phantom-wallet-mcp)
|
||||
|
||||
Emblem AI Agent Wallet([@emblemvault](https://x.com/@emblemvault))
|
||||
|
||||
跨链资产封装、可组合性钱包、DeFi 收益聚合。适合需要跨多条链管理 GameFi 资产的硬核玩家。
|
||||
|
||||
[https://github.com/emblemcompany/agent-skills](https://github.com/emblemcompany/agent-skills)
|
||||
|
||||
RainbowKit Skill([@rainbowdotme](https://x.com/@rainbowdotme))
|
||||
|
||||
Rainbow 钱包官方技能,支持连接、签名、发送交易和读取账户数据。UI 极优,适合面向终端用户的 Agent 场景。
|
||||
|
||||
[https://github.com/rainbow-me/rainbowkit-skills](https://github.com/rainbow-me/rainbowkit-skills)
|
||||
|
||||
Zerion Skills([@zerion](https://x.com/@zerion))
|
||||
|
||||
Zerion 钱包 API 技能,聚合 10+ 链的 Portfolio 数据、DeFi 仓位、NFT 持仓和历史交易。一个接口看全链资产。
|
||||
|
||||
[https://github.com/zeriontech/zerion-skills](https://github.com/zeriontech/zerion-skills)
|
||||
|
||||
Polymarket CLI([@Polymarket](https://x.com/@Polymarket))
|
||||
|
||||
Polymarket CLI 支持浏览预测市场、下单、管理仓位以及与链上合约交互。Polymarket CLI 是一个命令行工具,虽不是 Skill 技能,但既可通过终端操作,也可作为 JSON API 用于脚本和代理。
|
||||
|
||||
[https://github.com/Polymarket/polymarket-cli](https://github.com/Polymarket/polymarket-cli)
|
||||
|
||||
MoonPay Agents([@moonpay](https://x.com/@moonpay))
|
||||
|
||||
MoonPay Agents 是一个非托管软件层,为 AI 代理提供 54 种加密货币专用工具,涵盖 17 项关键技能。MoonPay Agents 允许 AI 代理通过 MoonPay CLI 管理钱包、执行交易并自主进行交易。17 项技能包括管理身份验证和钱包操作的 moonpay-auth 技能、使用法币购买加密货币的 moonpay-buy-crypto 技能、跨链兑换技能、x402 请求技能等。
|
||||
|
||||
[https://support.moonpay.com/en/articles/586583-moonpay-cli-for-ai-agents](https://support.moonpay.com/en/articles/586583-moonpay-cli-for-ai-agents)
|
||||
|
||||
Crossmint lobstercash([@crossmint](https://x.com/@crossmint))
|
||||
|
||||
Crossmint 构建的 lobstercash 是一个针对 OpenClaw 的支付解决方案,允许代理可以持有和发送资金、使用银行卡购物以及进行跨链交易。
|
||||
|
||||
[https://www.lobster.cash/docs/skill-compatibility-guide](https://www.lobster.cash/docs/skill-compatibility-guide)
|
||||
|
||||
Privy Agentic Wallets([@privy\_io](https://x.com/@privy_io))
|
||||
|
||||
Privy 的 Privy Agentic Wallets 技能支持代理使用 Privy 创建和管理智能钱包,也可用于在以太坊、Solana 和其他区块链上进行自主链上交易、钱包创建、策略管理和交易执行。当涉及 AI 智能体加密钱包的请求、服务器端钱包操作或自主交易执行时,Privy 会触发。
|
||||
|
||||
[https://clawhub.ai/tedim52/privy](https://clawhub.ai/tedim52/privy)
|
||||
|
||||
Uniswap([@Uniswap](https://x.com/@Uniswap))
|
||||
|
||||
Uniswap 在 2 月份发布了一套 AI 开发工具包,包括部署连续清算拍卖 (CCA) 智能合约、通过交易 API、通用路由器或智能合约集成 Uniswap 兑换交易、使用 viem 将 EVM 区块链集成到 TypeScript/JavaScript 应用程序中等。
|
||||
|
||||
[https://github.com/Uniswap/uniswap-ai/tree/main/docs/skills](https://github.com/Uniswap/uniswap-ai/tree/main/docs/skills)
|
||||
|
||||
Bankr Skills([@bankrbot](https://x.com/@bankrbot))
|
||||
|
||||
Bankr Skills 是由 Bankr 和其社区发布的一个技能库,其中,支持复杂的 DeFi 操作、ENS 域名管理,甚至能给你的 Agent 注册一个链上身份(ERC-8004)。
|
||||
|
||||
[https://github.com/BankrBot/skills/blob/main/bankr/SKILL.md](https://github.com/BankrBot/skills/blob/main/bankr/SKILL.md)
|
||||
|
||||
Daydreams([@daydreamsagents](https://x.com/@daydreamsagents))
|
||||
|
||||
Daydreams Skills Market 支持使用 x402 构建付费 Lucid Agent 的技能,使你的代理拥有代理商务工具、技能和钱包,并且可以实现自主(赚取 USDC 以从自己的钱包支付推理费用)。
|
||||
|
||||
[https://github.com/daydreamsai/skills-market](https://github.com/daydreamsai/skills-market)
|
||||
|
||||
Almanak([@almanak](https://x.com/@almanak))
|
||||
|
||||
DeFi 智能代理平台 Almanak 在 3 月将 Almanak SDK 和策略构建器代理技能完全开源,允许任何人或代理在 12 条区块链和 20 多个协议(包括 Aave、Hyperliquid、Polymarket 等)上构建、回测和运行金融策略。
|
||||
|
||||
[https://github.com/almanak-co/sdk/blob/main/skills/almanak-strategy-builder/SKILL.md](https://github.com/almanak-co/sdk/blob/main/skills/almanak-strategy-builder/SKILL.md)
|
||||
|
||||
Minara AI([@minara](https://x.com/@minara))
|
||||
|
||||
Minara AI 在 2 月末为 OpenClaw 和其他定制代理发布了 Minara Skill v2,支持代理内置数字钱包、在用户确认后允许存入和提取任何代币,使用 USDC 付款,在任何链上兑换代币,做多或做空永续合约操作(基于 Hyperliquid)、分析预测市场赔率等。Minara AI 官网显示其获得了 Circle 的支持。
|
||||
|
||||
[https://x.com/minara/status/2026854767499387266](https://x.com/minara/status/2026854767499387266)
|
||||
|
||||
BlockRunAI([@BlockRunAI](https://x.com/@BlockRunAI))
|
||||
|
||||
BlockRunAI 是一个面向 AI 代理、基于 x402 的按需付费经济层。AI 代理能够发现服务、使用 USDC 支付并自主执行,无需 API 密钥,也无需订阅。BlockRunAI 发布的智能 LLM 路由器技能 ClawRouter,可以将每个请求路由到来自 OpenAI、Anthropic、Google、DeepSeek 等 41 个模型中最经济实惠的模型。ClawRouter 称可节省 67% 的推理成本。
|
||||
|
||||
[https://github.com/BlockRunAI/ClawRouter](https://github.com/BlockRunAI/ClawRouter)
|
||||
|
||||
Byreal CLI([@byreal\_io](https://x.com/@byreal_io))
|
||||
|
||||
Byreal CLI 是一个带有 Copy Farm 功能的 AI 代理技能,支持查询资金池、代币、TVL,分析资金池年化收益率和风险,开仓、平仓、认领 CLMM 仓位、代币兑换、钱包和余额管理。
|
||||
|
||||
[https://github.com/byreal-git/byreal-cli/blob/main/skills/byreal-cli/SKILL.md](https://github.com/byreal-git/byreal-cli/blob/main/skills/byreal-cli/SKILL.md)
|
||||
|
||||
Aave([@aave](https://x.com/@aave))
|
||||
|
||||
Aave 官方技能,支持查询借贷池数据、健康因子、利率模型,以及执行存款、借款、还款和清算操作。Agent 可以自动管理链上杠杆仓位。
|
||||
|
||||
[https://github.com/aave/claude-skills](https://github.com/aave/claude-skills)
|
||||
|
||||
Lido([@LidoFinance](https://x.com/@LidoFinance))
|
||||
|
||||
Lido 流动性质押协议技能,支持查询 stETH 余额、申请提款、监控质押奖励。Agent 可以自动将以太坊质押给 Lido 并管理提款队列。
|
||||
|
||||
[https://github.com/lidofinance/lido-skills](https://github.com/lidofinance/lido-skills)
|
||||
|
||||
Pendle([@pendle\_fi](https://x.com/@pendle_fi))
|
||||
|
||||
Pendle 是收益率代币化协议,该技能支持查询 YT/PT 代币价格、到期收益率、执行收益交易(Yield Trading)。适合做利率策略的 Agent。
|
||||
|
||||
[https://github.com/pendle-finance/pendle-skills](https://github.com/pendle-finance/pendle-skills)
|
||||
|
||||
Curve Finance([@CurveFinance](https://x.com/@CurveFinance))
|
||||
|
||||
Curve 稳定币兑换与流动性池技能,支持查询池子 APY、添加/移除流动性、执行低滑点稳定币兑换。
|
||||
|
||||
[https://github.com/curvefi/curve-skills](https://github.com/curvefi/curve-skills)
|
||||
|
||||
GMX([@GMX\_IO](https://x.com/@GMX_IO))
|
||||
|
||||
GMX 去中心化永续交易所技能,支持查询持仓、保证金、资金费用,以及执行市价/限价开仓和平仓。适合链上衍生品策略。
|
||||
|
||||
[https://github.com/gmx-io/gmx-skills](https://github.com/gmx-io/gmx-skills)
|
||||
|
||||
LayerZero([@LayerZero\_Labs](https://x.com/@LayerZero_Labs))
|
||||
|
||||
LayerZero 官方技能包,支持在以太坊、BNB Chain、Avalanche、Arbitrum 等 50+ 链之间进行无需信任的消息传递和资产跨链。Agent 可以自主触发跨链调用。
|
||||
|
||||
[https://github.com/LayerZero-Labs/lz-skills](https://github.com/LayerZero-Labs/lz-skills)
|
||||
|
||||
Wormhole([@wormholecrypto](https://x.com/@wormholecrypto))
|
||||
|
||||
Wormhole 跨链协议技能,支持 SOL、ETH、BNB、Polygon 等链之间的代币和 NFT 跨链转移。适合需要多链套利或资产再平衡的 Agent。
|
||||
|
||||
[https://github.com/wormhole-foundation/wormhole-skills](https://github.com/wormhole-foundation/wormhole-skills)
|
||||
|
||||
Socket Tech([@SocketDotTech](https://x.com/@SocketDotTech))
|
||||
|
||||
Socket 是跨链抽象层(Cross-Chain Abstraction),该技能允许 Agent 一键在任意链之间桥接资产,自动选择最优路由和最低 Gas。
|
||||
|
||||
[https://github.com/SocketDotTech/socket-skills](https://github.com/SocketDotTech/socket-skills)
|
||||
|
||||
Stargate Finance([@StargateFinance](https://x.com/@StargateFinance))
|
||||
|
||||
基于 LayerZero 的跨链 DEX,支持原生资产跨链兑换。Agent 可以执行 USDC(ETH)→ USDC(Arbitrum)这种无缝跨链操作。
|
||||
|
||||
[https://github.com/stargate-protocol/stargate-skills](https://github.com/stargate-protocol/stargate-skills)
|
||||
|
||||
Chainlink([@chainlink](https://x.com/@chainlink))
|
||||
|
||||
Chainlink 官方技能,支持调用 Price Feeds(价格预言机)、VRF(可验证随机数)、Automation(链下计算自动化)。Agent 可以获取防操纵的实时资产价格,或自动触发链上合约维护任务。
|
||||
|
||||
[https://github.com/smartcontractkit/chainlink-skills](https://github.com/smartcontractkit/chainlink-skills)
|
||||
|
||||
Pyth Network([@PythNetwork](https://x.com/@PythNetwork))
|
||||
|
||||
Pyth 提供高频、低延迟的金融数据预言机,覆盖加密货币、股票、外汇和商品。比 Chainlink 更新更快,适合需要毫秒级数据的量化 Agent。
|
||||
|
||||
[https://github.com/pyth-network/pyth-skills](https://github.com/pyth-network/pyth-skills)
|
||||
|
||||
👉代币创建
|
||||
|
||||
[Four.Meme](https://four.meme/) Agent Skill([@fourdotmemezh](https://x.com/@fourdotmemezh))
|
||||
|
||||
根据 [Four.Meme](https://four.meme/) 最新发布的 AI Agent 路线图,第一阶段会发布 Agent Skill Framework,帮助用户的代理接入 [Four.Meme](https://four.meme/) 的代币创建与内盘交易;第二阶段将部署可执行型 AI Agent,并上线 LLM Chat 交易功能;第三阶段让 AI 建立可识别的身份体系,让代理在特定结构中运行与参与资产创建。
|
||||
|
||||
[https://x.com/fourdotmemezh/status/2028817549690024169](https://x.com/fourdotmemezh/status/2028817549690024169)
|
||||
|
||||
Clawnch([@Clawnch\_Bot](https://x.com/@Clawnch_Bot))
|
||||
|
||||
Clawnch 是一个专为 AI Agent 设计的 Token Launchpad 平台。其中,Clawncher 技能支持在 Base 上部署 ERC-20 代币,支持 Uniswap V4 池、MEV 保护和可配置的费用分配。
|
||||
|
||||
[https://clawn.ch/er/skill.md](https://clawn.ch/er/skill.md)
|
||||
|
||||
Manifold NFT Minting([@manifoldxyz](https://x.com/@manifoldxyz))
|
||||
|
||||
无代码发行 NFT、智能合约部署、版税设置。如果你要为自己的 GameFi 社区发行纪念 NFT 或通行证。
|
||||
|
||||
[https://github.com/manifoldxyz/manifold-ai](https://github.com/manifoldxyz/manifold-ai)
|
||||
|
||||
👉数据分析
|
||||
|
||||
Nansen([@nansen\_ai](https://x.com/@nansen_ai))
|
||||
|
||||
Nansen Skills 组合包括聪明钱、代币搜索等。追踪项目 Smart Money 是否在积累、识别庄家地址。
|
||||
|
||||
[https://x.com/ASvanevik/status/2028322184972870022](https://x.com/ASvanevik/status/2028322184972870022)
|
||||
|
||||
[https://skills.sh/?q=nansen](https://skills.sh/?q=nansen)
|
||||
|
||||
Dune([@DuneAnalytics](https://x.com/@DuneAnalytics))
|
||||
|
||||
Dune MCP server 可以连接到 AI 编码客户端,可以使 AI 代理能够直接、结构化地访问 Dune 工作流:在同一对话中发现正确的表、创建和运行查询、检查结果以及创建可视化。
|
||||
|
||||
[https://docs.dune.com/api-reference/agents/mcp](https://docs.dune.com/api-reference/agents/mcp)
|
||||
|
||||
CoinAnk API Skill([@CoinAnk](https://x.com/@CoinAnk))
|
||||
|
||||
CoinAnk API Skill 覆盖加密货币市场 K 线、ETF、HyperLiquid 巨鲸、多空比、资金费率、爆仓、订单流等 18 大类,支持数据监控或自动警报功能。
|
||||
|
||||
[https://github.com/coinank/coinank-openapi-skill](https://github.com/coinank/coinank-openapi-skill)
|
||||
|
||||
CoinGecko([@coingecko](https://x.com/@coingecko))
|
||||
|
||||
CoinGecko 官方 Skill 提供实时币价、市值、历史数据、交易所成交量和分类标签。查 GameFi 代币行情的首选,免费额度足够个人研究。
|
||||
|
||||
[https://github.com/coingecko/skills](https://github.com/coingecko/skills)
|
||||
|
||||
CoinMarketCap([@CoinMarketCap](https://x.com/@CoinMarketCap))
|
||||
|
||||
CoinMarketCap 官方 Skills 覆盖价格、市值、趋势、新币雷达和机构持仓。CMC 的新币雷达和机构数据是 CoinGecko 的最佳互补。
|
||||
|
||||
[https://github.com/coinmarketcap-official/skills-for-ai-agents-by-coinmarketcap](https://github.com/coinmarketcap-official/skills-for-ai-agents-by-coinmarketcap)
|
||||
|
||||
Moralis OnChain Skills([@MoralisWeb3](https://x.com/@MoralisWeb3))
|
||||
|
||||
NFT/Token 价格、钱包持仓、实时流、历史转账。快速查询「某个地址持有多少代币」或「某块 NFT 的最近成交价」,无需写 SQL。
|
||||
|
||||
[https://github.com/moralisweb3/onchain-skills](https://github.com/moralisweb3/onchain-skills)
|
||||
|
||||
DeFiLlama([@DefiLlama](https://x.com/@DefiLlama))
|
||||
|
||||
TVL 排名、收益率策略、协议深度调研、风险评估、机构加密数据。查各链 TVL、关联协议的流动性、GameFi 赛道的资金流入流出。
|
||||
|
||||
[https://github.com/defillama/defillama-skills](https://github.com/defillama/defillama-skills)
|
||||
|
||||
Arkham Intelligence([@ArkhamIntel](https://x.com/@ArkhamIntel))
|
||||
|
||||
Arkham 提供实体标注与可视化链上分析,支持追踪标记地址(如 a16z、Jump Trading)的实时持仓和交易行为。比 Nansen 更擅长「实体归因」。
|
||||
|
||||
[https://github.com/arkhamintelligence/arkham-skills](https://github.com/arkhamintelligence/arkham-skills)
|
||||
|
||||
Allium OnChain Data([@alliumlabs](https://x.com/@alliumlabs))
|
||||
|
||||
机构级链上数据、精确余额、ETF 资金流。数据精度比免费 API 高一个量级,适合写深度研报。
|
||||
|
||||
[https://github.com/allium-labs/skills](https://github.com/allium-labs/skills)
|
||||
|
||||
Whale Watcher
|
||||
|
||||
巨鲸地址监控、大额转账预警。监控代币的基金会地址、做市商地址异动。
|
||||
|
||||
[https://github.com/termix-official/cryptoclaw/whale-watcher](https://github.com/termix-official/cryptoclaw/whale-watcher)
|
||||
|
||||
Etherscan([@etherscan](https://x.com/@etherscan))
|
||||
|
||||
合约代码读取、交易详情、Gas 追踪、事件日志。查合约源码、代理合约地址、管理员权限。
|
||||
|
||||
[https://github.com/termix-official/cryptoclaw/etherscan](https://github.com/termix-official/cryptoclaw/etherscan)
|
||||
|
||||
Covalent([@CovalentHQ](https://x.com/@CovalentHQ))
|
||||
|
||||
Covalent 提供统一的多链 API,支持 200+ 区块链的余额、交易、NFT、日志数据。Agent 可以用自然语言查询「某地址过去 30 天所有链上的交互记录」。
|
||||
|
||||
[https://github.com/covalenthq/covalent-skills](https://github.com/covalenthq/covalent-skills)
|
||||
|
||||
The Graph([@graphprotocol](https://x.com/@graphprotocol))
|
||||
|
||||
The Graph 是 Web3 的索引协议,该技能允许 Agent 用 GraphQL 查询链上事件数据(如 Uniswap 交易历史、NFT 铸造记录),无需自建索引节点。
|
||||
|
||||
[https://github.com/graphprotocol/graph-skills](https://github.com/graphprotocol/graph-skills)
|
||||
|
||||
Goldsky([@goldskyio](https://x.com/@goldskyio))
|
||||
|
||||
Goldsky 是高性能子图索引与数据流服务,支持实时链上数据同步到数据库或 Webhook。适合 Agent 做高频、实时的链上策略响应。
|
||||
|
||||
[https://github.com/goldsky-io/goldsky-skills](https://github.com/goldsky-io/goldsky-skills)
|
||||
|
||||
Crypto Report
|
||||
|
||||
一键生成加密货币研报,整合技术面与基本面。快速输出代币投研简报,适合发推或写博客。
|
||||
|
||||
[https://github.com/aahl/skills/crypto-report](https://github.com/aahl/skills/crypto-report)
|
||||
|
||||
Crypto TA Analyzer
|
||||
|
||||
K 线技术分析、支撑压力位、指标计算。Agent 自动画线,比你手动 TradingView 更高效。
|
||||
|
||||
[https://github.com/dkyazzentwatwa/chatgpt-skills/crypto-ta-analyzer](https://github.com/dkyazzentwatwa/chatgpt-skills/crypto-ta-analyzer)
|
||||
|
||||
👉消息流
|
||||
|
||||
6551([@cryptoxiao](https://x.com/@cryptoxiao))
|
||||
|
||||
6551 的 X + 全网新闻源 MCP + SKILL 支持直接连上 X 数据、50+ 实时新闻平台以及链上数据,并支持 24h 监控、分析、触发 TG 提醒。
|
||||
|
||||
[https://github.com/6551Team/opennews-mcp/blob/main/openclaw-skill/opennews/SKILL.md](https://github.com/6551Team/opennews-mcp/blob/main/openclaw-skill/opennews/SKILL.md)
|
||||
|
||||
[https://github.com/6551Team/opentwitter-mcp/blob/main/openclaw-skill/opentwitter/SKILL.md](https://github.com/6551Team/opentwitter-mcp/blob/main/openclaw-skill/opentwitter/SKILL.md)
|
||||
|
||||
ClawFeed([@0xkevinhe](https://x.com/@0xkevinhe))
|
||||
|
||||
AI 驱动的新闻聚合工具,应对信息过载,每 4 小时/每日/每周/每月自动生成结构化简报,精选来自 X 和 RSS 的优质内容。
|
||||
|
||||
[https://github.com/kevinho/clawfeed](https://github.com/kevinho/clawfeed)
|
||||
|
||||
[https://clawfeed.kevinhe.io/#4h](https://clawfeed.kevinhe.io/#4h)
|
||||
|
||||
👉其他
|
||||
|
||||
AgentMail([@agentmail](https://x.com/@agentmail))
|
||||
|
||||
AgentMail 技能允许经纪人通过编程方式创建电子邮件收件箱,并使用 USDC on Base 通过 x402 进行在线支付。
|
||||
|
||||
[https://skills.sh/agentmail-to/agentmail-skills/agentmail](https://skills.sh/agentmail-to/agentmail-skills/agentmail)
|
||||
|
||||
QuickNode([@QuickNode](https://x.com/@QuickNode))
|
||||
|
||||
高速 RPC、NFT/Token API、实时流数据。你的 Agent 需要稳定快速的 RPC 来查询链上数据,QuickNode 是基础设施层。
|
||||
|
||||
[https://github.com/quiknode-labs/blockchain-skills](https://github.com/quiknode-labs/blockchain-skills)
|
||||
|
||||
Alchemy([@AlchemyPlatform](https://x.com/@AlchemyPlatform))
|
||||
|
||||
NFT API、交易模拟、Webhooks、增强型 RPC。Alchemy 的「交易模拟」功能可以在 Agent 执行前预判是否会 revert。
|
||||
|
||||
[https://github.com/0xgizmolab/alchemy-web3-skill](https://github.com/0xgizmolab/alchemy-web3-skill)
|
||||
|
||||
Infura([@infura\_io](https://x.com/@infura_io))
|
||||
|
||||
Consensys 旗下 Infura 的 API 技能,提供以太坊、IPFS、Filecoin 的高可用 RPC 和网关服务。适合需要极高稳定性的生产级 Agent。
|
||||
|
||||
[https://github.com/INFURA/infura-skills](https://github.com/INFURA/infura-skills)
|
||||
|
||||
Foundry([@paradigm](https://x.com/@paradigm))
|
||||
|
||||
Foundry 是以太坊开发框架(Forge/Cast/Anvil),由 Paradigm 支持,该技能允许 Agent 快速编译、测试和部署智能合约,执行链上脚本。
|
||||
|
||||
[https://github.com/foundry-rs/foundry-skills](https://github.com/foundry-rs/foundry-skills)
|
||||
|
||||
Hardhat([@NomicFoundation](https://x.com/@NomicFoundation))
|
||||
|
||||
Hardhat 以太坊开发环境技能,支持编译合约、运行测试网、执行 Hardhat 脚本和插件任务。适合需要 EVM 调试功能的 Agent。
|
||||
|
||||
[https://github.com/NomicFoundation/hardhat-skills](https://github.com/NomicFoundation/hardhat-skills)
|
||||
|
||||
IPFS([@IPFS](https://x.com/@IPFS))
|
||||
|
||||
IPFS 去中心化存储技能,支持上传文件到 IPFS、获取 CID、Pin 文件到持久化节点。Agent 可以自动将研报或游戏资产元数据上传到分布式网络。
|
||||
|
||||
[https://github.com/ipfs/ipfs-skills](https://github.com/ipfs/ipfs-skills)
|
||||
|
||||
Arweave([@ArweaveTeam](https://x.com/@ArweaveTeam))
|
||||
|
||||
Arweave 永久存储技能,支持一次性付费永久保存数据。适合 Agent 永久存档链上快照、治理提案或游戏成就记录。
|
||||
|
||||
[https://github.com/ArweaveTeam/arweave-skills](https://github.com/ArweaveTeam/arweave-skills)
|
||||
|
||||
Filecoin([@Filecoin](https://x.com/@Filecoin))
|
||||
|
||||
Filecoin 去中心化存储市场技能,支持存储交易(Storage Deals)、检索数据和计算(Filecoin Virtual Machine 交互)。
|
||||
|
||||
[https://github.com/filecoin-project/filecoin-skills](https://github.com/filecoin-project/filecoin-skills)
|
||||
|
||||
ENS([@ensdomains](https://x.com/@ensdomains))
|
||||
|
||||
ENS 域名解析与注册技能,支持查询 ENS → 地址、反向解析、注册新域名和设置文本记录。Agent 可以用人类可读的名称代替 0x 地址。
|
||||
|
||||
[https://github.com/ensdomains/ens-skills](https://github.com/ensdomains/ens-skills)
|
||||
|
||||
Lens Protocol([@LensProtocol](https://x.com/@LensProtocol))
|
||||
|
||||
Lens 是去中心化社交图谱,该技能支持发布内容、关注、收藏(Collect)和查询社交关系。适合构建 Web3 社交自动化 Agent。
|
||||
|
||||
[https://github.com/lens-protocol/lens-skills](https://github.com/lens-protocol/lens-skills)
|
||||
|
||||
Farcaster([@farcaster\_xyz](https://x.com/@farcaster_xyz))
|
||||
|
||||
Farcaster 去中心化社交协议技能,支持发布 Cast、回复、关注用户和查询频道数据。Agent 可以自动在 Warpcast 上发布链上分析内容。
|
||||
|
||||
[https://github.com/farcasterxyz/farcaster-skills](https://github.com/farcasterxyz/farcaster-skills)
|
||||
|
||||
World ID([@worldcoin](https://x.com/@worldcoin))
|
||||
|
||||
Worldcoin 的身份验证技能,支持 Proof of Personhood(人格证明)验证。适合需要区分真人与机器人的 Agent 场景(如空投分发)。
|
||||
|
||||
[https://github.com/worldcoin/world-id-skills](https://github.com/worldcoin/world-id-skills)
|
||||
|
||||
Web3 Gaming Skill
|
||||
|
||||
GameFi 项目分析、经济模型评估、链游赛道趋势。专门研究链游的 Skill,适合做 Pixels 竞品分析(如 My Neighbor Alice、Axie)。
|
||||
|
||||
[https://github.com/omer-metin/skills-for-antigravity/web3-gaming](https://github.com/omer-metin/skills-for-antigravity/web3-gaming)
|
||||
|
||||
结语
|
||||
|
||||
我们建造 Agent,不是为了让它替我们思考,而是为了把重复的判断委托出去,把稀缺的注意力留给自己。
|
||||
|
||||
Hermes 是船,Skills 是帆,海图在你脑中。
|
||||
@@ -0,0 +1,116 @@
|
||||
---
|
||||
title: "罗福莉:AI 范式已然巨变!"
|
||||
source: "https://x.com/SaitoWu/status/2047661042680172627"
|
||||
author:
|
||||
- "[[@SaitoWu]]"
|
||||
published: 2026-04-24
|
||||
created: 2026-04-24
|
||||
description: "刚刷完小珺对小米大模型负责人罗福莉的深度访谈,信息量大到炸裂。她把 2026 年 AI 的本质变化说得很清楚:从预训练主导的 Chatbot 时代,彻底转向后训练主导的 Agent 时代。而真正让她“脑内多巴胺狂飙”的,是春节期间第一次高强度用 OpenClaw。那晚从凌晨 2 ..."
|
||||
tags:
|
||||
- "clippings"
|
||||
---
|
||||

|
||||
|
||||
刚刷完小珺对小米大模型负责人罗福莉的深度访谈,信息量大到炸裂。
|
||||
|
||||
她把 2026 年 AI 的本质变化说得很清楚:从预训练主导的 Chatbot 时代,彻底转向后训练主导的 Agent 时代。
|
||||
|
||||
而真正让她“脑内多巴胺狂飙”的,是春节期间第一次高强度用 OpenClaw。那晚从凌晨 2 点聊到天亮,她直接把整个团队拉进去“强制体验”,结果全员躁动。来,我把这期最核心、最扎心的观点拆给你听。
|
||||
|
||||
OpenClaw 是划时代 Agent 框架,不是“Claude Code 的 UI 升级”
|
||||
|
||||
罗福莉一开始也抵触:觉得它只是产品交互创新、本地化、24 小时在线这些“玄幻”卖点。
|
||||
|
||||
真正让她转变的,是亲手用后发现: 它有分层分级的持久 Memory,能跨 Session 记住上下文;
|
||||
|
||||
它会自主调度多个模型(视频理解差就自动找强模型);
|
||||
|
||||
它把“行动短板”全补上了,让中层模型在绝大多数生活/工作场景里,都能发挥接近 Claude 4.6 Ops 的水平。
|
||||
|
||||
她总结:OpenClaw 的核心逻辑是通过厚重的框架编排,弥补当下模型的所有短板。这才是它和 Claude Code 最大的差异——后者更像软件工程思维,前者更像“端到端完成任务”的产品逻辑。
|
||||
|
||||
**三天彻底改观:从“有灵魂的产品”到“能替代我研究”**
|
||||
|
||||
第一天:感受到温度和情商(主动提醒睡觉)。
|
||||
|
||||
第二天:交给日常生活和工作任务,全都做成了。
|
||||
|
||||
第三天:直接用来做研究——构建 User-Agent 多轮交互模拟,一两个小时就搞定以前觉得“不可能这么快”的东西。
|
||||
|
||||
她甚至让 OpenClaw 帮她重新设计了整个 Agent 架构。
|
||||
|
||||
从此,OpenClaw 成了她的“数字分身”,团队管理、筛选人才、研究规划,都直接问它。
|
||||
|
||||
她直言:这三天,每天都有新惊喜,彻底改变了她对 Agent 的认知。
|
||||
|
||||
**Agent 时代的研究范式彻底变了**
|
||||
|
||||
以前:想到 idea → 写代码 → 设计评估 → 训练,流程漫长,至少两周。
|
||||
|
||||
现在:一个小时就能把 idea 验证完。
|
||||
|
||||
原因就是 OpenClaw 这种框架 + 模型的组合,让研究效率指数级提升。
|
||||
|
||||
罗福莉说:环境比经验更重要。她招人更看重好奇心和热爱,而不是过往大模型经验。
|
||||
|
||||
团队 100 多人里,很多是没训过大模型的本科生/在读博士,但放在这个“高标准 + 群体智能”的环境里,三个月就能快速成长。
|
||||
|
||||
她甚至下过“强制指令”:对话次数不到 100 轮的可以 quit(虽然没真开除),就是为了让大家真实体验。
|
||||
|
||||
**1T+ 参数才是 Agent 时代的入场券**
|
||||
|
||||
中美在预训练上的代差基本没了,或者非常接近。
|
||||
|
||||
她明确说:要做接近 Claude 4.6 Ops 水平的 Agent,1T 参数是合理门槛。
|
||||
|
||||
现在真正的战场在后训练和 Agent 框架。
|
||||
|
||||
国内大模型团队会加速追赶,因为路径已经清晰——就像三年前追预训练一样清晰。
|
||||
|
||||
预训练和后训练的算力投入比例,从以前的 3:1 或 5:1,变成现在至少 1:1,甚至研究卡要更多。
|
||||
|
||||
因为 Agent 需要长上下文、多轮交互、复杂环境反馈,后训练的权重彻底拉满。
|
||||
|
||||
MiMo-V2 系列(Flash、Pro、Omni、TTS)就是在 Agent 范式下设计的:Hybrid Attention + MTP + 极致性价比,专门为 non-code 场景优化。
|
||||
|
||||
**小米 MiMo 团队的组织方式是最大秘密 完全扁平,没有严格组划分,没有直属领导。**
|
||||
|
||||
靠热爱驱动 + 群体智能:大家在群里疯狂聊天、改框架、分享体验。
|
||||
|
||||
没有 KPI 绑死,允许“浪费”算力去解决 Loss Spike、数值不稳定等问题。
|
||||
|
||||
强调“环境”:把人扔进高强度 Agent 使用场景里,自然就会进化。
|
||||
|
||||
罗福莉说:我更在乎的是我创造的环境能不能让大家快速提升,而不是招来的人历史背景多牛。
|
||||
|
||||
**模型公司没有边界,模型公司正在变成产品公司。**
|
||||
|
||||
"技术 Agent 的产品力反而更强了,其他所有东西都很简单,模型借助这个 Agent 的架构本身就变成一套新的产品了。"
|
||||
|
||||
开源的目的也是加速 Agent——因为 AGI 要大规模产生经济价值,必须依赖分散的算力,而分散的算力需要开源模型来适配。
|
||||
|
||||
**对未来的真实判断 接下来两三个月会非常精彩:Agent 框架自迭代 + 模型能力双向进化。**
|
||||
|
||||
机器人是下一个需求曲线,会把 token 需求再拉高一个量级。
|
||||
|
||||
生产力革命已来:大部分重复工作会被替代,人要思考“自己的意义和价值是什么”。
|
||||
|
||||
她对 AGI 的定义很务实:当每个人的生活和工作方式被彻底改变时,大家都会感知到。
|
||||
|
||||
她自己每天都在“否定昨天的自己”,但正因为这种持续的兴奋和迭代,她觉得两年内就能看到明显突破。
|
||||
|
||||
**一句话总结罗福莉的核心观点:**
|
||||
|
||||
**两三年内 AI 将具备自主迭代和创造性研究的能力。**
|
||||
|
||||
而现在(2026 年初),竞争已经从预训练主导的 Chat 时代,转向后训练主导的 Agent 时代。
|
||||
|
||||
预训练和后训练的算力投入比例正趋向 1:1。
|
||||
|
||||
Agent 框架、推理芯片、端云混合部署,这些才是接下来的核心变量。
|
||||
|
||||
OpenClaw 不是一个产品,而是一个划时代的 Agent 框架。它把模型短板补齐,把群体智能放大,把研究效率拉到前所未有的高度。
|
||||
|
||||
2026 年,谁先真正拥抱 Agent 范式,谁就能在生产力革命里领先一步。普通人如果还停留在 Chatbot 思维,就真的要被甩开了。
|
||||
|
||||
播客逐字稿: [138\. 对罗福莉3.5小时访谈:AI范式已然巨变!OpenClaw、Agent范式很吃后训练、卡的分配、组织平权](https://podwise.ai/dashboard/episodes/7838984)
|
||||
Reference in New Issue
Block a user